
朴素贝叶斯算法的python实现
朴素贝叶斯
算法优缺点
优点:在数据较少的情况下依然有效,可以处理多类别问题
缺点:对输入数据的准备方式敏感
适用数据类型:标称型数据
算法思想:
朴素贝叶斯
比如我们想判断一个邮件是不是垃圾邮件,那么我们知道的是这个邮件中的词的分布,那么我们还要知道:垃圾邮件中某些词的出现是多少,就可以利用贝叶斯定理得到。
朴素贝叶斯分类器中的一个假设是:每个特征同等重要
函数
loadDataSet()
创建数据集,这里的数据集是已经拆分好的单词组成的句子,表示的是某论坛的用户评论,标签1表示这个是骂人的
createVocabList(dataSet)
找出这些句子中总共有多少单词,以确定我们词向量的大小
setOfWords2Vec(vocabList, inputSet)
将句子根据其中的单词转成向量,这里用的是伯努利模型,即只考虑这个单词是否存在
bagOfWords2VecMN(vocabList, inputSet)
这个是将句子转成向量的另一种模型,多项式模型,考虑某个词的出现次数
trainNB0(trainMatrix,trainCatergory)
计算P(i)和P(w[i]|C[1])和P(w[i]|C[0]),这里有两个技巧,一个是开始的分子分母没有全部初始化为0是为了防止其中一个的概率为0导致整体为0,另一个是后面乘用对数防止因为精度问题结果为0
classifyNB(vec2Classify, p0Vec, p1Vec, pClass1)
根据贝叶斯公式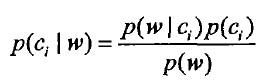 计算这个向量属于两个集合中哪个的概率高
 #coding=utf-8

 from numpy import *

 def loadDataSet():

     postingList=[['my', 'dog', 'has', 'flea', 'problems', 'help', 'please'],

                  ['maybe', 'not', 'take', 'him', 'to', 'dog', 'park', 'stupid'],

                  ['my', 'dalmation', 'is', 'so', 'cute', 'I', 'love', 'him'],

                  ['stop', 'posting', 'stupid', 'worthless', 'garbage'],

                  ['mr', 'licks', 'ate', 'my', 'steak', 'how', 'to', 'stop', 'him'],

                  ['quit', 'buying', 'worthless', 'dog', 'food', 'stupid']]

     classVec = [0,1,0,1,0,1]    #1 is abusive, 0 not

     return postingList,classVec

 #创建一个带有所有单词的列表

 def createVocabList(dataSet):

     vocabSet = set([])

     for document in dataSet:

         vocabSet = vocabSet | set(document)

     return list(vocabSet)

 def setOfWords2Vec(vocabList, inputSet):

     retVocabList = [0] * len(vocabList)

     for word in inputSet:

         if word in vocabList:

             retVocabList[vocabList.index(word)] = 1

         else:

             print 'word ',word ,'not in dict'

     return retVocabList

 #另一种模型

 def bagOfWords2VecMN(vocabList, inputSet):

     returnVec = [0]*len(vocabList)

     for word in inputSet:

         if word in vocabList:

             returnVec[vocabList.index(word)] += 1

     return returnVec

 def trainNB0(trainMatrix,trainCatergory):

     numTrainDoc = len(trainMatrix)

     numWords = len(trainMatrix[0])

     pAbusive = sum(trainCatergory)/float(numTrainDoc)

     #防止多个概率的成绩当中的一个为0

     p0Num = ones(numWords)

     p1Num = ones(numWords)

     p0Denom = 2.0

     p1Denom = 2.0

     for i in range(numTrainDoc):

         if trainCatergory[i] == 1:

             p1Num +=trainMatrix[i]

             p1Denom += sum(trainMatrix[i])

         else:

             p0Num +=trainMatrix[i]

             p0Denom += sum(trainMatrix[i])

     p1Vect = log(p1Num/p1Denom)#处于精度的考虑,否则很可能到限归零

     p0Vect = log(p0Num/p0Denom)

     return p0Vect,p1Vect,pAbusive

 def classifyNB(vec2Classify, p0Vec, p1Vec, pClass1):

     p1 = sum(vec2Classify * p1Vec) + log(pClass1)    #element-wise mult

     p0 = sum(vec2Classify * p0Vec) + log(1.0 - pClass1)

     if p1 > p0:

         return 1

     else:

         return 0

 def testingNB():

     listOPosts,listClasses = loadDataSet()

     myVocabList = createVocabList(listOPosts)

     trainMat=[]

     for postinDoc in listOPosts:

         trainMat.append(setOfWords2Vec(myVocabList, postinDoc))

     p0V,p1V,pAb = trainNB0(array(trainMat),array(listClasses))

     testEntry = ['love', 'my', 'dalmation']

     thisDoc = array(setOfWords2Vec(myVocabList, testEntry))

     print testEntry,'classified as: ',classifyNB(thisDoc,p0V,p1V,pAb)

     testEntry = ['stupid', 'garbage']

     thisDoc = array(setOfWords2Vec(myVocabList, testEntry))

     print testEntry,'classified as: ',classifyNB(thisDoc,p0V,p1V,pAb)

 def main():

     testingNB()

 if __name__ == '__main__':

     main()
机器学习笔记索引
朴素贝叶斯算法的python实现的更多相关文章
- 朴素贝叶斯算法的python实现方法
朴素贝叶斯算法的python实现方法 本文实例讲述了朴素贝叶斯算法的python实现方法.分享给大家供大家参考.具体实现方法如下: 朴素贝叶斯算法优缺点 优点:在数据较少的情况下依然有效,可以处理多类 ...
- 朴素贝叶斯算法的python实现-乾颐堂
算法优缺点 优点:在数据较少的情况下依然有效,可以处理多类别问题 缺点:对输入数据的准备方式敏感 适用数据类型:标称型数据 算法思想: 朴素贝叶斯 比如我们想判断一个邮件是不是垃圾邮件,那么我们知道的 ...
- 朴素贝叶斯算法的python实现 -- 机器学习实战
import numpy as np import re #词表到向量的转换函数 def loadDataSet(): postingList = [['my', 'dog', 'has', 'fle ...
- 朴素贝叶斯算法--python实现
朴素贝叶斯算法要理解一下基础: [朴素:特征条件独立 贝叶斯:基于贝叶斯定理] 1朴素贝叶斯的概念[联合概率分布.先验概率.条件概率**.全概率公式][条件独立性假设.] 极大似然估计 ...
- 朴素贝叶斯算法原理及Spark MLlib实例(Scala/Java/Python)
朴素贝叶斯 算法介绍: 朴素贝叶斯法是基于贝叶斯定理与特征条件独立假设的分类方法. 朴素贝叶斯的思想基础是这样的:对于给出的待分类项,求解在此项出现的条件下各个类别出现的概率,在没有其它可用信息下,我 ...
- 机器学习:python中如何使用朴素贝叶斯算法
这里再重复一下标题为什么是"使用"而不是"实现": 首先,专业人士提供的算法比我们自己写的算法无论是效率还是正确率上都要高. 其次,对于数学不好的人来说,为了实 ...
- Python机器学习笔记:朴素贝叶斯算法
朴素贝叶斯是经典的机器学习算法之一,也是为数不多的基于概率论的分类算法.对于大多数的分类算法,在所有的机器学习分类算法中,朴素贝叶斯和其他绝大多数的分类算法都不同.比如决策树,KNN,逻辑回归,支持向 ...
- Python机器学习算法 — 朴素贝叶斯算法(Naive Bayes)
朴素贝叶斯算法 -- 简介 朴素贝叶斯法是基于贝叶斯定理与特征条件独立假设的分类方法.最为广泛的两种分类模型是决策树模型(Decision Tree Model)和朴素贝叶斯模型(Naive Baye ...
- 机器学习---用python实现朴素贝叶斯算法(Machine Learning Naive Bayes Algorithm Application)
在<机器学习---朴素贝叶斯分类器(Machine Learning Naive Bayes Classifier)>一文中,我们介绍了朴素贝叶斯分类器的原理.现在,让我们来实践一下. 在 ...
随机推荐
- Matplotlib 学习笔记
注:该文是上了开智学堂数据科学基础班的课后做的笔记,主讲人是肖凯老师. 数据绘图 数据可视化的原则 为什么要做数据可视化? 为什么要做数据可视化?因为可视化后获取信息的效率高.为什么可视化后获取信息的 ...
- bzoj2083【Poi2010】Intelligence test
听说正解是链表,然而被我暴力水过了 先开vector记录每个数在原串中出现的位置 之后对于每个匹配串的每一位,找比当前位置大的第一个当前元素是哪个,有就更新,没有就"NIE" #i ...
- iOS苹果推送功能实现步骤
1.在钥匙串里 导出推送证书Apple Push notification Services 的 certificate, 命名为cer.p12,放在电脑桌面 ,期间密码设为123456 2.在钥匙串 ...
- Protobuf for Python测试保存和读取文件
安装pip, setuptools, and wheel 如果已经从python.org,安装啦Python 2 >=2.7.9 or Python 3 >=3.4 ,那么就已经有啦pip ...
- SDL 1.2.15 issue
SDL 1.2.15中,对于X11的函数,默认采用动态加载的方式 但相应的X11函数名在SDL中并没有重新命名(SDL2中都添加了前缀X11_) 这样在SDL与其他库混合静态编译链接时,X11的函数就 ...
- mysql5.7导入csv文件
环境: Windows10企业版X64 mysql5.7免安装版(从5.6版本开始,官方不再提供64位的msi版本) 运行mysqld.exe启动mysql进程. 用root登录mysql: mysq ...
- sql中的!=判断的注意事项
sql查询中where过滤条件为某字段 colName='xx'时一般不会出什么问题, 但如果想达到不为xx的时候就要注意了,用colName!= 'xx'可能就有问题了,因为该字段可能为空,为nul ...
- 错误 Metadata file 'C:\Common\bin\Debug\Common.dll' could not be found
一个通用方法de类库/总是报这个错误/很明显就是没有成功生成程序集... 但是就是找不到哪里的错误!!!! 如果是代码写错的话,可能会直接提示在哪个文件中哪行代码写错了,然后dll生成不了,但是这个错 ...
- 5、Servlet的使用
一.什么是Servlet:用于开发动态Web资源的的技术.使用Servlet可以读取来自用户端的数据,而实现了用户与服务器之间的动态数据交互.更简单的说就是连接页面和代码. 1.开发一个动态的Web资 ...
- 2012 Multi-University Training Contest 9 / hdu4389
2012 Multi-University Training Contest 9 / hdu4389 打巨表,实为数位dp 还不太懂 先这样放着.. 对于打表,当然我们不能直接打,这里有技巧.我们可以 ...