本人的开发环境:
1.虚拟机centos 6.5
2.jdk 1.8
3.spark2.2.0
4.scala 2.11.8
5.maven 3.5.2
在开发和搭环境时必须注意版本兼容的问题,不然会出现很多莫名其妙的问题
1.启动spark master
2.启动worker
./bin/spark-class org.apache.spark.deploy.worker.Worker spark://master:7077
步骤1,2是必须在启动任务之前的。注意worker必须和flume的agent在同一节点,我这里是一台服务器调试,所以直接在同一台机器调试,相当于在一个端口A流出数据(telnet实现),获取数据并流入到同一IP的另一个端口B(flume实现),监听端口B数据并流式处理(Spark Streaming),写入数据库(mysql)。
3.spark streaming代码开发,flume push方式
package com.spark
import java.sql.DriverManager
import com.spark.ForeachRDDApp.createConnection
import org.apache.spark.SparkConf
import org.apache.spark.streaming.flume.FlumeUtils
import org.apache.spark.streaming.{Seconds, StreamingContext}
object FlumePushSparkStreaming {
def main(args: Array[String]): Unit = {
if( args.length != 2 ) {
System.out.print("Usage:flumepushworkCount <hostname> <port>")
System.exit(1)
}
val Array(hostname, port) = args
val sparkConf = new SparkConf()
val ssc = new StreamingContext(sparkConf, Seconds(5))
val flumeStream = FlumeUtils.createStream(ssc, hostname, port.toInt)
val result = flumeStream.map(x => new String(x.event.getBody.array()).trim)
.flatMap(_.split(" ")).map((_,1)).reduceByKey(_+_)
result.print()
result.foreachRDD(rdd => { //注意1
rdd.foreachPartition(partitionOfRecords => {
val connection = createConnection()
partitionOfRecords.foreach(record => {
val sql = "insert into FlumeWordCount(word, wordcount) values('" + record._1 + "'," + record._2 + ")"
connection.createStatement().execute(sql)
})
connection.close()
})
})
ssc.start()
ssc.awaitTermination()
}
/**
* 获取MySQL的连接
*/
def createConnection() = {
Class.forName("com.mysql.jdbc.Driver")
DriverManager.getConnection("jdbc:mysql://master:3306/imooc_spark", "root", "root")
}
}
代码很容易理解,在这就不解析了。不过程序还是不够好,还有优化的地方。请看注意1,优化地方:1.使用线程池的方法来连接mysql。2.Spqrk的闭包原理,在集群中,RDD传给执行器的只是副本,一个RDD并不是全部的数据,然而这里写进mysql数据正确是因为在同一个节点调试,所有的RDD只在本机器操作,因此数据都可以写进mysql。如果在集群中,可能结果是不一样的。解决办法:使用collect( )。
4.flume配置
flume_sparkstreaming_mysql.sources = netcat-source
flume_sparkstreaming_mysql.sinks = avro-sink
flume_sparkstreaming_mysql.channels = memory-channel
flume_sparkstreaming_mysql.sources.netcat-source.type = netcat
flume_sparkstreaming_mysql.sources.netcat-source.bind = master
flume_sparkstreaming_mysql.sources.netcat-source.port = 44444
flume_sparkstreaming_mysql.sinks.avro-sink.type = avro
flume_sparkstreaming_mysql.sinks.avro-sink.hostname = master
flume_sparkstreaming_mysql.sinks.avro-sink.port = 41414
flume_sparkstreaming_mysql.channels.memory-channel.type = memory
flume_sparkstreaming_mysql.sources.netcat-source.channels = memory-channel
flume_sparkstreaming_mysql.sinks.avro-sink.channel = memory-channel
flume的配置也很简单,需要注意的是这里是在服务器跑的, 注意黑体的地方,要写服务器的IP地址,而不是本地调试的那个IP。
3.打jar包并提交任务
./spark-submit --class com.spark.FlumePushSparkStreaming --master local[2] --packages org.apache.spark:spark-streaming-flume_2.11:2.2.0 /home/hadoop/tmp/spark.jar master 41414
4.启动flume-push方式
./flume-ng agent --name simple-agent --conf $FLUME_HOME/conf --conf-file $FLUME_HOME/conf/flume_push_streaming.conf -Dflume.root.logger=INFO,consol
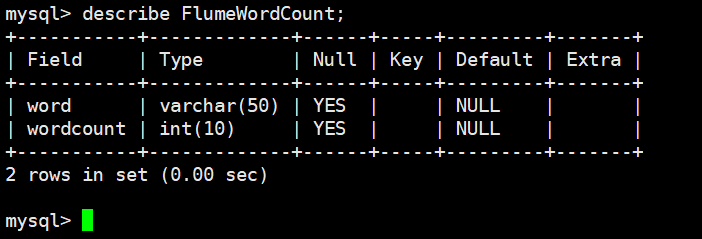
5.建表
create table FlumeWordCount(
word varchar(50) default null,
wordcount int(10) default null
);
6.监听 master : 44444
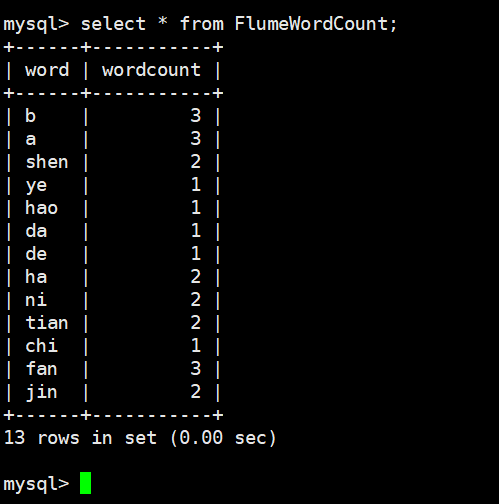
7.mysql 查看数据
mysql> select * from FlumeWordCount;
8.终端打印

- [原创]mybatis中整合ehcache缓存框架的使用
mybatis整合ehcache缓存框架的使用 mybaits的二级缓存是mapper范围级别,除了在SqlMapConfig.xml设置二级缓存的总开关,还要在具体的mapper.xml中开启二级缓 ...
- kindeditor4整合SyntaxHighlighter,让代码亮起来
这一篇我将介绍如何让kindeditor4.x整合SyntaxHighlighter代码高亮,因为SyntaxHighlighter的应用非常广泛,所以将kindeditor默认的prettify替换 ...
- spring源码分析之freemarker整合
FreeMarker是一款模板引擎: 即一种基于模板和要改变的数据, 并用来生成输出文本(HTML网页.电子邮件.配置文件.源代码等)的通用工具. 它不是面向最终用户的,而是一个Java类库,是一款程 ...
- FullCalendar应用——整合农历节气和节日
FullCalendar用来做日程管理功能非常强大,但是唯一不足的地方是没有将中国农历历法加进去,今天我将结合实例和大家分享如何将中国农历中的节气和节日整合到FullCalendar中,从而增强其实用 ...
- SAP CRM 将组件整合至导航栏中
到现在,我们已经可以让组件独立地显示.我们只是运行它.让它显示在Web UI中.让我们把组件整合进导航栏,使我们可以在正常登录Web UI时访问它. 步骤一: 为你的UI组件主窗体创建一个内向插件. ...
- Atitit.你这些项目不都是模板吗?不是原创 集成和整合的方式大总结
Atitit.你这些项目不都是模板吗?不是原创 集成和整合的方式大总结 1.1. 乔布斯的名言:创新即整合(Creativity is just connecting things).1 1.2. ...
- github入门到上传本地项目【网上资源整合】
[在原文章的基础上,修改了描述的不够详细的地方,对内容进行了扩充,整合了网上的一些资料] [内容主要来自http://www.cnblogs.com/specter45/p/github.html#g ...
- 三大框架SSH整合
三大框架SSH整合 -------------------------------Spring整合Hibernate------------------------------- 一.为什么要整合Hi ...
- SSH框架整合(代码加文字解释)
一.创建数据库并设置编码. A) create database oa default character set utf8. 二.MyEclipse工程 A) 在Myeclipse里创建web工程, ...
随机推荐
- [原创]20行ruby代码实现依赖注入框架
我需要依赖注入 业余时间开发的娱乐项目 (为了练习使用ruby语言) 遵循SRP原则,业务逻辑拆分由各个service类型提供,假设存在如下几个类型 GameService 封装主要游戏业务逻辑 Us ...
- ___pInvalidArgHandler already defined in LIBCMTD.lib(invarg.obj)
vs2013编译项目时出错,网上很多的解决方案全都是垃圾,根本不能用 不过也有不是垃圾的,就是下面这个: 关于采用静态链接编译生成EXE库函数重复定义问题 看了好多关于类似LIBCMT.lib(inv ...
- mysql如何进行以=分割的字符串的拆分
SUBSTRING_INDEX(str, delim, count) str: 要处理的字符串 delim: 分割符 count: 计数 如果为正数,则从左开始数,如果为负数,则从右开始数 使用示例: ...
- 值得一做》关于数学与递推 BZOJ1002 (BZOJ第一页计划)(normal+)
什么都不说先甩题目 Description 轮状病毒有很多变种,所有轮状病毒的变种都是从一个轮状基产生的.一个N轮状基由圆环上N个不同的基原子和圆心处一个核原子构成的,2个原子之间的边表示这2个原子之 ...
- Linux 搭建NFS文件服务器实现文件共享
我们接着玩Linux,O(∩_∩)O哈哈~ 1.什么是nfs NFS(Network File System)即网络文件系统,是FreeBSD支持的文件系统中的一种,它允许网络中的计算机之间通过TCP ...
- cocos+kbe问题记录
1.不要使用setTimeout函数 setTimeout函数,setTimeout() 方法用于在指定的毫秒数后调用函数或计算表达式. 是HTML DOM中的方法,在游戏中使用,属于全局的延时,当游 ...
- Ionic01 简单介绍、环境搭建、创建项目、项目结构、创建组件、创建页面、子页面跳转
1 Ionic 基本介绍 Ionic 是一款基于 Angular.Cordova 的强大的 HTML5 移动应用开发框架 , 可以快速创建一个跨平台的移动应用.可以快速开发移动 App.移动端 WEB ...
- Ubuntu18.04创建新的系统用户
目标: 1.为测试学习Docker,在虚拟机OS为18.04里,创建一个系统账号,账号名称:docker 2.在/home下有新建username的文件夹 一.建立账号 1.以root账号登录 2.u ...
- Mac notes
1. Mac应用数据存放位置 ~/Library/Application Support/ 比如sublime text的应用数据~/Library/Application Support/Subli ...
- 新浪SAE高级开发者认证通过
如题,新浪SAE高级开发者认证通过,申请的方式为提交开源项目地址,用的是如下的项目 http://jqext.sinaapp.com/ 之前该项目是部署在 mopaas 上的,在拿到高级开发者资格后迁 ...