
基于apache —HttpClient的小爬虫获取网页内容
今天(17-03-31)忙了一下午研究webmagic,发现自己还太年轻,对于这样难度的框架(类库)
还是难以接受,还是从基础开始吧,因为相对基础的东西教程相多一些,于是乎我找了apache其下的
HttpClient,根据前辈们发的教程自己也简单写了一下,感觉还好。
下面实现的是单个页面的获取:
import org.apache.http.HttpEntity;

import org.apache.http.HttpResponse;

import org.apache.http.client.HttpClient;

import org.apache.http.client.methods.HttpGet;

import org.apache.http.impl.client.HttpClients;

import org.apache.http.util.EntityUtils;

import java.io.IOException;

public class Main {

    public static void main(String[] args) throws IOException{

        try {

            //创建client实例

            HttpClient client= HttpClients.createDefault();

            //创建httpget实例

            HttpGet httpGet=new HttpGet("http://www.btba.com.cn");

            //执行 get请求

            HttpResponse response=client.execute(httpGet);

            //返回获取实体

            HttpEntity entity=response.getEntity();

            //获取网页内容,指定编码

            String web= EntityUtils.toString(entity,"UTF-8");

            //输出网页

            System.out.println(web);

        } catch (IOException e) {

            e.printStackTrace();

        }

    }

}
部分截图展示:
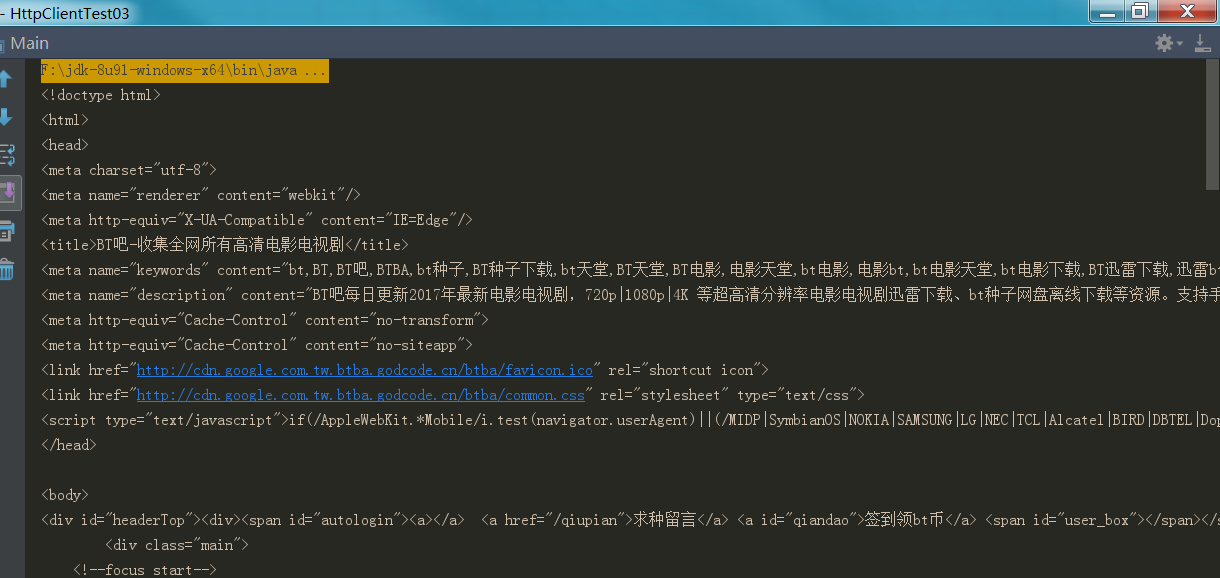
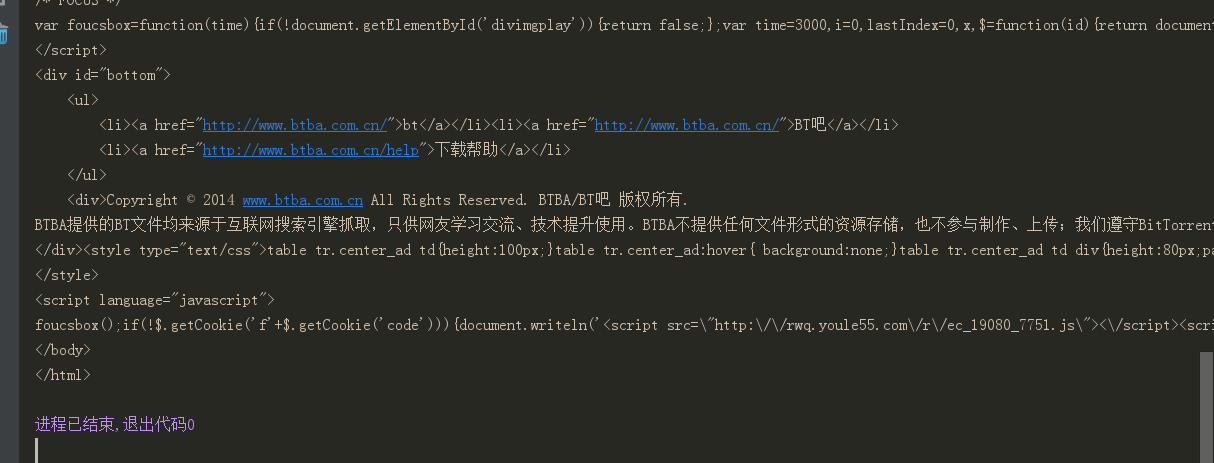
下面提供了HttpClient的下载: http://hc.apache.org/downloads.cgi
webmagic基于HttpClient、Jsoup 所以,现将这两个学会了、学懂了在去尝试啃webmagic吧
下一篇讲Jsoup对于本篇下载网页的简单解析处理。。。
本人还是小白一只,以上有什么不足或者不对之处请指出,非常感谢个位。
基于apache —HttpClient的小爬虫获取网页内容的更多相关文章
- 基于apache httpclient 调用Face++ API
简要: 本文简要介绍使用Apache HttpClient工具调用旷世科技的Face API. 前期准备: 依赖包maven地址: <!-- https://mvnrepository.com/ ...
- 基于apache httpclient的常用接口调用方法
现在的接口开发,大部分是基于http的请求和处理,现在整理了一份常用的调用方式工具类 package com.xh.oms.common.util; import java.io.BufferedRe ...
- Python实现简单的爬虫获取某刀网的更新数据
昨天晚上无聊时,想着练习一下Python所以写了一个小爬虫获取小刀娱乐网里的更新数据 #!/usr/bin/python # coding: utf-8 import urllib.request i ...
- 基于HttpClient、Jsoup的爬虫获取指定网页内容
不断尝试,发现越来越多有趣的东西,刚刚接触Jsoup感觉比正则表达式用起来方便,但也有局限只适用HTML的解析. 不能尝试运用到四则运算中(工作室刚开始联系的小程序). 在原来写的HttpClient ...
- 基于HttpClient实现网络爬虫~以百度新闻为例
转载请注明出处:http://blog.csdn.net/xiaojimanman/article/details/40891791 基于HttpClient4.5实现网络爬虫请訪问这里:http:/ ...
- 放养的小爬虫--京东定向爬虫(AJAX获取价格数据)
放养的小爬虫--京东定向爬虫(AJAX获取价格数据) 笔者声明:只用于学习交流,不用于其他途径.源代码已上传github.githu地址:https://github.com/Erma-Wang/Sp ...
- 新旧apache HttpClient 获取httpClient方法
在apache httpclient 4.3版本中对很多旧的类进行了deprecated标注,通常比较常用的就是下面两个类了. DefaultHttpClient -> CloseableHtt ...
- 使用selenium和phantomJS浏览器获取网页内容的小演示
# 使用selenium和phantomJS浏览器获取网页内容的小演示 # 导入包 from selenium import webdriver # 使用selenium库里的webdriver方法调 ...
- Python 基于学习 网络小爬虫
<span style="font-size:18px;"># # 百度贴吧图片网络小爬虫 # import re import urllib def getHtml( ...
随机推荐
- bjxdpkdzvaciu
xufutwovrcgwcdjrmkmsmoiemsgsfk
- 如何查看mysql数据库的引擎/MySQL数据库引擎详解
一般情况下,mysql会默认提供多种存储引擎,你可以通过下面的查看: 看你的mysql现在已提供什么存储引擎:mysql> show engines; 看你的mysql当前默认的存储引擎:mys ...
- linux入门基础——linux网络配置
linux网络配置 以太网连接 在linux中,以太网接口被命名为:eth0.eth1等.0.1代表网卡编号 通过lspci命令能够查看网卡硬件信息(假设是usb网卡,则须要使用lsusb命令) 命令 ...
- tomcat 输入localhost:8080显示404 (找不到tomcat主页)
最近使用tomcat时常出现一个问题,tomcat开启后浏览器输入localhost:8080时显示404,但是输入项目的路径是可以看到效果的,因为没啥大碍,所以没有在意 [ 在这里顺便介绍几种访问 ...
- Python进程、线程、协程之间的关系
一.从操作系统角度 操作系统处理任务, 调度单位是 进程 和 线程 . 1.进程: 表示一个程序的执行活动 (打开程序.读写程序数据.关闭程序) 2.线程: 执行某个程序时, 该进程调度的最小执行单位 ...
- Echart - 最好最强大效果最丰富的可视化图表插件
# 官网http://echarts.baidu.com/ # demohttp://echarts.baidu.com/gallery/index.html Echart npm install e ...
- docker mongo backup 不用找啦,就在这里。
rm -rf /tmp/mongodump && mkdir /tmp/mongodumpdocker run -it --rm --link lps-mongodb:mongo -v ...
- atitit.groovy 语法特性
atitit.groovy 语法特性 1. Groovy 1.6概览1 1.1. 多路赋值2 2. 新发布的Groovy2.0为这门语言带来了关键的静态特性:静态类型检查和静态编译:2 3. 参考3 ...
- css制作的61种图像
HTML: <!DOCTYPE html> <html> <head> <title>css各种形状</title> <link re ...
- 521. Longest Uncommon Subsequence I【easy】
521. Longest Uncommon Subsequence I[easy] Given a group of two strings, you need to find the longest ...