
Kafka 异步消息也会阻塞?记一次 Dubbo 频繁超时排查过程
线上某服务 A 调用服务 B 接口完成一次交易,一次晚上的生产变更之后,系统监控发现服务 B 接口频繁超时,后续甚至返回线程池耗尽错误 Thread pool is EXHAUSTED。因为服务 B 依赖外部接口,刚开始误以为外部接口延时导致,所以临时增加服务 B dubbo 线程池线程数量。配置变更之后,重启服务,服务恢复正常。一段时间之后,服务 B 再次返回线程池耗尽错误。这次深入排查问题之后,才发现 Kafka 异步发送消息阻塞了 dubbo 线程,从而导致调用超时。
一、问题分析
Dubbo 2.6.5,Kafak maven 0.8.0-beta1
服务 A 调用服务 B,收到如下错误:
2019-08-30 09:14:52,311 WARN method [%f [DUBBO] Thread pool is EXHAUSTED! Thread Name: DubboServerHandler-xxxx, Pool Size: 1000 (active: 1000, core: 1000, max: 1000, largest: 1000), Task: 6491 (completed: 5491), Executor status:(isShutdown:false, isTerminated:false, isTerminating:false), in dubbo://xxxx!, dubbo version: 2.6.0, current host: 127.0.0.1
可以看到当前 dubbo 线程池已经满载运行,不能再接受新的调用。正常情况下 dubbo 线程可以很快完成任务,然后归还到线程池中。由于线程执行的任务发生阻塞,消费者端调用超时。而服务提供者端由于已有线程被阻塞,线程池必须不断创建新线程处理任务,直到线程数量达到最大数量,系统返回 Thread pool is EXHAUSTED。
线程任务长时间被阻塞可能原因有:
- 频繁的 fullgc,导致系统暂停。
- 调用某些阻塞 API,如 socket 连接未设置超时时间导致阻塞。
- 系统内部死锁
通过分析系统堆栈 dump 情况,果然发现所有 dubbo 线程都处于 WATTING 状态。
下图为应用堆栈 dump 日志:
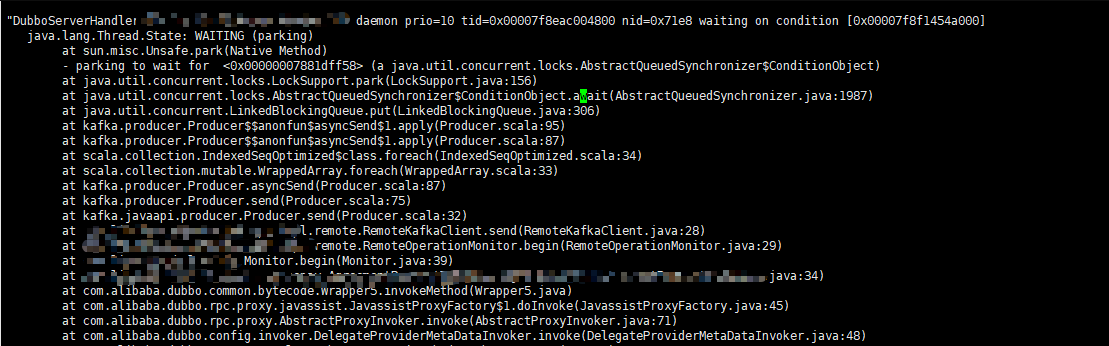
从堆栈日志可以看到 dubbo 线程最后阻塞在 LinkedBlockingQueue#put ,而该阻塞发生在 Kafka 发送消息方法内。
这里服务 B 需要使用 Kafka 发送监控消息,为了消息发送不影响主业务,这里使用 Kafka 异步发送消息。由于 Kafka 服务端最近更换了对外的端口,而服务 B Kafka 配置未及时变更。最后服务 B 修改配置,服务重新启动,该问题得以解决。
二、Kafka 异步模式
下面分析 Kafka 异步发送消息阻塞的实际原因。
0.8.0 Kafka 默认使用同步模式发送消息,异步发送消息需要设置producer.type=async属性。同步模式需要等待 Kafka 将消息发送到消息队列,这个过程当然会阻塞主线程。而异步模式最大的优点在于无需要等待 Kafka 这个发送过程。
原本认为这里的异步是使用子线程去运行任务,但是 Kafka 异步模式并非这样。查看 Kafka 官方文档producer,可以看到对异步模式描述。
Batching is one of the big drivers of efficiency, and to enable batching the Kafka producer has an asynchronous mode that accumulates data in memory and sends out larger batches in a single request. The batching can be configured to accumulate no more than a fixed number of messages and to wait no longer than some fixed latency bound (say 100 messages or 5 seconds). This allows the accumulation of more bytes to send, and few larger I/O operations on the servers. Since this buffering happens in the client it obviously reduces the durability as any data buffered in memory and not yet sent will be lost in the event of a producer crash.
从上我们可以看到,Kafka 异步模式将会把多条消息打包一块批量发送到服务端。这种模式将会先把消息放到内存队列中,直到消息到达一定数量(默认为 200)或者等待时间超限(默认为 5000ms)。
这么做最大好处在于提高消息发送的吞吐量,减少网络 I/O。当然这么做也存在明显劣势,如果生产者宕机,在内存中还未发送消息可能就会丢失。
下面从 kafka 源码分析这个阻塞过程。
三、Kafka 源码解析
Kafka 消息发送端采用如下配置:
        Properties props = new Properties();

        props.put("metadata.broker.list", "localhost:9092");

	// 选择异步发送

        props.put("producer.type", "async");

        props.put("serializer.class", "kafka.serializer.StringEncoder");

        props.put("queue.buffering.max.messages","1");

        props.put("batch.num.messages","1");

        Producer<Integer, String> producer= new Producer(new ProducerConfig(props));

        producer.send(new KeyedMessage("test", "hello world"));
这里设置 producer.type=async,从而使 Kafka 异步发送消息。
send 方法源码如下:
ps: 这个版本 Kafka 源码采用 Scala 编写,不过源码还是比较简单,比较容易阅读。
  def send(messages: KeyedMessage[K,V]*) {

    if (hasShutdown.get)

      throw new ProducerClosedException

    recordStats(messages)

    sync match {

      case true => eventHandler.handle(messages)

	// 由于  producer.type=async 异步发送

      case false => asyncSend(messages)

    }

  }
由于我们上面设置 producer.type=async,这里将会使用 asyncSend 异步发送模式。
asyncSend 源码如下:
  private def asyncSend(messages: Seq[KeyedMessage[K,V]]) {

    for (message <- messages) {

      val added = config.queueEnqueueTimeoutMs match {

        case 0  =>

          queue.offer(message)

        case _  =>

          try {

            config.queueEnqueueTimeoutMs < 0 match {

            case true =>

              queue.put(message)

              true

            case _ =>

              queue.offer(message, config.queueEnqueueTimeoutMs, TimeUnit.MILLISECONDS)

            }

          }

          catch {

            case e: InterruptedException =>

              false

          }

      }

      if(!added) {

        producerTopicStats.getProducerTopicStats(message.topic).droppedMessageRate.mark()

        producerTopicStats.getProducerAllTopicsStats.droppedMessageRate.mark()

        throw new QueueFullException("Event queue is full of unsent messages, could not send event: " + message.toString)

      }else {

        trace("Added to send queue an event: " + message.toString)

        trace("Remaining queue size: " + queue.remainingCapacity)

      }

    }

  }
asyncSend 将会把消息加入到 LinkedBlockingQueue 阻塞队列中。这里根据 config.queueEnqueueTimeoutMs参数使用不同方法。
当 config.queueEnqueueTimeoutMs=0,将会调用 LinkedBlockingQueue#offer,如果该队列未满,将会把元素插入队列队尾。如果队列未满,直接返回 false。所以如果此时队列已满,消息不再会加入队列中,然后 asyncSend 将会抛出 QueueFullException 异常。
当 config.queueEnqueueTimeoutMs < 0,将会调用 LinkedBlockingQueue#put 加入元素,如果该队列已满,该方法将会一直被阻塞直到队列存在可用空间。
当 config.queueEnqueueTimeoutMs > 0,将会调用 LinkedBlockingQueue#offer,这里与上面不同之处在于设置超时时间,如果队列已满将会阻塞知道超时。
config.queueEnqueueTimeoutMs参数通过 queue.enqueue.timeout.ms 配置生效,默认为 -1。默认情况下 LinkedBlockingQueue 最大数量为 10000,可以通过设置 queue.buffering.max.messages 改变队列最大值。
消息放到队列中后,Kafka 将会使用一个异步线程不断从队列中获取消息,批量发送消息。
异步处理消息代码如下:
  private def processEvents() {

    var lastSend = SystemTime.milliseconds

    var events = new ArrayBuffer[KeyedMessage[K,V]]

    var full: Boolean = false

    // drain the queue until you get a shutdown command

    Stream.continually(queue.poll(scala.math.max(0, (lastSend + queueTime) - SystemTime.milliseconds), TimeUnit.MILLISECONDS))

                      .takeWhile(item => if(item != null) item ne shutdownCommand else true).foreach {

      currentQueueItem =>

        val elapsed = (SystemTime.milliseconds - lastSend)

        // check if the queue time is reached. This happens when the poll method above returns after a timeout and

        // returns a null object

        val expired = currentQueueItem == null

        if(currentQueueItem != null) {

          trace("Dequeued item for topic %s, partition key: %s, data: %s"

              .format(currentQueueItem.topic, currentQueueItem.key, currentQueueItem.message))

          events += currentQueueItem

        }

        // check if the batch size is reached

        full = events.size >= batchSize

        if(full || expired) {

          if(expired)

            debug(elapsed + " ms elapsed. Queue time reached. Sending..")

          if(full)

            debug("Batch full. Sending..")

          // if either queue time has reached or batch size has reached, dispatch to event handler

          tryToHandle(events)

          lastSend = SystemTime.milliseconds

          events = new ArrayBuffer[KeyedMessage[K,V]]

        }

    }

    // send the last batch of events

    tryToHandle(events)

    if(queue.size > 0)

      throw new IllegalQueueStateException("Invalid queue state! After queue shutdown, %d remaining items in the queue"

        .format(queue.size))

  }
这里异步线程将会不断从队列中获取任务,一旦条件满足,就会批量发送任务。该条件为:
- 批量消息数量达到 200,可以设置
batch.num.messages参数改变配置。 - 等待时间到达最大的超时时间,默认为 5000ms,可以设置
queue.buffering.max.ms改变改配置。
四、问题解决办法
上面问题虽然通过更换 Kafka 正确地址解决,但是为了预防下次该问题再发生,可以采用如下方案:
- 改变
config.queueEnqueueTimeoutMs默认配置,像这种系统监控日志允许丢失,所以可以设置config.queueEnqueueTimeoutMs=0。 - 升级 Kafka 版本,最新版本 Kafka 使用 Java 重写发送端逻辑,不再使用阻塞队列存储消息。
本文首发于:studyidea.cn/kafka…
欢迎关注我的公众号:程序通事,获得日常干货推送。如果您对我的专题内容感兴趣,也可以关注我的博客:studyidea.cn
Kafka 异步消息也会阻塞?记一次 Dubbo 频繁超时排查过程的更多相关文章
- 解Bug之路-记一次存储故障的排查过程
解Bug之路-记一次存储故障的排查过程 高可用真是一丝细节都不得马虎.平时跑的好好的系统,在相应硬件出现故障时就会引发出潜在的Bug.偏偏这些故障在应用层的表现稀奇古怪,很难让人联想到是硬件出了问题, ...
- 记一次Xmrig挖矿木马排查过程
问题现象 Linux 服务器收到报警信息,主机 CPU 跑满. 自动创建运行 Docker 容器 xmrig, 导致其他运行中容器被迫停止. 问题原因 通过 top 命令可以看到有一个 xmrig 进 ...
- Kafka——分布式消息系统
Kafka——分布式消息系统 架构 Apache Kafka是2010年12月份开源的项目,采用scala语言编写,使用了多种效率优化机制,整体架构比较新颖(push/pull),更适合异构集群. 设 ...
- 快速入门:弄懂Kafka的消息流转过程
大家都知道 Kafka 是一个非常牛逼的消息队列框架,阿里的 RocketMQ 也是在 Kafka 的基础上进行改进的.对于初学者来说,一开始面对这么一个庞然大物会不知道怎么入手.那么这篇文章就带你先 ...
- kafka生产消息的速度跟什么有关?
kafka的吞吐量很大,在保证带宽的情况下,网上的一些测试表明3台broker,没有replication,6个partition的情况下,一般的写入速度可以达到300MB/s.参考:kakfa测试 ...
- KAFKA分布式消息系统
2015-01-05 大数据平台 Hadoop大数据平台 基本概念 kafka的工作方式和其他MQ基本相同,只是在一些名词命名上有些不同.为了更好的讨论,这里对这些名词做简单解释.通过这些解释应该可以 ...
- Kafka的消息格式
Commit Log Kafka储存消息的文件被它叫做log,按照Kafka文档的说法是: Each partition is an ordered, immutable sequence of me ...
- KAFKA分布式消息系统[转]
KAFKA分布式消息系统 转自:http://blog.chinaunix.net/uid-20196318-id-2420884.html Kafka[1]是linkedin用于日志处理的分布式消 ...
- [转载] KAFKA分布式消息系统
转载自http://blog.chinaunix.net/uid-20196318-id-2420884.html Kafka[1]是linkedin用于日志处理的分布式消息队列,linkedin的日 ...
随机推荐
- Keras 实例 MNIST
import numpy from keras.datasets import mnist from keras.models import Sequential from keras.layers ...
- 微信小程序获取手机号码看这篇文章就够了
前言 微信小程序获取手机号码,从官方文档到其他博主的文档 零零散散的 (我就是这样看过来 没有一篇满意的 也许是我搜索姿势不对) 依旧是前人栽树 后人乘凉 系列.保证看完 就可以实现获取手机号码功能 ...
- Codeforces 416D Population Size
Population Size 题意: 一共n个数, 每个-1都可以变成一个正数, 现在要求最少数目的等差子序列,并且在这个子序列必须要连着截取一段,不能分开截取. 样例1: 8 6 4 2 1 4 ...
- 2018阿里-研发工程师JAVA Software Engineer, Java
岗位描述Job Description如果你想了解JAVA开发在阿里巴巴互联网生态系统中无与伦比的应用广度与深度: 如果你对基础技术感兴趣,你可以参与基础软件的设计.开发和维护,如分布式文件系统.缓存 ...
- Go语言标准库之strconv
Go语言中strconv包实现了基本数据类型和其字符串表示的相互转换. strconv包 strconv包实现了基本数据类型与其字符串表示的转换,主要有以下常用函数: Atoi().Itia().pa ...
- Markdown 直接转换公众号文章,不再为排版花时间
上一篇「又一家数据公司被查,爬虫到底做错了什么?」反响强烈,虽然我这是新号,但还是获得了不少公众号的转发,借机也结识了很多业内大佬,在此感谢大家的抬爱! 同时也有不少号主问我的文章排版是用的哪个网站, ...
- netcore mvc 的简单实现
实现的功能 简单的路由系统 支持中间件 简单Filter支持 只支持HttpPost.HttpGet 使用Dotliquid做为视图渲染引擎 核心实现 HttpChannel 复制监听Tcp请求,并按 ...
- HTML5有哪些新特性,移除了哪些元素?如何处理HTML5新标签的浏览器兼容性问题?如何区分HTML和HTML5?
HTML5现在已经不是SGML的子集,主要是关于图像,位置,存储,多任务等功能的增加. 绘画canvas: 用于媒介回放的video和audio元素: 本地离线存储localStorage长期存储数据 ...
- JVM性能监视
1,按照如下图步骤将-XX:PermSize及 -XX:MaxPermSize的值修改到足够小,故意造项目启动报错,我设置为32m.然后保存. 2.在IDE中启动tomcat的同时打开dos窗口,使用 ...
- FJUT2019暑假周赛三部分题解
A本来想改到q<1e5,让你们预处理的,然后想了哈作为个逆元模板题吧= =,做不出来自行反思. B贴个题面 因为只有一次机会,那么也就是两点分布期望E = p了,先说说大家的做法,先求出每个n的 ...