
正则表达式和python中的re模块
---恢复内容开始---
常用的正则匹配规则
元字符
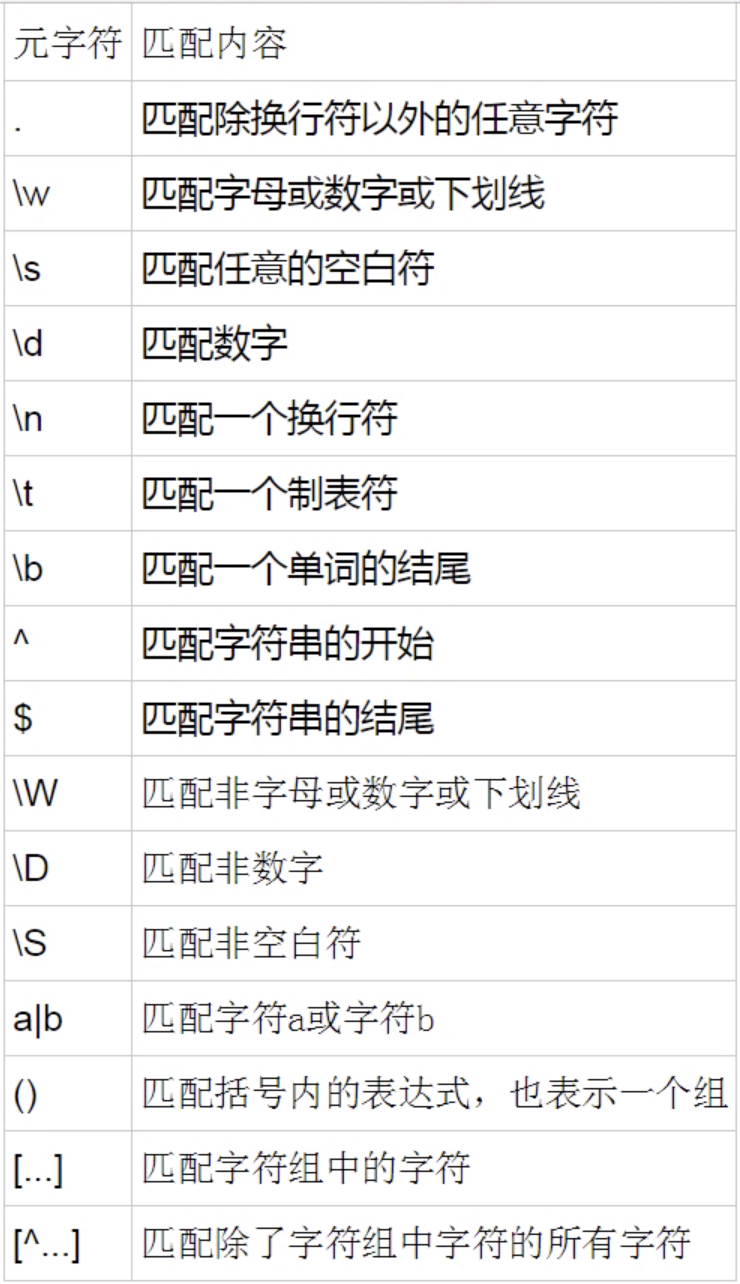
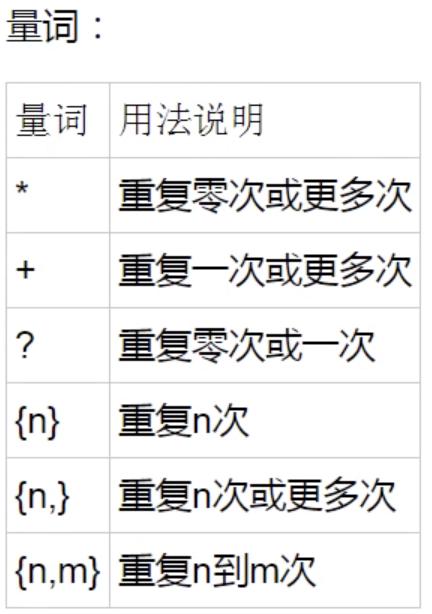
量词
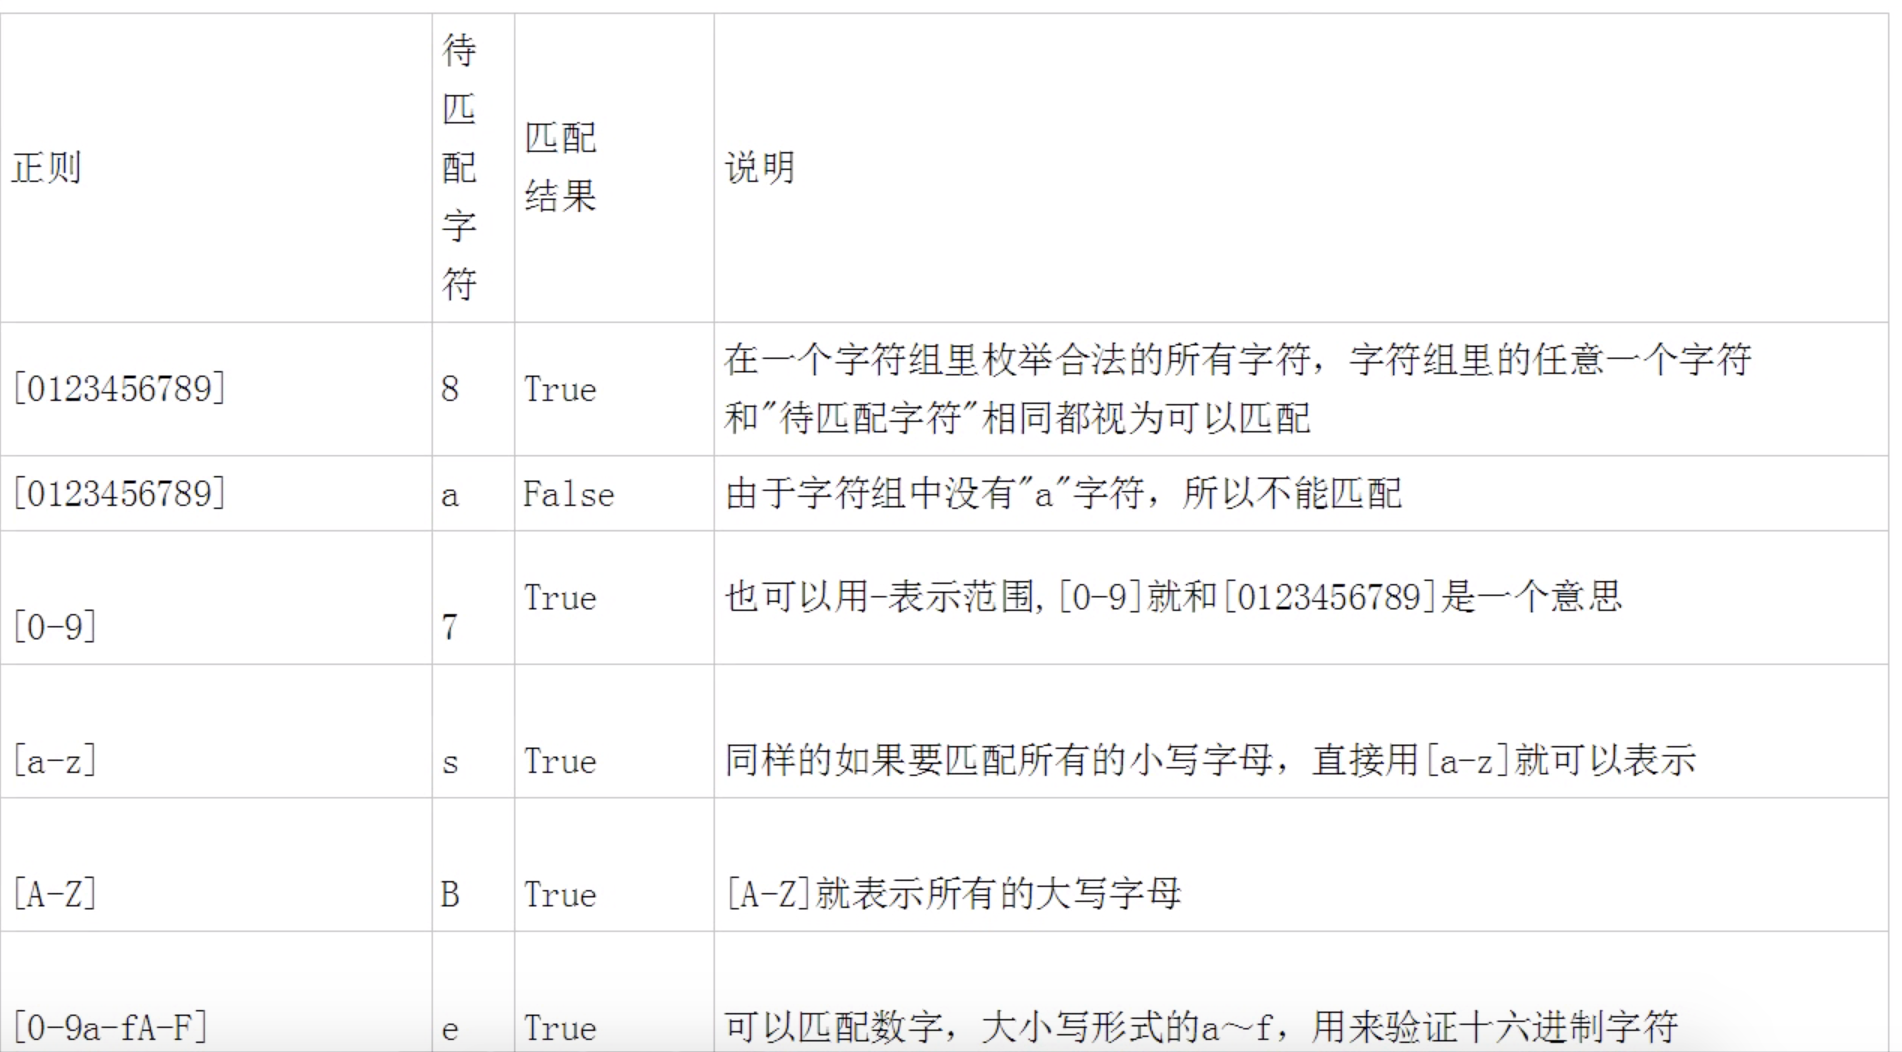
字符组
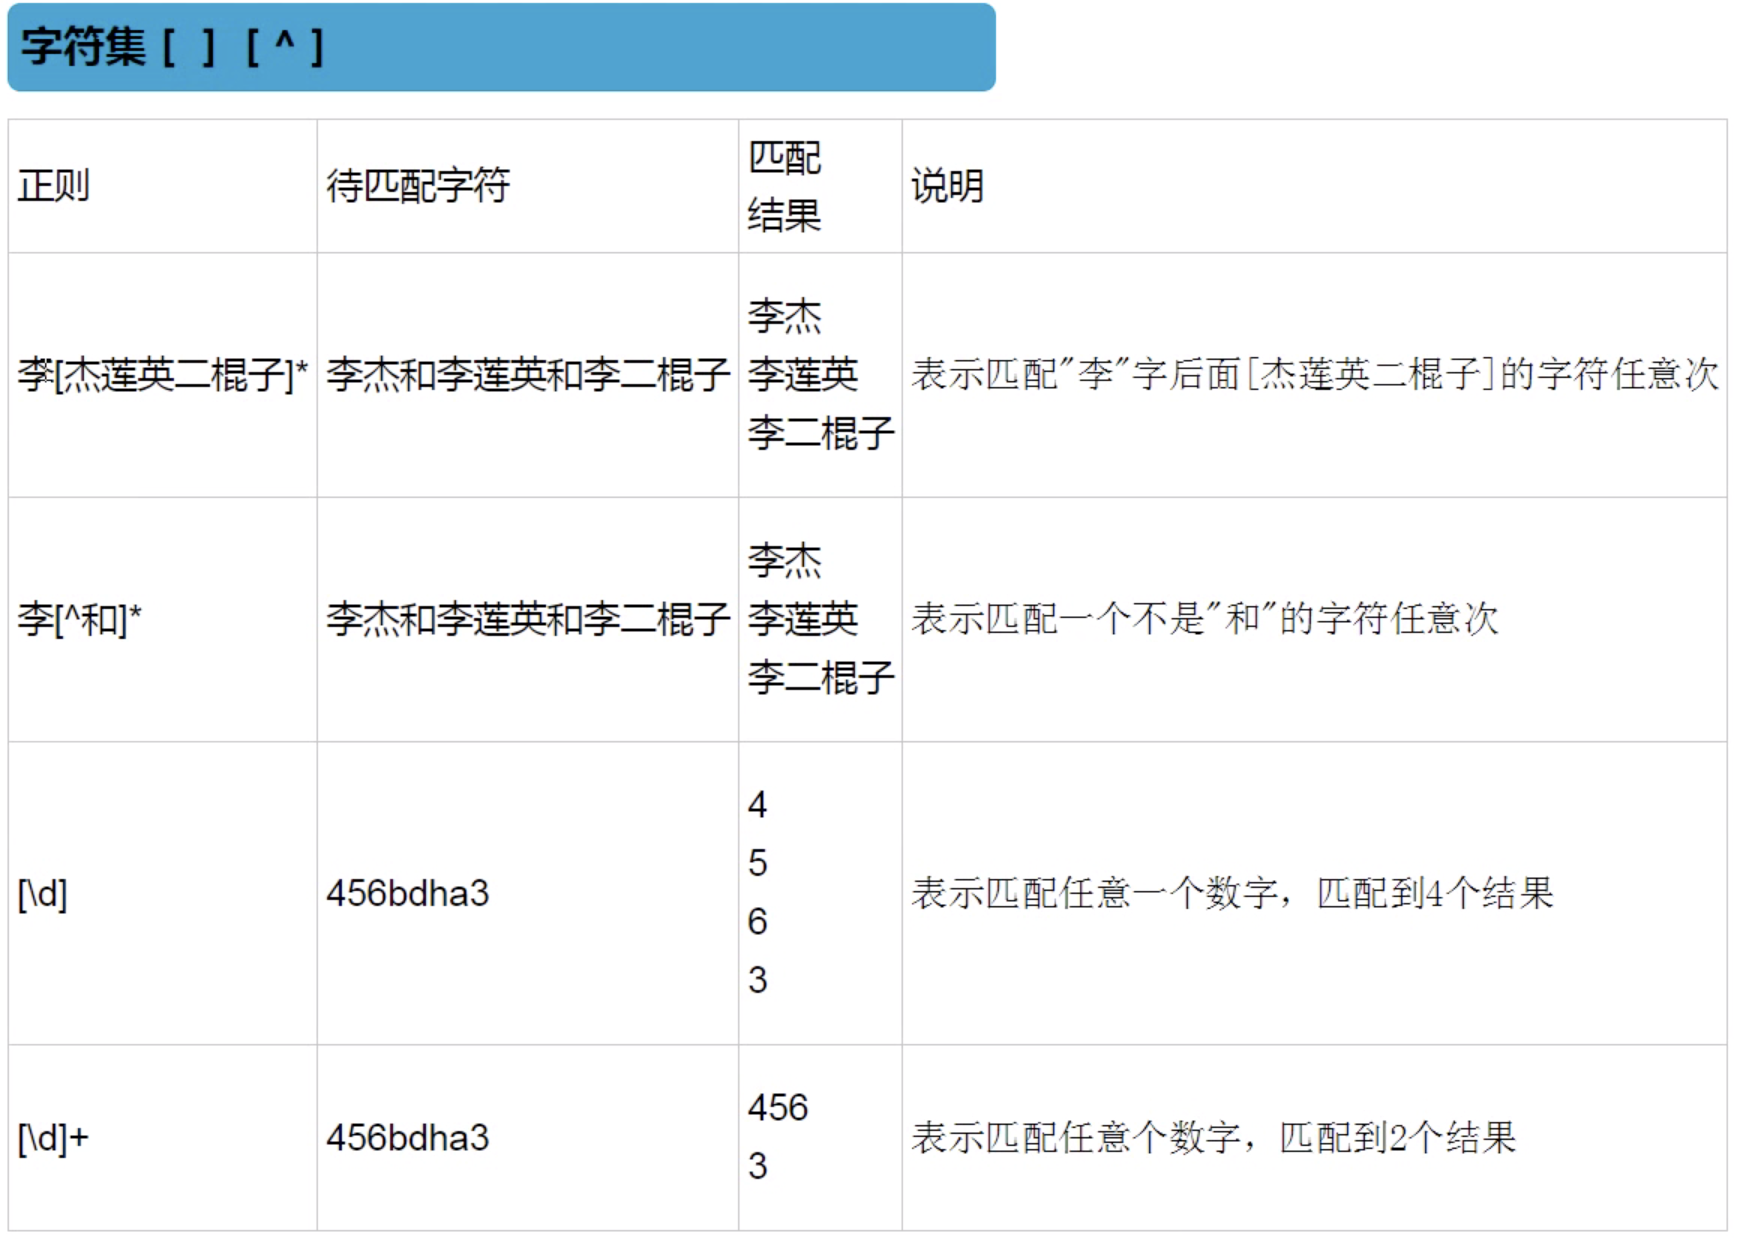
字符集
转义符

贪婪匹配
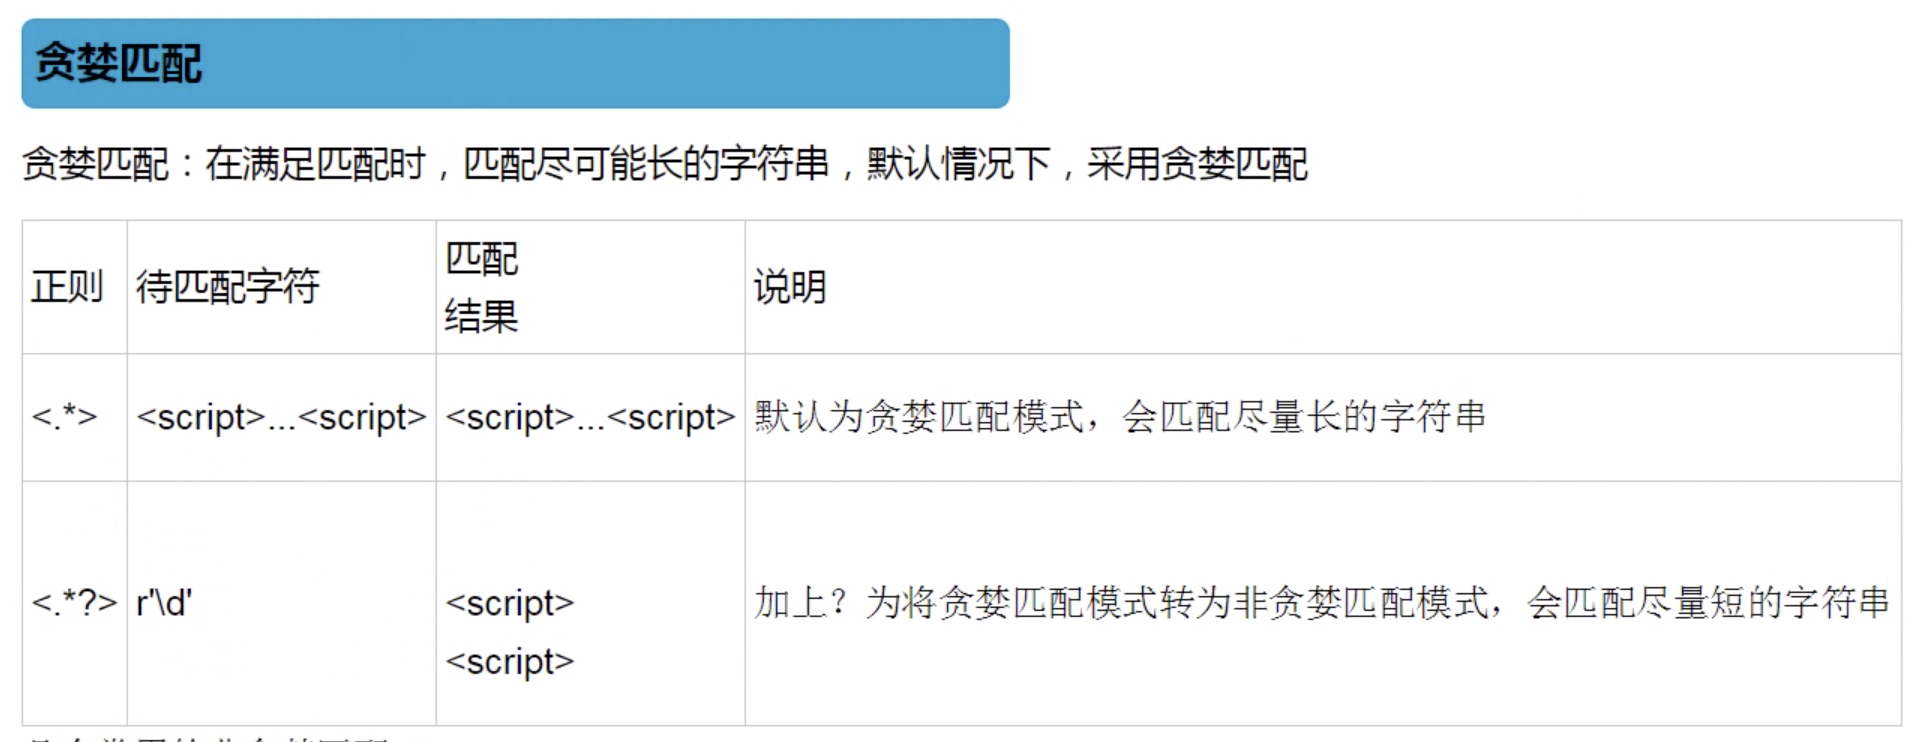
re模块使用正则表达式
实例引入(是否使用re模块和正则表达式的区别)
 # 不使用正则表达式

 phone_number = input("请输入一个11位数导入手机号码 :")

 if len(phone_number) == 11 \

     and phone_number.isdigit() \

     and (phone_number.startswith('')

         or phone_number.startswith('')

         or phone_number.startswith('')

         or phone_number.startswith('')

         or phone_number.startswith('')):

     print("这个手机好码是合法的")

 else:

     print("这个手机号码是不合法的")

 # 调用re模块使用正则表达式

 import re

 phone_number = input("请输入一个11位数导入手机号码 :")

 if re.match('^(13|15|17|18|19)[0-9]{9}$', phone_number):                     # 正则规则 : ^(13|15|17|18|19)[0-9]{9}$

     print("这个手机好码是合法的")

 else:

     print("这个手机号码是不合法的")
实例中涉及到内置函数starswich()函数
 # startswith()函数

 # string.startswith(str, beg=0,end=len(string))

 # 或string[beg:end].startswith(str)

 # 1、string:被检测的字符串        2、str:指定的字符或者子字符串     3、 beg:设置字符串检测的起始位置

 # 4、end:设置字符串检测的结束位置
match()
# match是从头开始匹配,如果正则规则开头可以匹配上,就返回一个变量。匹配的内容需要调用group才能显示。
# 如果没有找到,则返回None,调用group会报错
import re string = 'Hello! Regular expression, 520'
result = re.match('^Hello!\s\w*\s\w+.\s\d{3}', string=string) print(len(string), result, result.group(), result.span(), sep='\n\n') # 输出:
30 <re.Match object; span=(0, 30), match='Hello! Regular expression, 520'> Hello! Regular expression, 520 (0, 30) # span()方法可以输出皮牌的范围
修饰符
re.I 使匹配对大小写不敏感
re.L 做本地化识别( locale-aware )匹配
re.M 多行匹配,影响^和$
re.S. 使 .匹配包括换行在内的所有字符
re.U. 根据Unicode字符集解析字符。 这个标志影响\w、\W、\b和\B
re.X. 该标志通过给予你更灵活的格式以便你将正则表达式写得更易于理解
例如:import re
string = 'Hello! Regular expression, 520'
result = re.match('^Hello!\s\w*\s\w+.\s\d{3}', string, re.S)search()
# search是从前往后,寻找到一个就返回,返回的变量需要调用group才能拿到结果。如果没有找到,那么返回None,调用group回报错
 import re

 string =  'Hello! Regular expression, 5201314,Learning makes me happy and addicted to learning.'

 regular = 'Hello!\s\w*\s\w+.\s\d{3}'

 ret = re.search(regular, string)

 # 从前面往后面找到一个"Hello!\s\w*\s\w+.\s\d{3}"就返回

 print(ret)

 # 返回的是一个对象 : <re.Match object; span=(0, 30), match='Hello! Regular expression, 520'>
---恢复内容结束---
常用的正则匹配规则
元字符
量词
字符组
字符集
转义符
贪婪匹配
re模块使用正则表达式
实例引入(是否使用re模块和正则表达式的区别)
 # 不使用正则表达式

 phone_number = input("请输入一个11位数导入手机号码 :")

 if len(phone_number) == 11 \

     and phone_number.isdigit() \

     and (phone_number.startswith('')

         or phone_number.startswith('')

         or phone_number.startswith('')

         or phone_number.startswith('')

         or phone_number.startswith('')):

     print("这个手机好码是合法的")

 else:

     print("这个手机号码是不合法的")

 # 调用re模块使用正则表达式

 import re

 phone_number = input("请输入一个11位数导入手机号码 :")

 if re.match('^(13|15|17|18|19)[0-9]{9}$', phone_number):                     # 正则规则 : ^(13|15|17|18|19)[0-9]{9}$

     print("这个手机好码是合法的")

 else:

     print("这个手机号码是不合法的")
实例中涉及到内置函数starswich()函数
 # startswith()函数

 # string.startswith(str, beg=0,end=len(string))

 # 或string[beg:end].startswith(str)

 # 1、string:被检测的字符串        2、str:指定的字符或者子字符串     3、 beg:设置字符串检测的起始位置

 # 4、end:设置字符串检测的结束位置
match()
# match是从头开始匹配,如果正则规则开头可以匹配上,就返回一个变量。匹配的内容需要调用group才能显示。
# 如果没有找到,则返回None,调用group会报错
import re string = 'Hello! Regular expression, 520'
result = re.match('^Hello!\s\w*\s\w+.\s\d{3}', string=string) print(len(string), result, result.group(), result.span(), sep='\n\n') # 输出:
30 <re.Match object; span=(0, 30), match='Hello! Regular expression, 520'> Hello! Regular expression, 520 (0, 30) # span()方法可以输出皮牌的范围
修饰符
re.I 使匹配对大小写不敏感
re.L 做本地化识别( locale-aware )匹配
re.M 多行匹配,影响^和$
re.S. 使 .匹配包括换行在内的所有字符
re.U. 根据Unicode字符集解析字符。 这个标志影响\w、\W、\b和\B
re.X. 该标志通过给予你更灵活的格式以便你将正则表达式写得更易于理解
例如:import re
string = 'Hello! Regular expression, 520'
result = re.match('^Hello!\s\w*\s\w+.\s\d{3}', string, re.S)search()
# search是从前往后,寻找到一个就返回,返回的变量需要调用group才能拿到结果。如果没有找到,那么返回None,调用group回报错
 import re

 string =  'Hello! Regular expression, 5201314,Learning makes me happy and addicted to learning.'

 regular = 'Hello!\s\w*\s\w+.\s\d{3}'

 ret = re.search(regular, string)

 # 从前面往后面找到一个"Hello!\s\w*\s\w+.\s\d{3}"就返回

 print(ret)

 # 返回的是一个对象 : <re.Match object; span=(0, 30), match='Hello! Regular expression, 520'>
findall()
# 想要获取匹配正则表达式的所有内容,借助findall()方法,该方法会搜索整个字符串
 ret = re.findall('[a-z]+', 'eva egon yuan')

 # 返回所有满足匹配条件的结果,放在列表里

 print(ret)

 # 输出:['eva', 'egon', 'yuan']
sub()
# sub()方法修改文本
 ret = re.sub('\d', '马冬梅', '马什么梅? 0 马什么冬? 0 冬什么梅? 0', 3)

 # 将数字替换成'马冬梅',其中3代表替换了3次

 print(ret)

 # 输出:

 马什么梅? 马冬梅 马什么冬? 马冬梅 冬什么梅? 马冬梅
subn()
# subn()方法和sub()方法很相似
 import re

 ret = re.subn('\d', '马冬梅', '马什么梅? 0 马什么冬? 0 冬什么梅? 0')

 # 将数字替换成'马冬梅',返回元组(替换的结果,替换了多少次)

 print(ret)

 # 输出:

 ('马什么梅? 马冬梅 马什么冬? 马冬梅 冬什么梅? 马冬梅', 3)
compile()
# 将正则字符串编译成一个正则表达式对象
 import re

 obj = re.compile('\d{3}')

 # 将正则表达式编译成一个正则表达式对象,这里正则规则是要匹配三个数字

 ret = obj.search('abc123cba')

 # 正则表达式对象调用search,参数为待匹配的字符串

 print(ret.group())

 # 输出结果 : 123
finditer()
# 返回一个存放匹配结果的迭代器
 import re

 ret = re.finditer('\d', 'ab2cd4567efg')     # finditer返回一个存放匹配结果的迭代器

 print(ret)

 print(next(ret).group())        # 查看第一个结果

 print(next(ret).group())        # 查看第二个结果

 print(i.group() for i in ret)       # 查看剩余的所有结果

 # 上一条print已经输出了所有的结果,所以这个for循环不输出任何字符

 for i in ret:

     print(i.group())

 # 输出:

 <callable_iterator object at 0x10a077cf8>

 2

 4

 <generator object <genexpr> at 0x1142f5f48>

 5

 6

 7
举例理解正则、re
 ret = re.findall('www.(baidu|oldboy).com', 'www.oldboy.com')

 print(ret)          # #  ['oldboy']       这是因为findall会优先匹配结果组内容返回,如果想要匹配结果,取消权限即可

 ret = re.findall('www.(?:baidu|oldboy).com', 'www.oldboy.com')

 print(ret)          # #   ['www.oldboy.com']          取消优先级别的权限
优先级别(?:)
 ret = re.split('\d+', 'eva3egon4yuan')

 print(ret)      # 结果 : ['eva', 'egon', 'yuan']

 ret = re.split('(\d+)', 'eva3egon4yuan')

 print(ret)      # 结果 : ['eva', '3', 'egon', '4', 'yuan']

 # 在匹配部分加上()之后,切出的结果是不同的,

 # 没有()的没有保留匹配的项,但是有()却能够保留匹配的项

 # 这个在某些需要保留匹配部分的使用过程是非常重要的
(保留项)
 ret = re.search("<(?P<tag_name>\w+)>\w+</(?P=tag_name)>", "<hi>hello</hi>")

 # 还可以利用?P<name>的形式给分组起个名字

 # 获取匹配的结果可以直接用group('名字')拿到对应的值

 print(ret.group('tag_name'))        # 结果 : hi

 print(ret.group())              # 结果 : <hi>hello</hi>
?P给分组起名
 ret = re.search("<(\w+)>\w+</\1>", "<hi>hello</hi>")

 # 如果不给组起名字也可以用\序号来找到对应的组,表示要找的内容要和前面组的内容一致

 # 获取匹配的结果可以用group(序号)拿到对应的值

 print(ret.group(1))

 print(ret.group())
组序号
正则在线测试网址:http://tool.chinaz.com/regex/
抓取猫眼电影
 from urllib import request

 import re

 for i in range(27736):

     url = 'https://maoyan.com/films?showType=3&offset={0:}'.format(i * 30)

     response = request.urlopen(url=url)

     html = response.read().decode('utf-8')

     result = re.search('<dd>.*?title="(.*?)">.*?{movieId:(.*?)}">.*?(\d\.).*?(\d)</i></div>', html, re.S)

     dictionaries = {

         'Movie Item Title': result.group(1),

         'Movie ID': int(result.group(2)),

         'Movie Score': float(result.group(3) + result.group(4))

     }

     print(dictionaries)
有时候会报错,待完善
 import requests

 import re

 from requests.exceptions import RequestException

 import json

 import time

 # 抓取首页

 def get_one_page(url):

     try:

         headers = {

             # 伪浏览器

             'User-Agent': 'Mozilla/5.0 (Macintosh; Intel Mac OS X 10_13_3) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/65.0.3325.162 Safari/537.36'

         }

         response = requests.get(url, headers)       # 响应

         # 根据状态码返回响应内容

         if response.status_code == 200:

             return response.text

         return None

     # 请求异常

     except RequestException:

         return None

 # 正则表达式提取所需内容

 def paser_one_page(html):

     # 正则

     pattern = re.compile('<dd>.*?board-index.*?>(\d+)</i>.*?data-src="(.*?)".*?name"><a'

                          '.*?>(.*?)</a>.*?star">(.*?)</p>.*?releasetime">(.*?)</p>'

                          '.*?integer">(.*?)</i>.*?fraction">(.*?)</i></p>.*?</dd>', re.S)

     # 提取内容

     items = re.findall(pattern, html)

     print(items)

     # 每部电影对应一个字典

     for item in items:

         yield{

             'index': item[0],                       # 电影排名

             'image': item[1],                       # 电影图片

             'title': item[2],                       # 电影名称

             'actor': item[3].strip()[3:],           # 演员

             'time': item[4].strip()[5:],            # 上映时间

             'score': item[5]+item[6]                # 电影评分

         }

 # 将提取的内容写入文件

 def write_to_file(content):

     with open('result.txt', 'a', encoding='utf-8') as f:

         # 通过json.dumps(),实现字典的序列化,指定ensure_ascii=False保证输出结果是中文形式而不是Unicode编码

         f.write(json.dumps(content, ensure_ascii=False)+'\n')

         f.close()

 def main(offset):

     url = 'http://maoyan.com/board/4?offset='+str(offset)           # URL

     html = get_one_page(url)                # 抓取网页

     paser_one_page(html)                    # 提取抓取的内容

     for item in paser_one_page(html):       # 输出结果和写入文件

          print(item)

          write_to_file(item)

 if __name__ == '__main__':

     for i in range(10):

         main(offset=i*10)

         time.sleep(1)   # 现在猫眼多了反爬虫 , 如果速度过快,则会无响应,所以这里又增加了一个延时等待

 # 运行后,生成一个result.txt文件,输出内容雨文件内容一致
正则表达式和python中的re模块的更多相关文章
- 常用正则表达式与python中的re模块
正则表达式是一种通用的字符串匹配技术,不会因为编程语言不一样而发生变化. 部分常用正则表达式规则介绍: . 匹配任意的一个字符串,除了\n * 匹配任意字符串0次或者任意次 \w 匹配字母.数字.下划 ...
- (转)正则表达式与Python(RE)模块
Python正则表达式指南 原文:http://blog.csdn.net/qdx411324962/article/details/46799831 Python3(2):正则表达式与Python ...
- Python中的re模块--正则表达式
Python中的re模块--正则表达式 使用match从字符串开头匹配 以匹配国内手机号为例,通常手机号为11位,以1开头.大概是这样13509094747,(这个号码是我随便写的,请不要拨打),我们 ...
- 正则表达式与Python中re模块的使用
正则表达式与Python中re模块的使用 最近做了点爬虫,正则表达式使用的非常多,用Python做的话会用到re模块. 本文总结一下正则表达式与re模块的基础与使用. 另外,给大家介绍一个在线测试正则 ...
- Python中的random模块,来自于Capricorn的实验室
Python中的random模块用于生成随机数.下面介绍一下random模块中最常用的几个函数. random.random random.random()用于生成一个0到1的随机符点数: 0 < ...
- Python中的logging模块
http://python.jobbole.com/86887/ 最近修改了项目里的logging相关功能,用到了python标准库里的logging模块,在此做一些记录.主要是从官方文档和stack ...
- Python中的random模块
Python中的random模块用于生成随机数.下面介绍一下random模块中最常用的几个函数. random.random random.random()用于生成一个0到1的随机符点数: 0 < ...
- 浅析Python中的struct模块
最近在学习python网络编程这一块,在写简单的socket通信代码时,遇到了struct这个模块的使用,当时不太清楚这到底有和作用,后来查阅了相关资料大概了解了,在这里做一下简单的总结. 了解c语言 ...
- python中的StringIO模块
python中的StringIO模块 标签:python StringIO 此模块主要用于在内存缓冲区中读写数据.模块是用类编写的,只有一个StringIO类,所以它的可用方法都在类中.此类中的大部分 ...
随机推荐
- Windows和Linux下scrapy框架的安装
windows下安装: 1.安装Anaconda环境管理工具 也可以使用pip安装,值得注意的是如果你使用的是pip安装,你需要解决相应的包依赖(解决依赖一般会让你怀疑人生.怀疑scrapy,建议还是 ...
- rpm,yum
rpm RedHat Package Manager软件包管理器的核心功能:1.制作软件包2.安装.卸载.升级.查询.校验.数据库的重建.验证数据包等工作 安装: rpm -i /PATH/TO ...
- 快学Scala 第十八课 (trait多继承)
trait多继承: trait的继承并不像类拥有相同的含义!在下面这个例子中,如果还是运用类的继承的思想,那么运行结果将是什么也没有. trait Logged { def log(msg: Stri ...
- .net core session的使用步骤
步骤 操作 备注 1 Microsoft.AspNetCore.Session Microsoft.AspNetCore.Http.Extensions nuget安装包 2 ConfigureS ...
- docker服务在Mac上的启动与使用
在mac上打开安装的docker软件就可以启动docker服务了 点击顶部状态栏中鲸鱼图标会弹出操作菜单,显示着服务的状态,如下图所示: 只有在docker服务启动了之后,才可以在终端使用docker ...
- python selenium句柄操作
一.获取当前窗口句柄 1.元素有属性,浏览器的窗口其实也有属性的,只是你看不到,浏览器窗口的属性用句柄(handle)来识别. 2.人为操作的话,可以通过眼睛看,识别不同的窗口点击切换.但是脚本没长眼 ...
- LeetCode初级算法--链表01:反转链表
LeetCode初级算法--链表01:反转链表 搜索微信公众号:'AI-ming3526'或者'计算机视觉这件小事' 获取更多算法.机器学习干货 csdn:https://blog.csdn.net/ ...
- [NOIp2010] luogu P1541 乌龟棋
英语老师讲 mind map,真想说一句"声微饭否".为什么wyy的歌词总是快一点点.在报csp. 题目描述 你在一个序列上向正方向行走,起点是 a[0]a[0]a[0].每一步可 ...
- [Abp vNext 源码分析] - 12. 后台作业与后台工作者
一.简要说明 文章信息: 基于的 ABP vNext 版本:1.0.0 创作日期:2019 年 10 月 24 日晚 更新日期:暂无 ABP vNext 提供了后台工作者和后台作业的支持,基本实现与原 ...
- php中转菜刀脚本过狗免杀
<?php $target="url";//shell 地址 菜刀连这个脚本做中转 $post=''; $i=0; foreach($_POST AS $K=>$V) ...