
一个简单的python爬虫,以豆瓣妹子“http://www.dbmeizi.com/category/2?p= ”为例
本想抓取网易摄影上的图,但发现查看html源代码时找不到图片的url,但firebug却能定位得到。(不知道为什么???)
目标是抓取前50页的爆乳图,代码如下:
import urllib2,urllib,re,os

'''

http://www.dbmeizi.com/category/2?p=%

'''

def get_url_from_douban():

    url_list=[]

    p=re.compile(r'''<img.*?src="(.+?\.jpg)''') #找出发布人的标题和url

    for i in range(1,50):

        target = r"http://www.dbmeizi.com/category/2?p=%d"%i

        # print target

        req=urllib2.urlopen(target)

        result=req.read()

        matchs=p.findall(result)

        url_list.extend(matchs)

        # print matchs

        # print "-----"*40

    return url_list

def download_pic(url_list):

    # print url_lists

    count=0

    if not os.path.exists('/tmp/pic'):

        os.mkdir('/tmp/pic/')

    for url in url_list:

        urllib.urlretrieve(url,'/tmp/pic/'+str(count)+'.jpg')

        count+=1

if __name__=='__main__':

    # start_time=time.time()

    print "start getting url..."

    url_lists=get_url_from_douban()

    print "url getted! downloading..."

    download_pic(url_lists)

    print "download finish!!!"

    # cost_time=time.time() - start_time()

    # print cost_time

    # download_pic(url_lists)

------------------------------------------------------------------------------
/System/Library/Frameworks/Python.framework/Versions/2.7/bin/python /Users/lsf/PycharmProjects/some_subject/get_doubanmeizi_pic.py
start getting url...
url getted! downloading...
download finish!!!
Process finished with exit code 0
运行结果如图:
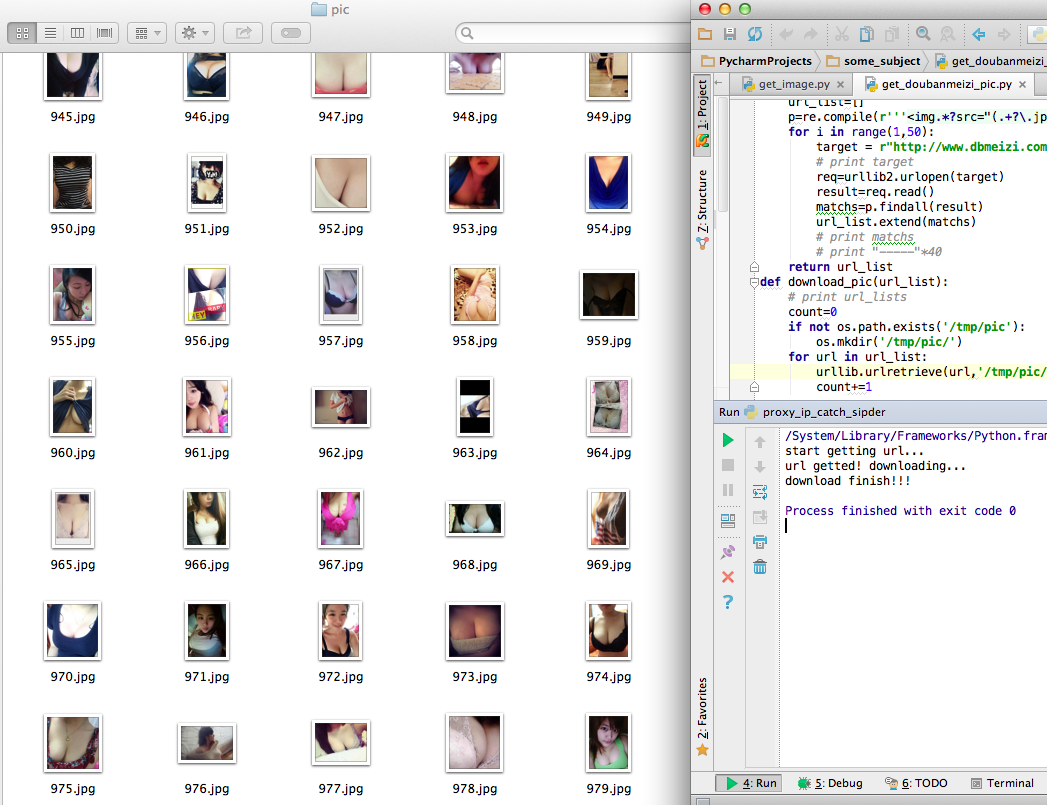
只是一个简单的实现方式,没有考虑性能,速度挺慢的。
ps:贴图会不会被查水表!!??
一个简单的python爬虫,以豆瓣妹子“http://www.dbmeizi.com/category/2?p= ”为例的更多相关文章
- 一个简单的python爬虫程序
python|网络爬虫 概述 这是一个简单的python爬虫程序,仅用作技术学习与交流,主要是通过一个简单的实际案例来对网络爬虫有个基础的认识. 什么是网络爬虫 简单的讲,网络爬虫就是模拟人访问web ...
- 一个简单的python爬虫,爬取知乎
一个简单的python爬虫,爬取知乎 主要实现 爬取一个收藏夹 里 所有问题答案下的 图片 文字信息暂未收录,可自行实现,比图片更简单 具体代码里有详细注释,请自行阅读 项目源码: # -*- cod ...
- 【Python学习笔记三】一个简单的python爬虫
这里写爬虫用的requests插件 1.一般那3.x版本的python安装后都带有相应的安装文件,目录在python安装目录的Scripts中,如下: 2.将scripts的目录配置到环境变量pa ...
- 一个简单的python爬虫(转)
# -*- coding: utf-8 -*- #--------------------------------------- # 程序:百度贴吧爬虫 # 版本:0.1 # 作者:why # 日期: ...
- 一个简单的Python爬虫
写了一个抓taobao图片的爬虫,全是用if,for,while写的,比较简陋,入门作品. 从网页http://mm.taobao.com/json/request_top_list.htm?type ...
- python实现的一个简单的网页爬虫
学习了下python,看了一个简单的网页爬虫:http://www.cnblogs.com/fnng/p/3576154.html 自己实现了一个简单的网页爬虫,获取豆瓣的最新电影信息. 爬虫主要是获 ...
- Python爬虫(四)——豆瓣数据模型训练与检测
前文参考: Python爬虫(一)——豆瓣下图书信息 Python爬虫(二)——豆瓣图书决策树构建 Python爬虫(三)——对豆瓣图书各模块评论数与评分图形化分析 数据的构建 在这张表中我们可以发现 ...
- 做一个简单的scrapy爬虫
前言: 做一个简单的scrapy爬虫,带大家认识一下创建scrapy的大致流程.我们就抓取扇贝上的单词书,python的高频词汇. 步骤: 一,新建一个工程scrapy_shanbay 二,在工程中中 ...
- 作业1开发一个简单的python计算器
开发一个简单的python计算器 实现加减乘除及拓号优先级解析 用户输入 1 - 2 * ( (60-30 +(-40/5) * (9-2*5/3 + 7 /3*99/4*2998 +10 * 568 ...
随机推荐
- 推荐几个优秀的java爬虫项目
java爬虫项目 大型的: Nutch apache/nutch · GitHub 适合做搜索引擎,分布式爬虫是其中一个功能. Heritrix internetarchive/heritrix3 ...
- 百度Couldn't load BaiduMapSDK_v2_4_1 from loader dalvik
原文链接:http://liuzhichao.com/p/1463.html 在使用百度定位SDK的时候,明明已经加入了liblocSDK3.so,Manifest中也添加了相应权限,注册了com.b ...
- 基础学习day09--内部类
一.内部类 1.1.内部类概念 定义在一个类内部中的另一个类,被称为内部类 特点: 可以直接访问,内部类的外部类中的,成员属性和方法(包含-private) 外部类要访问内部类中的成员和方法,需要先建 ...
- 配置JDK环境变量
•配置JDK环境变量<Windows系统下> 点击我的电脑右键----->属性------>高级------>环境变量-------> 新建(建议在系统变量中新建 ...
- navicat 连接sqlserver提示要安装 sql server native client
navicat 连接sqlserver提示要安装 sql server native client 解决方法:其实navicat自带sqlncli_x64.msi,就在安装目录下,安装后问题解决!
- 推些C语言与算法书籍
c语言系统学习与进阶: 1. C primer plus C primer plus 作为一本被人推崇备至的 c 入门经典,C primer plus 绝非浪得虚名.应该 算得上 C 教材里最好的入门 ...
- [Weblogic]如何清理缓存
背景:在开发调试或测试时,很多时候重新更新部署服务后会发现某些更新并没有体现到,还是之前的情况,也或者会出现其他错误问题,这个时候就要考虑到可能是weblogic缓存未清理引起. 清理缓存步骤如下: ...
- Effective Java 59 Avoid unnecessary use of checked exceptions
The burden is justified if the exceptional condition cannot be prevented by proper use of the API an ...
- springMVC 接收数组参数,mybatis 接收数组参数,mybatis批量插入/批量删除案例
案例是给一个用户赋予多个权限,多个权限用其对应的主键 id 为参数,组成了 一个id数组,传给springMVC,然后springMVC传给mybatis,然后mybatis批量插入.其实类似的场景还 ...
- DNS报文格式
原文链接地址:http://blog.chinaunix.net/uid-24875436-id-3088461.html DNS报文格式(借个图贴过来): 说明一下:并不是所有DNS报文都有 ...