
Python爬虫通过替换http request header来欺骗浏览器实现登录
以豆瓣为例,访问https://www.douban.com/contacts/list 来查看自己关注的人,要登录才能查看。
如果用requests.get()方法获取这个http,没登录只能抓取回一个登录界面,所以我们要用Python登录网站才能抓取想要的网页。
一个简便的方法就是自己在浏览器上登录好,然后通过下图方法(Chrome为例),找到自己的Cookie和User-Agent,然后发送request时用这复制来的header替换掉待发送的request以达到登录的目的,server端会凭这个认为你是已经登录的用户。
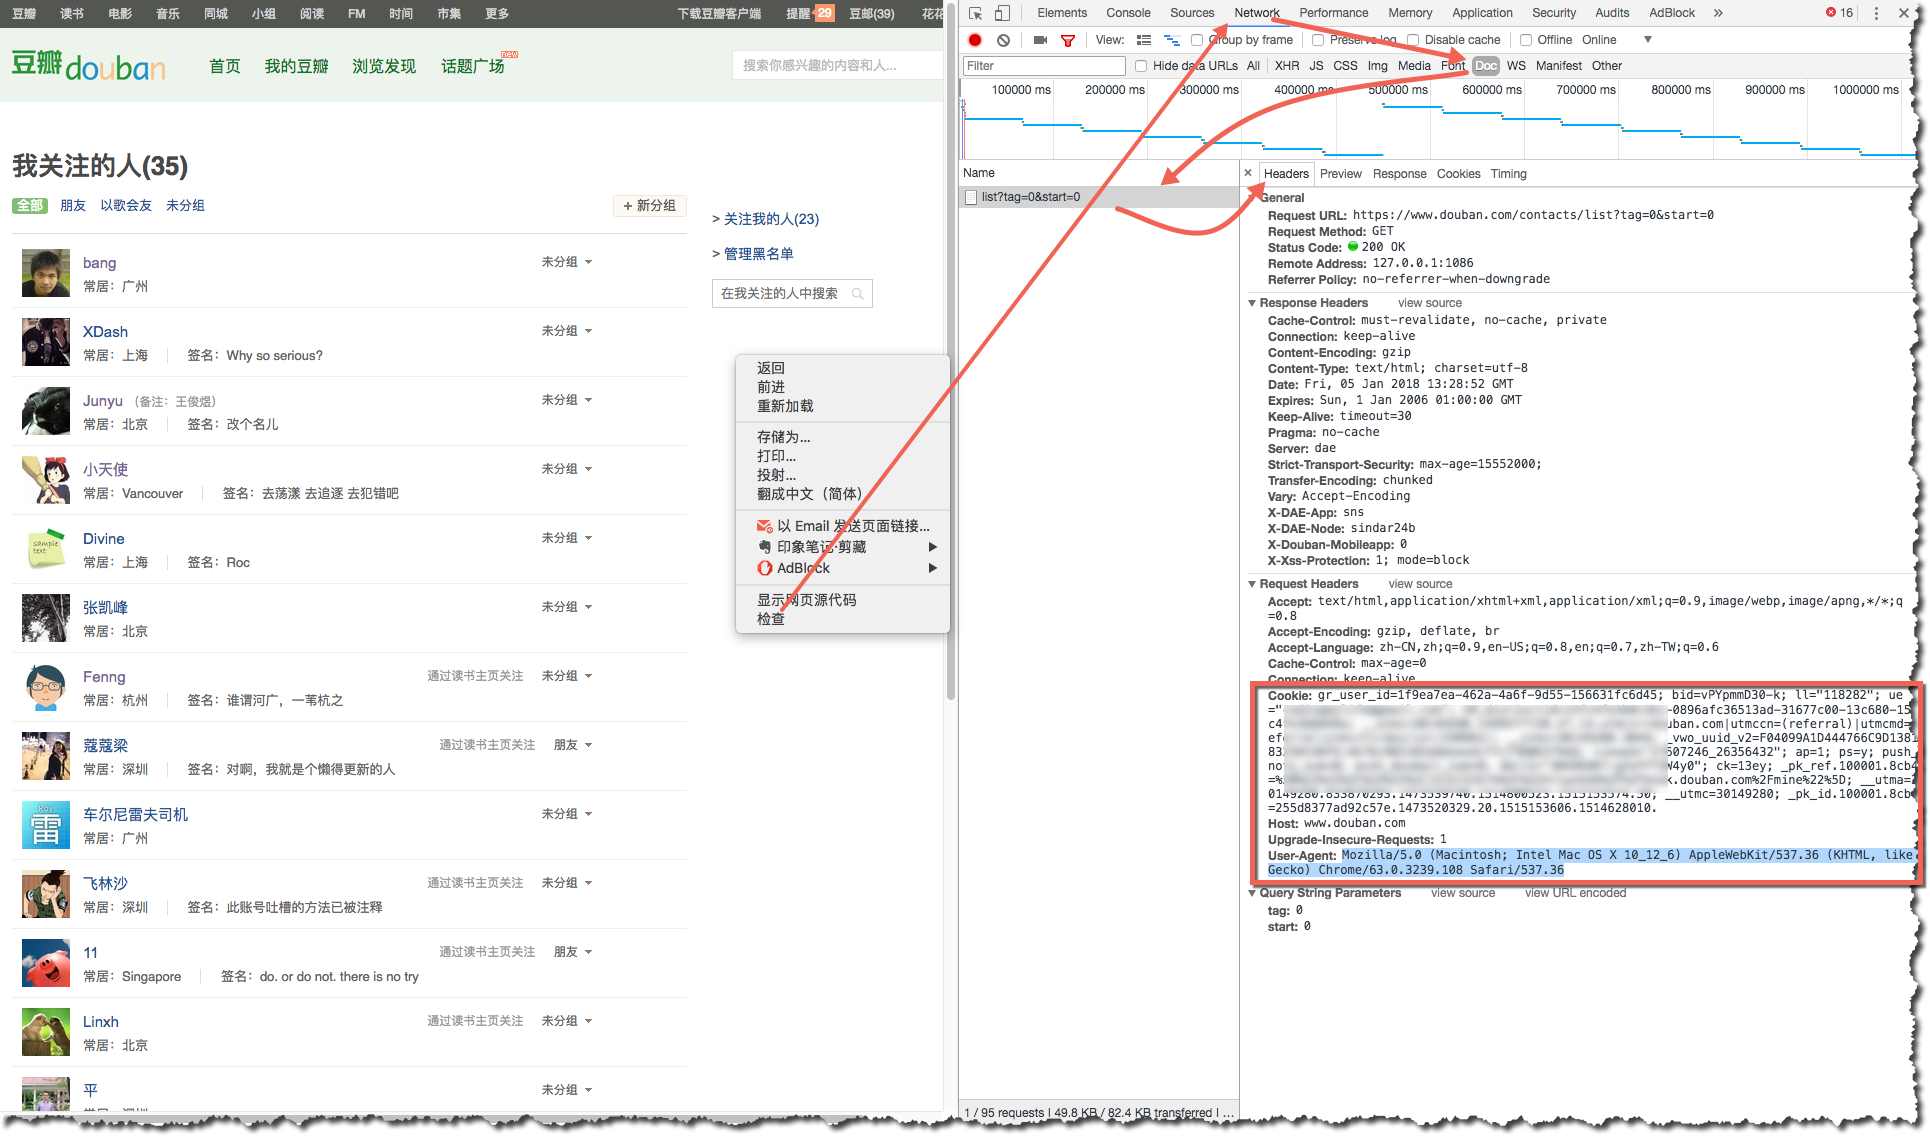
代码如下:
import requests

headers = {

    'User-Agent':'Mozilla/5.0 (Macintosh; Intel Mac OS X 10_12_6) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/63.0.3239.108 Safari/537.36',

    'Cookie':'gr_user_id=1f9ea7ea-462a-4a6f-9d55-156631fc6d45; bid=vPYpmmD30-k; ll="118282"; ue="codin; __utmz=30149280.1499577720.27.14.utmcsr=douban.com|utmccn=(referral)|utmcmd=referral|utmcct=/doulist/240962/; __utmv=30149280.3049; _vwo_uuid_v2=F04099A9dd; viewed="27607246_26356432"; ap=1; ps=y; push_noty_num=0; push_doumail_num=0; dbcl2="30496987:gZxPfTZW4y0"; ck=13ey; _pk_ref.100001.8cb4=%5B%22%22%2C%22%22%2C1515153574%2C%22https%3A%2F%2Fbook.douban.com%2Fmine%22%5D; __utma=30149280.833870293.1473539740.1514800523.1515153574.50; __utmc=30149280; _pk_id.100001.8cb4=255d8377ad92c57e.1473520329.20.1515153606.1514628010.'

} #替换成自己的cookie

r = requests.get('https://www.douban.com/contacts/list', headers = headers)

print(r.text)
Python爬虫通过替换http request header来欺骗浏览器实现登录的更多相关文章
- python爬虫入门01:教你在 Chrome 浏览器轻松抓包
通过 python爬虫入门:什么是爬虫,怎么玩爬虫? 我们知道了什么是爬虫 也知道了爬虫的具体流程 那么在我们要对某个网站进行爬取的时候 要对其数据进行分析 就要知道应该怎么请求 就要知道获取的数据是 ...
- Python爬虫 【requests】request for humans
安装 pip install requests 源码 git clone git://github.com/kennethreitz/requests.git 导入 import requests 发 ...
- Python 爬虫js加密破解(四) 360云盘登录password加密
登录链接:https://yunpan.360.cn/mindex/login 这是一个md5 加密算法,直接使用 md5加密即可实现 本文讲解的是如何抠出js,运行代码 第一部:抓包 如图 第二步: ...
- python爬虫04 | 长江后浪推前浪,Reuqests库把urllib库拍在沙滩上
最近 有些朋友 看完小帅b的文章之后 把小帅b的表情包都偷了 还在我的微信 疯狂发表情包嘚瑟 我就呵呵了 只能说一句 盘他 还有一些朋友 看完文章不点好看 还来催更 小帅b也只能说一句 继续盘他 ...
- Python爬虫教程-06-爬虫实现百度翻译(requests)
使用python爬虫实现百度翻译(requests) python爬虫 上一篇介绍了怎么使用浏览器的[开发者工具]获取请求的[地址.状态.参数]以及使用python爬虫实现百度翻译功能[urllib] ...
- python爬虫入门02:教你通过 Fiddler 进行手机抓包
哟~哟~哟~ hi起来 everybody 今天要说说怎么在我们的手机抓包 通过 python爬虫入门01:教你在Chrome浏览器轻松抓包 我们知道了 HTTP 的请求方式 以及在 Chrome 中 ...
- python爬虫10 | 网站维护人员:真的求求你们了,不要再来爬取了!!
今天 小帅b想给大家讲一个小明的小故事 ... 话说 在很久很久以前 小明不小心发现了一个叫做 学习python的正确姿势 的公众号 从此一发不可收拾 看到什么网站都想爬取 有一天 小明发现了一个小黄 ...
- python爬虫如何POST request payload形式的请求
python爬虫如何POST request payload形式的请求1. 背景最近在爬取某个站点时,发现在POST数据时,使用的数据格式是request payload,有别于之前常见的 POST数 ...
- (转)python爬虫----(scrapy框架提高(1),自定义Request爬取)
摘要 之前一直使用默认的parse入口,以及SgmlLinkExtractor自动抓取url.但是一般使用的时候都是需要自己写具体的url抓取函数的. python 爬虫 scrapy scrapy提 ...
随机推荐
- 自动化运维工具——ansible详解(二)
Ansible playbook 简介 playbook 是 ansible 用于配置,部署,和管理被控节点的剧本. 通过 playbook 的详细描述,执行其中的一系列 tasks ,可以让远端主机 ...
- JAVA高并发程序设计笔记
第二章 Java并行程序基础 1.join()的本质是让调用线程wait()在当前线程的对象上 2.Thread.yiedl()会使当前线程让出CPU 3.volatile保证可见性,无法保证原子性( ...
- ORACLE+PYTHON实战:复制A表数据到B表
最近在学习python ,看到了pythod的oracle,不仅可以一次fetch多条,也可以一次insert多条,想写一个复制A表数据到B表的程序来看看实际效率能不能提高.写完发现,非常惊艳!效率提 ...
- kali git 环境配置
kali 配置很简单,输入apt-get install git 我输入时返回了错误,执行命令dpkg --configure -a 就行了
- 浏览器抓包(post)
谁能想到我写的第一个wp竟然是个web题??? 以Geek2017_Buy me a Tesla 为例 来看看题目 emmmm有理想还是很好的,火狐打开(事实证明FF对web题是最友好的) 能点的地方 ...
- NS3网络仿真(10): 解析以太网帧
快乐虾 http://blog.csdn.net/lights_joy/ 欢迎转载.但请保留作者信息 解析以太网帧的过程是构建以太网帧的逆过程,当我们接收到一个以太网帧时,仍然以上一节中的ARP帧为例 ...
- UVA 12009 - Avaricious Maryanna(数论)
UVA 12009 - Avaricious Maryanna 题目链接 题意:给定一个n.求出n个数位组成的数字x,x^2的前面|x|位为x 思路:自己先暴力打了前几组数据,发现除了1中有0和1以外 ...
- HDU 4193 Non-negative Partial Sums(想法题,单调队列)
HDU 4193 题意:给n个数字组成的序列(n <= 10^6).求该序列的循环同构序列中,有多少个序列的随意前i项和均大于或等于0. 思路: 这题看到数据规模认为仅仅能用最多O(nlogn) ...
- 多域名环境,页面获取url的一种方案
因为系统是分布式部署的.而且有多个域名,所以常常涉及到获取url的问题. 这是系统框架层面须要提供的能力.否则每一个模块都须要自己去想办法获取ip,就会非常混乱.上线也easy发生bug 主要须要解决 ...
- Maven依赖的是本地工程还是仓库jar包?
相信大家都碰见过maven配置的依赖或者是jar包或者是工程,在开发的过程当中,我们当然需要引入的是工程,这样查看maven依赖的文件的时候,就能直接查看到源码. 一.本地工程依赖 举个例子,其架构如 ...