
基于spark邮件自动分类
代码放在github上:click me
一、数据说明
数据集为英文语料集,一共包含20种类别的邮件,除了类别soc.religion.christian的邮件数为997以外每个类别的邮件数都是1000。每份邮件内部包含发送者,接受者,正文等信息。
二、实验方法
2.1 数据预处理
数据预处理阶段采用了几种方案进行测试
直接将邮件内容按空格分词
使用stanford corenlp进行分词,然后使用停词表过滤分词结果
使用stanford corenlp进行分词,并根据词性和停词表过滤分词结果
综合上面三种方案,测试结果最好的是方案二的预处理方式。将所有的邮件预处理之后写入一个文件中,文件每行对应一封邮件,形式如"类别\t按空格分隔的邮件分词"
comp.os.ms-windows.misc    I search Ms-Windows logo picture start Windows

misc.forsale    ITEMS for SALEI offer item I reserve the right refuse offer Howard Miller

comp.sys.ibm.pc.hardware    I hd bad suggest inadequate power supply how wattage
2.2 pipeline建模
基于spark的pipeline构建端到端的分类模型
将数据预处理后得到的文件上传到hdfs上,spark从hdfs上读取文本数据并转换成DataFrame
为DataFrame的邮件类别列建立索引,然后将DataFrame作为Word2Vec的输入获取句子的向量表示
句子向量输入到含有2层隐藏层的多层感知机(MLP)中进行分类学习
将预测结果的索引列转换成可读的邮件类别标签
A[dataset] -- input --> B[Word2Vec]
B[Word2Vec] -- embeddings --> C[MLP]
C[MLP] -- output --> D[prediction]
三、实验结果
将数据集随机划分成8:2,80%的数据作为训练集,20%的数据作为测试集。经过合理的调参,在测试集上的accuracy和F1 score可以达到90.5%左右,关键参数设置如下
 // Word2Vec超参

 final val W2V_MAX_ITER = 5  // Word2Vec迭代次数

 final val EMBEDDING_SIZE = 128  // 词向量长度

 final val MIN_COUNT = 1 // default: 5, 词汇表阈值即至少出现min_count次才放入词汇表中

 final val WINDOW_SIZE = 5  // default: 5, 上下文窗口大小[-WINDOW_SIZE,WINDOW_SIZE]

 // MLP超参

 final val MLP_MAX_ITER = 300  // MLP迭代次数

 final val SEED = 1234L  // 随机数种子,初始化网络权重用

 final val HIDDEN1_SIZE = 64  // 第一层隐藏层节点数

 final val HIDDEN2_SIZE = 32  // 第二层隐藏层节点数

 final val LABEL_SIZE = 20  // 输出层节点数
邮件预测结果输出在hdfs上,文件内容每行的de左边是真实label,右边是预测label

四、实验运行
4.1 环境要求
hadoop-2.7.5
spark-2.3.0
stanford corenlp 3.9.2
4.2 源代码说明
Maven项目文件结构如下
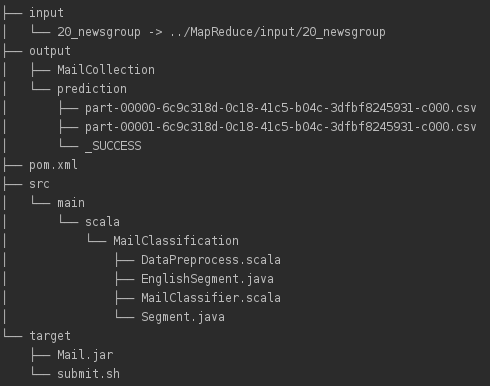
src/main/scala下为源代码,其中Segment.java和EnglishSegment.java用于英文分词,DataPreprocess.scala基于分词作数据预处理,MailClassifier.scala对应邮件分类模型。input下为数据集,output下为数据预处理结果MailCollection和预测结果prediction,target下为maven打好的jar包Mail.jar以及运行脚本submit.sh,pom.xml为maven配置。
4.3 运行方式
将数据集20_newsgroup放在input目录下,确保pom.xml中的依赖包都满足以后运行DataPreprocess得到预处理的结果MailCollection输出到output目录下。启动hadoop的hdfs,将MailCollection上传到hdfs上以便spark读取。然后启动spark,命令行下进入到target路径下运行./submit.sh提交任务,submit.sh内容如下
spark-submit --class MailClassifier --master spark://master:7077 --conf spark.driver.memory=10g --conf spark.executor.memory=4g --conf spark.executor.cores=2 --conf spark.kryoserializer.buffer=512m --conf spark.kryoserializer.buffer.max=1g Mail.jar input/MailCollection output
运行MailClassifier需要两个命令行参数,其中input/MailCollection为上传到hdfs上的路径名,output为预测结果输出到hdfs上的路径名,提交任务前确保输出路径在hdfs上不存在,否则程序会删除输出输出路径以确保程序正确运行。
基于spark邮件自动分类的更多相关文章
- 基于Spark Mllib的文本分类
基于Spark Mllib的文本分类 文本分类是一个典型的机器学习问题,其主要目标是通过对已有语料库文本数据训练得到分类模型,进而对新文本进行类别标签的预测.这在很多领域都有现实的应用场景,如新闻网站 ...
- 基于Spark ALS构建商品推荐引擎
基于Spark ALS构建商品推荐引擎 一般来讲,推荐引擎试图对用户与某类物品之间的联系建模,其想法是预测人们可能喜好的物品并通过探索物品之间的联系来辅助这个过程,让用户能更快速.更准确的获得所需 ...
- 【基于spark IM 的二次开发笔记】第一天 各种配置
[基于spark IM 的二次开发笔记]第一天 各种配置 http://juforg.iteye.com/blog/1870487 http://www.igniterealtime.org/down ...
- 大数据实时处理-基于Spark的大数据实时处理及应用技术培训
随着互联网.移动互联网和物联网的发展,我们已经切实地迎来了一个大数据 的时代.大数据是指无法在一定时间内用常规软件工具对其内容进行抓取.管理和处理的数据集合,对大数据的分析已经成为一个非常重要且紧迫的 ...
- 基于Spark和SparkSQL的NetFlow流量的初步分析——scala语言
基于Spark和SparkSQL的NetFlow流量的初步分析--scala语言 标签: NetFlow Spark SparkSQL 本文主要是介绍如何使用Spark做一些简单的NetFlow数据的 ...
- UserView--第二种方式(避免第一种方式Set饱和),基于Spark算子的java代码实现
UserView--第二种方式(避免第一种方式Set饱和),基于Spark算子的java代码实现 测试数据 java代码 package com.hzf.spark.study; import ...
- UserView--第一种方式set去重,基于Spark算子的java代码实现
UserView--第一种方式set去重,基于Spark算子的java代码实现 测试数据 java代码 package com.hzf.spark.study; import java.util.Ha ...
- 基于Spark自动扩展scikit-learn (spark-sklearn)(转载)
转载自:https://blog.csdn.net/sunbow0/article/details/50848719 1.基于Spark自动扩展scikit-learn(spark-sklearn)1 ...
- 苏宁基于Spark Streaming的实时日志分析系统实践 Spark Streaming 在数据平台日志解析功能的应用
https://mp.weixin.qq.com/s/KPTM02-ICt72_7ZdRZIHBA 苏宁基于Spark Streaming的实时日志分析系统实践 原创: AI+落地实践 AI前线 20 ...
随机推荐
- JVM(12)之 可视化分析工具
开发十年,就只剩下这套架构体系了! >>> 经过前几篇博文对堆内存以及垃圾收集机制的学习,相信小伙伴们已经建立了一套比较完整的理论体系!本篇博客就根据已有的理论知识,通过可视化工 ...
- 【学习总结】GirlsInAI ML-diary day-20-初识 Kaggle
[学习总结]GirlsInAI ML-diary 总 原博github链接-day20 初识kaggle 1-注册一个账号(由于被谷歌收购,因此可能需要梯子) 2-Competition - 学会看一 ...
- Python中集合类型的使用
集合类型 多个不重复元素的无序组合 集合类型的表示 建立非空集合的方式可以用{}来表示 采用set()来表示 集合类型的操作符 S|T 返回一个新集合,这个集合包含S与T中的所有元素. S-T 返回一 ...
- Linux就该这么学07学习笔记
参考链接:https://www.linuxprobe.com/chapter-07.html RAID磁盘冗余阵列 RAID 0 RAID 0技术把多块物理硬盘设备(至少两块)通过硬件或软件的方式串 ...
- spring启动图案修改(纯属好玩)
在resource目录下新建banner.txt(与application.properties或者application.yml同级) 在里面随便写自己的汉字图案就行了,比如我的: _ooOoo_ ...
- bzoj2346 & loj2632 [Baltic 2011]Lamp 最短路
题目传送门 https://lydsy.com/JudgeOnline/problem.php?id=2346 https://loj.ac/problem/2632 题解 普及组难度的题都要想十几分 ...
- 423 Locked
TortoiseSVN提交提示423 Locked的解决办法 . 此办法是阅读官方文档(TortoiseSVN-1.6.16-zh_CN.pdf) 4.21 锁部分提供的办法: 首先选择选择要提交的文 ...
- python在windows中运行文件
"d:Program Files\python35\python.exe" hello.txt
- 初识java-1.Java跨平台的原理
计算机只认识二进制的机器指令,而且不同的平台的计算机的机器指令不同.Java中将程序员编写的源码文件编译成字节码文件,在不同的计算机平台上安装不同的虚拟机,虚拟机将同一份字节码文件解释为不同的机器指令 ...
- uiautomator python版本
摘要: 利用jsonrpc技术直接包装uiautomator,调用uiautomator的api在本地直接编写脚本,然后运行测试case,这样比用Java写,然后再打包,runcase要简单的多,关键 ...