
Logistic回归应用-预测马的死亡率
Logistic回归应用-预测马的死亡率
本文所有代码均来自《机器学习实战》,数据也是
本例中的数据有以下几个特征:
- 部分指标比较主观、难以很好的定量测量,例如马的疼痛级别
- 数据集中有30%的数据是缺失的,例如:
如何处理数据缺失情况
数据是很宝贵的,对于有缺失的数据我们不能直接丢弃,而应该想办法将其修补后再利用起来
常用的方法有:
- 使用可用样本中该特征的均值来填补缺失样本中缺失特征的值
- 使用特殊值来填补缺失值,如-1
- 忽略有缺失值的样本
- 使用相似样本的均值填补缺失值
- 使用另外的机器学习算法来预测缺失值
但如果是Label信息丢失的话,一个简单的办法就是将该data丢弃,因为Label和attributes不一样,很难确定采用某个合适的值来替换缺失值。但是这种方法在类似KNN这样的、样本数量和样本完整度对结果有较为明显影响的算法中就不太好了。
回到本例,这里是采用了将缺失数据置换为0的操作。因为在Logistic回归的梯度下降法中,如果某个样本的一个attribute为0的话,那么就不使用它进行weights的更新了,这显然是一种很好的结果。另外,由于sigmoid(0)=0.5,既不偏向0也不偏向1,所以这个特征设置为0的话,该特征不会对结果的预测产生偏向性。
这是未处理的数据:
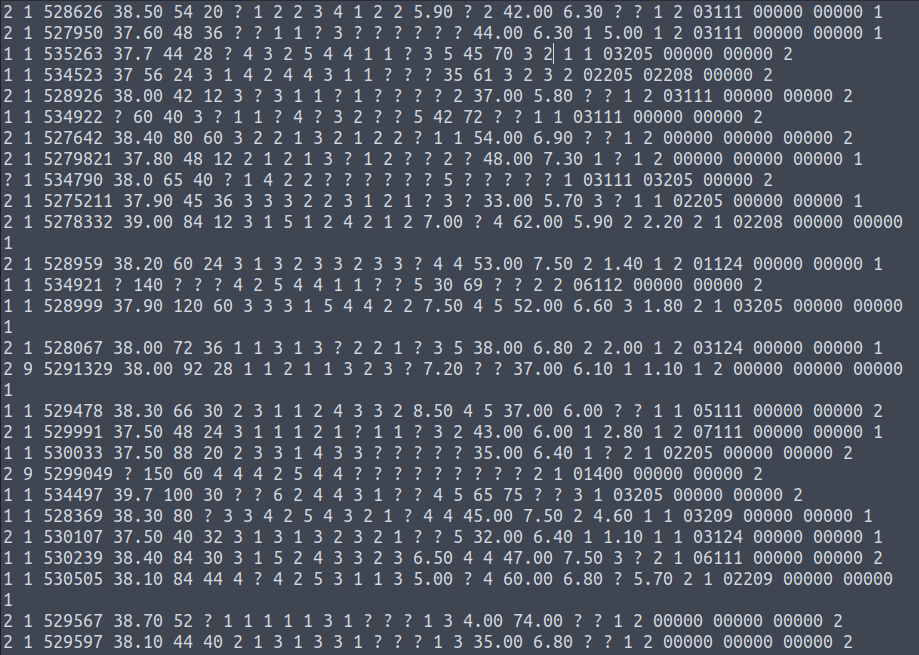
这是处理后的数据:

关于每个attribute代表什么意思,可以在这个网站上查到:http://archive.ics.uci.edu/ml/datasets/Horse+Colic。反正就是关于马的一些特征,由上图我们可以看到,这里我们并没有使用原数据中的全部特征,只选了一部分。
将Logistic回归用于分类
#用于返回分类结果(0或1)

def classifyVector(inX, weights):

    prob = sigmoid(sum(inX*weights))

    if prob > 0.5: return 1.0

    else: return 0.0

def colicTest():

    #训练集和测试集

    frTrain = open('horseColicTraining.txt'); frTest = open('horseColicTest.txt')

    trainingSet = []; trainingLabels = []

    #调用训练集进行训练

    for line in frTrain.readlines():

        currLine = line.strip().split('\t')

        lineArr =[]

        #一共有21个特征

        for i in range(21):

            #lineArr以数组形式保存由字符转换为浮点数的一条数据

            lineArr.append(float(currLine[i]))

        trainingSet.append(lineArr)

        trainingLabels.append(float(currLine[21]))

    trainWeights = stocGradAscent1(array(trainingSet), trainingLabels, 1000)

    errorCount = 0; numTestVec = 0.0

    #调用测试集进行测试

    for line in frTest.readlines():

        numTestVec += 1.0

        currLine = line.strip().split('\t')

        lineArr =[]

        for i in range(21):

            lineArr.append(float(currLine[i]))

        if int(classifyVector(array(lineArr), trainWeights))!= int(currLine[21]):

            errorCount += 1

    errorRate = (float(errorCount)/numTestVec)#返回误差率

    print("the error rate of this test is: %f" % errorRate)

    return errorRate
完整代码(实现+测试)如下:
'''

Created on Oct 27, 2010

Logistic Regression Working Module

@author: Peter

'''

'''

注意,本例中默认data在testSet.txt中且有两个attributes,

使用该模型的时候要注意根据实际使用的attributes个数修改代码

'''

from numpy import *

def loadDataSet():#加载数据

    dataMat = []; labelMat = []

    fr = open('testSet.txt')

    for line in fr.readlines():

        lineArr = line.strip().split()

        #Python strip() 方法用于移除字符串头尾指定的字符(默认为空格)或字符序列。

        #注意,在这里为data添加了1的一列

        dataMat.append([1.0, float(lineArr[0]), float(lineArr[1])])

        #数据有两个attributes

        labelMat.append(int(lineArr[2]))

    return dataMat,labelMat

def sigmoid(inX):

    return 1.0/(1+exp(-inX))

#梯度下降方法

def gradAscent(dataMatIn, classLabels):

    #转换为numpy矩阵类型,便于优化和并行计算

    dataMatrix = mat(dataMatIn)             #convert to NumPy matrix

    labelMat = mat(classLabels).transpose() #convert to NumPy matrix

    #将Label转置为列向量

    m,n = shape(dataMatrix)#m行n列

    alpha = 0.001#学习速度

    maxCycles = 500#最大学习步数

    weights = ones((n,1))#将来的输出

    for k in range(maxCycles):              #heavy on matrix operations

        h = sigmoid(dataMatrix*weights)     #matrix mult

        error = (labelMat - h)              #vector subtraction

        weights = weights + alpha * dataMatrix.transpose()* error #matrix mult

    return weights

def plotBestFit(weights):

    import matplotlib.pyplot as plt

    dataMat,labelMat=loadDataSet()#加载源数据,用于画图

    dataArr = array(dataMat)#将data向量化

    n = shape(dataArr)[0] #n为data的个数

    xcord1 = []; ycord1 = []

    xcord2 = []; ycord2 = []

    #给data分类

    for i in range(n):

        if int(labelMat[i])== 1:

            xcord1.append(dataArr[i,1]); ycord1.append(dataArr[i,2])

        else:

            xcord2.append(dataArr[i,1]); ycord2.append(dataArr[i,2])

    fig = plt.figure()

    ax = fig.add_subplot(111)

    #用不同的颜色画出来

    ax.scatter(xcord1, ycord1, s=30, c='red', marker='s')

    ax.scatter(xcord2, ycord2, s=30, c='green')

    #arange([start,] stop[, step,], dtype=None)

    #根据start与stop指定的范围以及step设定的步长,生成一个 ndarray。

    '''

    这一段是在干什么呢?其实就是想要画一条直线出来,但是只能画点,由点组成线

    '''

    x = arange(-3.0, 3.0, 0.1)

    y = (-weights[0]-weights[1]*x)/weights[2]

    ax.plot(x, y)

    plt.xlabel('X1'); plt.ylabel('X2');

    plt.show()

#随机梯度下降法,只对整个数据集迭代了一次,显然不够

def stocGradAscent0(dataMatrix, classLabels):

    m,n = shape(dataMatrix)

    alpha = 0.01

    weights = ones(n)   #initialize to all ones

    for i in range(m):

        h = sigmoid(sum(dataMatrix[i]*weights))

        error = classLabels[i] - h

        #这里其实不是真正的随机,样本是按顺序取的

        weights = weights + alpha * error * dataMatrix[i]

    return weights

#改进的随机梯度下降法

def stocGradAscent1(dataMatrix, classLabels, numIter=150):

    m,n = shape(dataMatrix)

    weights = ones(n)   #initialize to all ones

    for j in range(numIter):#对样本迭代150次

        dataIndex = list(range(m))#dataIndex保存了所有在本次迭代中还没有使用过的data

        for i in range(m):

            '''

            改进1:学习速度在每次迭代后都会调整,越往后学习速度越小,这会缓解在最优点附近的波动.

            由于我们在alpha之后加了一个常数,这使得alpha即使再迭代也不会减小到0.

            在降低alpha的函数中,j是迭代次数,i是data下标,这样可以避免参数的严格下降

            '''

            alpha = 4/(1.0+j+i)+0.0001    #apha decreases with iteration, does not

            #改进2:随机选择用来计算的data

            randIndex = int(random.uniform(0,len(dataIndex)))#go to 0 because of the constant

            h = sigmoid(sum(dataMatrix[randIndex]*weights))

            error = classLabels[randIndex] - h

            weights = weights + alpha * error * dataMatrix[randIndex]

            del(dataIndex[randIndex])

    return weights

#用于返回分类结果(0或1)

def classifyVector(inX, weights):

    prob = sigmoid(sum(inX*weights))

    if prob > 0.5: return 1.0

    else: return 0.0

def colicTest():

    #训练集和测试集

    frTrain = open('horseColicTraining.txt'); frTest = open('horseColicTest.txt')

    trainingSet = []; trainingLabels = []

    #调用训练集进行训练

    for line in frTrain.readlines():

        currLine = line.strip().split('\t')

        lineArr =[]

        #一共有21个特征

        for i in range(21):

            #lineArr以数组形式保存由字符转换为浮点数的一条数据

            lineArr.append(float(currLine[i]))

        trainingSet.append(lineArr)

        trainingLabels.append(float(currLine[21]))

    trainWeights = stocGradAscent1(array(trainingSet), trainingLabels, 1000)

    errorCount = 0; numTestVec = 0.0

    #调用测试集进行测试

    for line in frTest.readlines():

        numTestVec += 1.0

        currLine = line.strip().split('\t')

        lineArr =[]

        for i in range(21):

            lineArr.append(float(currLine[i]))

        if int(classifyVector(array(lineArr), trainWeights))!= int(currLine[21]):

            errorCount += 1

    errorRate = (float(errorCount)/numTestVec)#返回误差率

    print("the error rate of this test is: %f" % errorRate)

    return errorRate

#马类问题的测试接口

def multiTest():

    #重复执行10次以获取模型分类的平均误差

    numTests = 10; errorSum=0.0

    for k in range(numTests):

        errorSum += colicTest()

    print ("after %d iterations the average error rate is: %f" % (numTests, errorSum/float(numTests)))

dataArr,labelMat=loadDataSet()

weights=gradAscent(dataArr,labelMat)

print("梯度下降法:")

#getA()是numpy的一个函数,作用是将矩阵转成一个ndarray,getA()函数和mat()函数的功能相反,是将一个矩阵转化为数组。

plotBestFit(weights.getA())

print("随机梯度下降法")

weights2=stocGradAscent0(array(dataArr),labelMat)

plotBestFit(weights2)

print("一次随机梯度下降很可能是得不到最优结果的")

print("改进的随机梯度下降法")

weights3=stocGradAscent1(array(dataArr),labelMat)

plotBestFit(weights3)

print("马类问题")

multiTest()
Logistic回归应用-预测马的死亡率的更多相关文章
- Logistic Regression 用于预测马是否生病
1.利用Logistic regression 进行分类的主要思想 根据现有数据对分类边界线建立回归公式,即寻找最佳拟合参数集,然后进行分类. 2.利用梯度下降找出最佳拟合参数 3.代码实现 # -* ...
- 【Machine Learning in Action --5】逻辑回归(LogisticRegression)从疝气病预测病马的死亡率
背景:使用Logistic回归来预测患有疝气病的马的存活问题,这里的数据包括368个样本和28个特征,疝气病是描述马胃肠痛的术语,然而,这种病并不一定源自马的胃肠问题,其他问题也可能引发疝气病,该数据 ...
- 第五章:Logistic回归
本章内容 □sigmod函数和logistic回归分类器 □最优化理论初步□梯度下降最优化算法□数据中的缺失项处理 这会是激动人心的一章,因为我们将首次接触到最优化算法.仔细想想就会发现,其实我们日常 ...
- 【机器学习实战】第5章 Logistic回归
第5章 Logistic回归 Logistic 回归 概述 Logistic 回归虽然名字叫回归,但是它是用来做分类的.其主要思想是: 根据现有数据对分类边界线建立回归公式,以此进行分类. 须知概念 ...
- 机器学习实践之Logistic回归
关于本文说明,本人原博客地址位于http://blog.csdn.net/qq_37608890,本文来自笔者于2017年12月17日 19:18:31所撰写内容(http://blog.cs ...
- 机器学习实战(Machine Learning in Action)学习笔记————05.Logistic回归
机器学习实战(Machine Learning in Action)学习笔记————05.Logistic回归 关键字:Logistic回归.python.源码解析.测试作者:米仓山下时间:2018- ...
- 机器学习算法( 五、Logistic回归算法)
一.概述 这会是激动人心的一章,因为我们将首次接触到最优化算法.仔细想想就会发现,其实我们日常生活中遇到过很多最优化问题,比如如何在最短时间内从A点到达B点?如何投入最少工作量却获得最大的效益?如何设 ...
- 机器学习实战之Logistic回归
Logistic回归一.概述 1. Logistic Regression 1.1 线性回归 1.2 Sigmoid函数 1.3 逻辑回归 1.4 LR 与线性回归的区别 2. LR的损失函数 3. ...
- 【机器学习实战】第5章 Logistic回归(逻辑回归)
第5章 Logistic回归 <script type="text/javascript" src="http://cdn.mathjax.org/mathjax/ ...
随机推荐
- html5 代码画兰博基尼跑车,6不6你说的算!
源代码下方 由于本人喜爱html5,无聊所画: 画图需要掌握; 1.画布,画笔,画圆,给画笔添加颜色.(注:掌握这几点,你就可以称霸画图界了.) 虽然没有画画天赋,但代码写的也是溜溜滴!(注:此图没有 ...
- assertion的用法
一.assertion的语法和语义 在软件开发中,assertion是一种经典的调试.测试方式,本文将深入解析assertion功能的使用以及其设计理念,并给出相关的例子. 清软国际java学 ...
- 套接字I/O函数write/read writev/readv send/recv sendto/recvfrom sendmsg/recvmsg
函数原型 read/write系原型 #include <unistd.h> ssize_t read(int fd, void *buf, size_t count); #include ...
- Arch linux(UEFI+GPT)安装及后续优化教程
Arch Linux安装过程中需要从远程存储库获取软件包,电脑需要有效的互联网连接. 1.联网 查看是否有网 ping www.baidu.com 同步时间 timedatectl set-ntp t ...
- SpringMVC详解一、@RequestMapping注解与Controller接收参数
SpringMVC详解一.@RequestMapping注解与Controller接收参数 https://blog.csdn.net/mxcsdn/article/details/80719258 ...
- leetcode-easy-string- 8 String to Integer (atoi)
mycode 98.26% 易错点: while循环式,and判断的地方先判断下标会不会超出范围 class Solution(object): def myAtoi(self, str): &qu ...
- hibernate注意
1.设置id <id name="ID"> <!-- ????????????????? --> <generator class="ide ...
- Serializable 和 Parcelable 的区别?
1.在使用内存的时候,Parcelable 类比 Serializable 性能高,所以推荐使用 Parcelable 类.2.Serializable 在序列化的时候会产生大量的临时变量,从而引起频 ...
- JAVA基础面试汇总
一.基础知识:1.JVM.JRE和JDK的区别: JVM(Java Virtual Machine):java虚拟机,用于保证java的跨平台的特性. java ...
- 关系代数(Relation Algebra)与SQL语句的对应关系
SQL语句的执行一般是先翻译为关系代数再被执行的(能有效提高执行速度),所以我们有必要 了解关系代数与SQL语句间的对应关系. 就像高中代数由+-*/和数字组成,关系代数是由union.interse ...