
RDD练习:词频统计
一、词频统计:
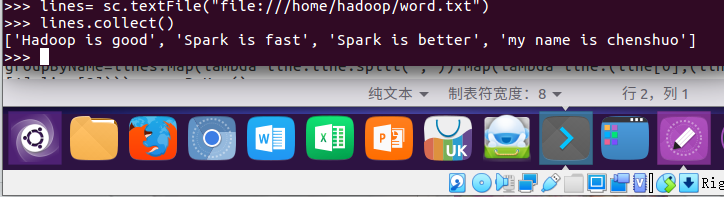
1.读文本文件生成RDD lines
lines=sc.textFile("file:///home/hadoop/word.txt")   #读取本地文件

lines.collect()
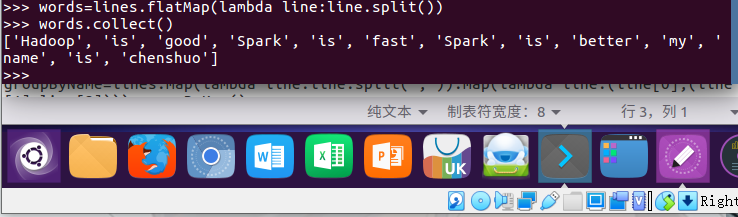
2.将一行一行的文本分割成单词 words flatmap()
words=lines.flatMap(lambda line:line.split())   #划分单词

words.collect()
3.全部转换为小写 lower()
words=words.map(lambda line:line.lower())   #变为小写

words.collect()

4.去掉长度小于3的单词 filter()
words=words.filter(lambda word:len(word)>3)

words.collect()

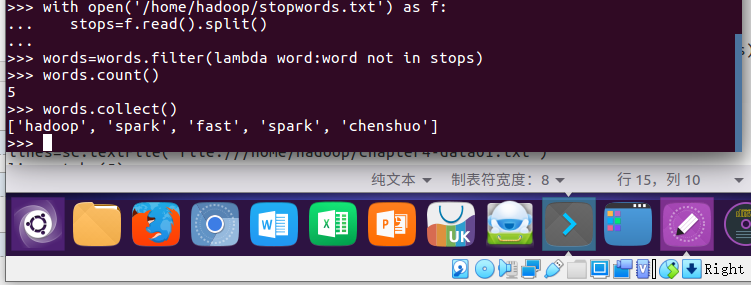
5.去掉停用词
with open('/home/hadoop/stopwords.txt')

     stops=f.read().split()

words=words.filter(lambda word:word not in stops)

words.count()

words.collect()
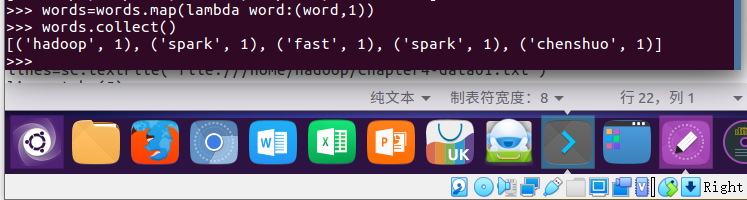
6.转换成键值对 map()
words=words.map(lambda word:(word,1))

words.collect()
7.统计词频 reduceByKey()
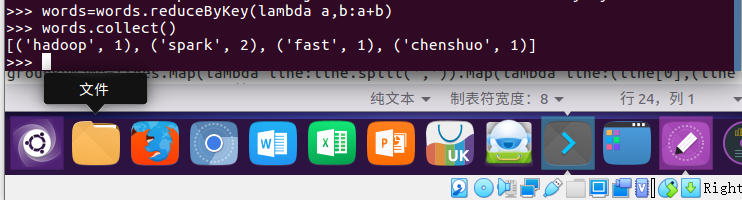
words=words.reduceByKey(lambda a,b:a+b)

words.collect()
二、学生课程分数 groupByKey()
-- 按课程汇总全总学生和分数
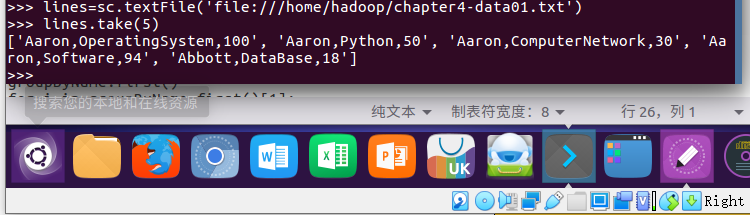
lines = sc.textFile('file:///home/hadoop/chapter4-data01.txt')

lines.take(5)
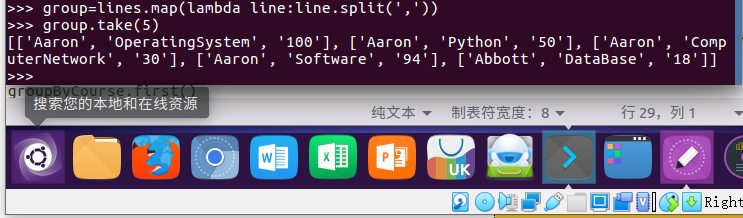
1. 分解出字段 map()
group=lines.map(lambda line:line.split(','))

group.take(5)
2. 生成键值对 map()
group=lines.map(lambda line:line.split(',')).map(lambda line:(line[1],(line[0],line[2])))

group.take(5)

3. 按键分组
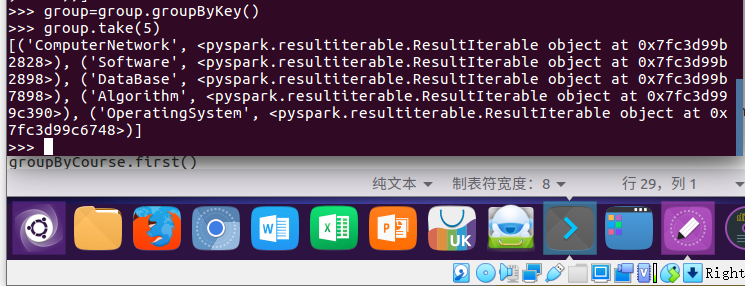
group=group.groupByKey()

group.take(5)
4. 输出汇总结果
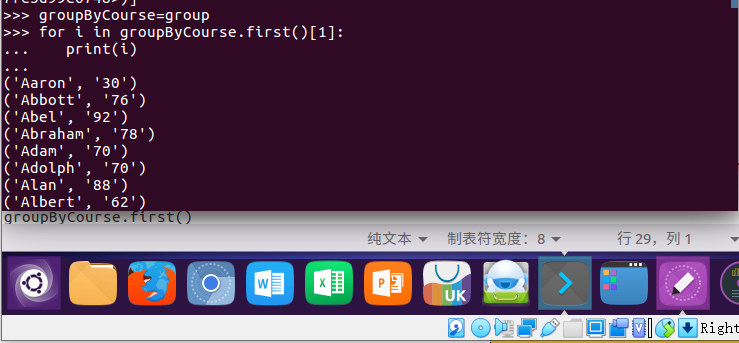
groupByCourse=group

for i in groupByCourse.first()[1]:

   print(i)
三、学生课程分数 reduceByKey()
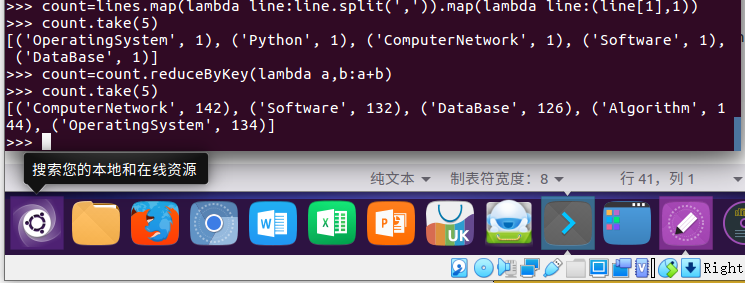
-- 每门课程的选修人数
count=lines.map(lambda line:line.split(',')).map(lambda line:(line[1],1))

count=count.reduceByKey(lambda a,b:a+b)

count.take(5)
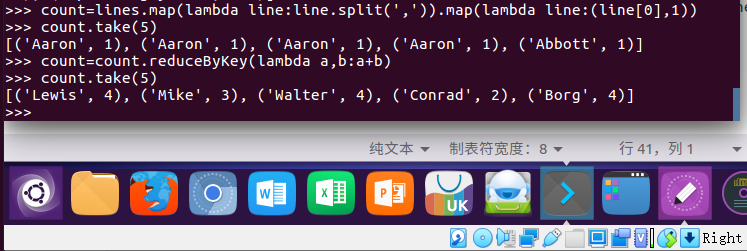
-- 每个学生的选修课程数
count=lines.map(lambda line:line.split(',')).map(lambda line:(line[0],1))

count=count.reduceByKey(lambda a,b:a+b)

count.take(5)
RDD练习:词频统计的更多相关文章
- 05 RDD练习:词频统计,学习课程分数
.词频统计: 1.读文本文件生成RDD lines 2.将一行一行的文本分割成单词 words flatmap() 3.全部转换为小写 lower() 4.去掉长度小于3的单词 filter() 5. ...
- 05 RDD练习:词频统计
一.词频统计: 1.读文本文件生成RDD lines 2.将一行一行的文本分割成单词 words flatmap() 3.全部转换为小写 lower() 4.去掉长度小于3的单词 filter() 5 ...
- 作业3-个人项目<词频统计>
上了一天的课,现在终于可以静下来更新我的博客了. 越来越发现,写博客是一种享受.来看看这次小林老师的“作战任务”. 词频统计 单词: 包含有4个或4个以上的字 ...
- C语言实现词频统计——第二版
原需求 1.读取文件,文件内包可含英文字符,及常见标点,空格级换行符. 2.统计英文单词在本文件的出现次数 3.将统计结果排序 4.显示排序结果 新需求: 1.小文件输入. 为表明程序能跑 2.支持命 ...
- c语言实现词频统计
需求: 1.设计一个词频统计软件,统计给定英文文章的单词频率. 2.文章中包含的标点不计入统计. 3.将统计结果以从大到小的排序方式输出. 设计: 1.因为是跨专业0.0···并不会c++和java, ...
- 软件工程第一次个人项目——词频统计by11061153柴泽华
一.预计工程设计时间 明确要求: 15min: 查阅资料: 1h: 学习C++基础知识与特性: 4-5h: 主函数编写及输入输出部分: 0.5h: 文件的遍历: 1h: 编写两种模式的词频统计函数: ...
- python瓦登尔湖词频统计
#瓦登尔湖词频统计: import string path = 'D:/python3/Walden.txt' with open(path,'r',encoding= 'utf-8') as tex ...
- Hadoop上的中文分词与词频统计实践 (有待学习 http://www.cnblogs.com/jiejue/archive/2012/12/16/2820788.html)
解决问题的方案 Hadoop上的中文分词与词频统计实践 首先来推荐相关材料:http://xiaoxia.org/2011/12/18/map-reduce-program-of-rmm-word-c ...
- pyspark进行词频统计并返回topN
Part I:词频统计并返回topN 统计的文本数据: what do you do how do you do how do you do how are you from operator imp ...
- 使用storm分别进行计数和词频统计
计数 直接上代码 public class LocalStormSumTopology { public static void main(String[] agrs) { //Topology是通过 ...
随机推荐
- ES6let const
let const class 类 import 引入模块 export 暴露接口 // var a = 10; // let b = 20; // const c = 30; var和let比 co ...
- R语言包和中文乱码解决方案
常用R语言包 --数据处理:lubridata ,plyr ,reshape2,stringr,formatR,mcmc: --机器学习:nnet,rpart,tree,party,lars,boos ...
- 记一次 .NET 某设备监控系统 死锁分析
一:背景 1. 讲故事 上周看了一位训练营朋友的dump,据朋友说他的程序卡死了,看完之后发现是一例经典的死锁问题,蛮有意思,这个案例算是学习 .NET高级调试 入门级的案例,这里和大家分享一下. 二 ...
- Proxmox VE镜像分析与定制
Proxmox VE(Proxmox Virtual Environment,简称PVE)是一个开源的服务器虚拟化环境Linux发行版,基于Debian,使用给予Ubuntu的定制内核.相比于其他虚拟 ...
- python之列表详解
一组数据的集合,可以重复, 集合不可以重复 列表的定义 a=[] list(a) 常用操作 # 增加ss.append(1)#加到末尾ss.insert(0,7)#list_name.insert(i ...
- python获取本地ip地址1
import socket def get_host_ip(): """ 查询本机ip地址 return: ip """ try: s = ...
- 为什么C++语言性能优越?
面试时被问到这个问题,发现自己一直以来理所当然的认为C++快,却没有具体分析原因.下面简单总结一下为什么快. 当我们编写程序时,我们需要将程序转换为计算机可以理解的机器语言.不同的语言有不同的执行机制 ...
- 一分钟使用Gitee,把本地项目放入gitee仓库中
一.先创建一个Gitee账号 首先需要自己去别的地方看创建一个空仓库,然后复制仓库的地址 省略... 现有本地有项目代码,远程空仓库一个,如何把本地项目代码推到远程仓库? 1.在项目根目录初始化 Gi ...
- odoo wizard界面显示带复选框列表及勾选数据获取
实践环境 Odoo 14.0-20221212 (Community Edition) 需求描述 如下图(非实际项目界面截图,仅用于介绍本文主题),打开记录详情页(form视图),点击某个按钮(图中的 ...
- 【问题解决】RabbitMQ启动出现epmd error for host xx.xx: nxdomain (non-existing domain)
问题描述 [k8s]或[普通容器]或[Linux]部署的RabbitMQ启动时出现了 epmd error for host xx.xx: nxdomain (non-existing domain) ...