
C# 模拟网站登陆
实现此功能首先需要借助一些抓包工具,对相应的网站登陆过程进行分析,此过程根据网站的不同,可能复杂,也可能很简单。常用的抓包工具FF下FireBug和IE下的HttpWatch.这两个工具很强大,以此工具获取的信息足以应对C#模拟网站登陆过程所需要的信息。抓包工具的使用教程网上很多,例如FireBug教程,在此就不做过多介绍。当然网上C# C/S结构模拟网站登陆信息也很多,但基本都是代码片段或是逻辑很复杂。所以把我实践的过程写下来与大家分享。此实验过程是基于模拟登陆校内而完成的。
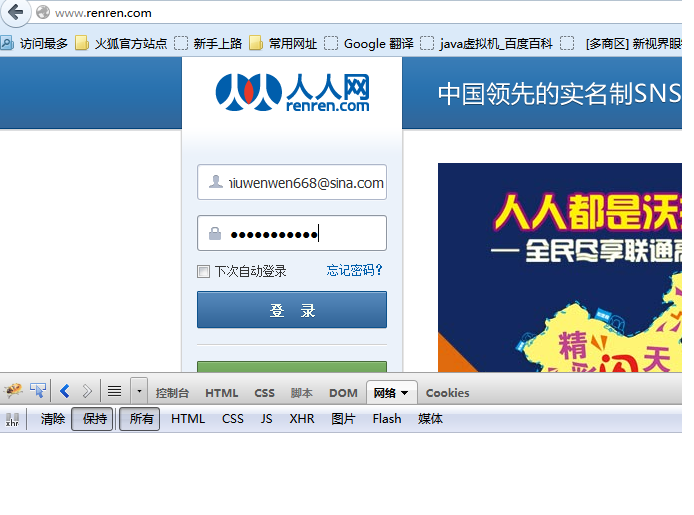
首先使用FireBug 获取登陆相关信息,在点登陆之前先把FireBug中信息清除,这样获取的信息就从点击登陆按钮后开始,以便后续分析,如下图:
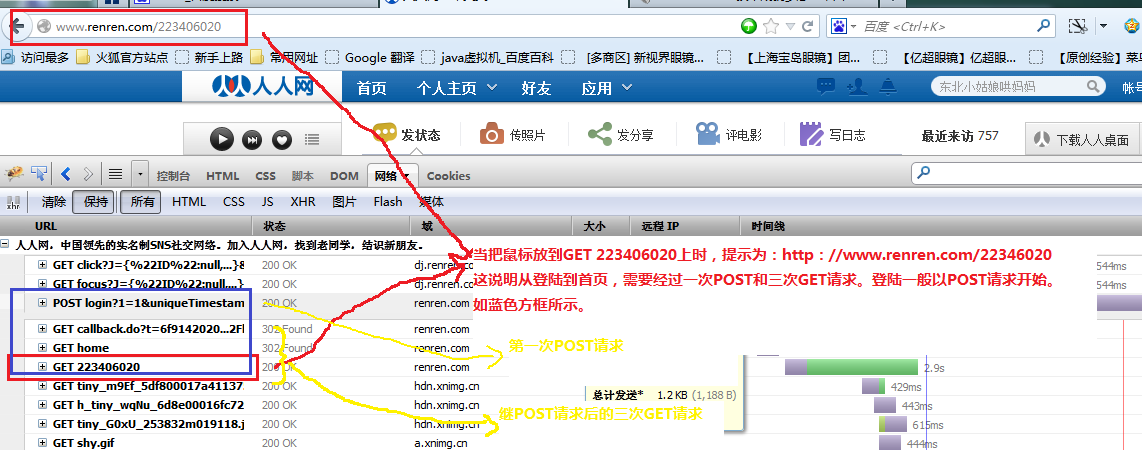
每次请求与下一次请求之间的联系就是每次请求后返回的Cookies数据,前一次的返回Cookie数据需要同下一次请求一同发送到服务器,这也是C#模拟网站登陆的关键。详见以下逻辑代码:
 using System;

 using System.Collections.Generic;

 using System.IO;

 using System.Linq;

 using System.Net;

 using System.Text;

 using System.Threading.Tasks;

 using System.Windows.Forms;

 namespace WebHelp

 {

     public class WebAutoLogin

     {

         #region 属性

         /// <summary>

         /// 登陆后返回的Html

         /// </summary>

         public static string ResultHtml

         {

             get;

             set;

         }

         /// <summary>

         /// 下一次请求的Url

         /// </summary>

         public static string NextRequestUrl

         {

             get;

             set;

         }

         /// <summary>

         /// 若要从远程调用中获取COOKIE一定要为request设定一个CookieContainer用来装载返回的cookies

         /// </summary>

         public static CookieContainer CookieContainer

         {

             get;

             set;

         }

         /// <summary>

         /// Cookies 字符创

         /// </summary>

         public static string CookiesString

         {

             get;

             set;

         }

         #endregion

         #region 方法

         /// <summary>

         /// 用户登陆指定的网站

         /// </summary>

         /// <param name="loginUrl"></param>

         /// <param name="account"></param>

         /// <param name="password"></param>

         public static void PostLogin(string loginUrl, string account, string password)

         {

             HttpWebRequest request = null;

             HttpWebResponse response = null;

             try

             {

                 string postdata = "email=" + account + "&password="+password+"&origURL=" + "http://www.renren.com/home" + "&domain=renren.com";//模拟请求数据,数据样式可以用FireBug插件得到。

                // string LoginUrl = "http://www.renren.com/PLogin.do";

                 request = (HttpWebRequest)WebRequest.Create(loginUrl);//实例化web访问类

                 request.Credentials = CredentialCache.DefaultCredentials;

                 request.Method = "POST";//数据提交方式为POST

                 request.ContentType = "application/x-www-form-urlencoded";    //模拟头

                 request.AllowAutoRedirect = false;   // 不用需自动跳转

                 //必须设置CookieContainer存储请求返回的Cookies

                 if (CookieContainer != null)

                 {

                     request.CookieContainer = CookieContainer;

                 }

                 else

                 {

                     request.CookieContainer = new CookieContainer();

                     CookieContainer = request.CookieContainer;

                 }

                 request.KeepAlive = true;

                 //提交请求

                 byte[] postdatabytes = Encoding.UTF8.GetBytes(postdata);

                 request.ContentLength = postdatabytes.Length;

                 Stream stream;

                 stream = request.GetRequestStream();

                 //设置POST 数据

                 stream.Write(postdatabytes, , postdatabytes.Length);

                 stream.Close();

                 //接收响应

                 response = (HttpWebResponse)request.GetResponse();

                 //保存返回cookie

                 response.Cookies = request.CookieContainer.GetCookies(request.RequestUri);

                 CookieCollection cook = response.Cookies;

                 string strcrook = request.CookieContainer.GetCookieHeader(request.RequestUri);

                 CookiesString = strcrook;

                 //取下一次GET跳转地址

                 StreamReader sr = new StreamReader(response.GetResponseStream(), Encoding.UTF8);

                 string content = sr.ReadToEnd();

                 sr.Close();

                 request.Abort();

                 response.Close();

                 //依据登陆成功后返回的Page信息,求出下次请求的url

                 //每个网站登陆后加载的Url和顺序不尽相同,以下两步需根据实际情况做特殊处理,从而得到下次请求的URL

                 string[] substr = content.Split(new char[] { '"' });

                 NextRequestUrl = substr[];

             }

             catch (WebException ex)

             {

                 MessageBox.Show(string.Format("登陆时出错,详细信息:{0}", ex.Message));

             }

         }

         /// <summary>

         /// 获取用户登陆后下一次请求返回的内容

         /// </summary>

         public static void GetPage()

         {

             HttpWebRequest request = null;

             HttpWebResponse response = null;

             try

             {

                 request = (HttpWebRequest)WebRequest.Create(NextRequestUrl);

                 request.Credentials = CredentialCache.DefaultCredentials;

                 request.Method = "GET";

                 request.KeepAlive = true;

                 request.Headers.Add("Cookie:" + CookiesString);

                 request.CookieContainer = CookieContainer;

                 request.AllowAutoRedirect = false;

                 response = (HttpWebResponse)request.GetResponse();

                 //设置cookie

                 CookiesString = request.CookieContainer.GetCookieHeader(request.RequestUri);

                 //取再次跳转链接

                 StreamReader sr = new StreamReader(response.GetResponseStream(), Encoding.UTF8);

                 string ss = sr.ReadToEnd();

                 sr.Close();

                 request.Abort();

                 response.Close();

                 //依据登陆成功后返回的Page信息,求出下次请求的url

                 //每个网站登陆后加载的Url和顺序不尽相同,以下两步需根据实际情况做特殊处理,从而得到下次请求的URL

                 string[] substr = ss.Split(new char[] { '"' });

                 NextRequestUrl = substr[];

                 ResultHtml = ss;

             }

             catch (WebException ex)

             {

                 MessageBox.Show(string.Format("获取页面HTML信息出错,详细信息:{0}",ex.Message));

             }

         }

         #endregion

     }

 }
以下是测试代码,POST请求一次,GET请求三次。最后得到登陆后加载的首页的HTML代码。当然,登陆后就可以依据当前的Cookie数据获取网站的其他子页面HTML。以下是登陆后加载的首页的HTML代码的逻辑。
   private void Form1_Load(object sender, EventArgs e)

         {

             WebAutoLogin.PostLogin("http://www.renren.com/PLogin.do", "niuwenwen668@sina.com", "xxxxxxx");

             WebAutoLogin.GetPage();

             WebAutoLogin.GetPage();

             WebAutoLogin.GetPage();

             webBrowser1.DocumentText = WebAutoLogin.ResultHtml;

         }
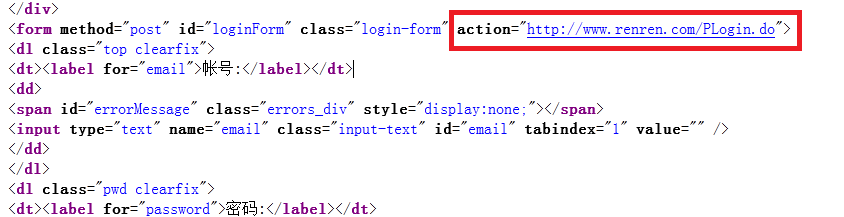
第一次POST数据的URL为登陆提交数据的页面,此地址不一定能在抓包工具中得到,这就需要分析,方法很多(网上很多),例如查看登陆页面源码等。
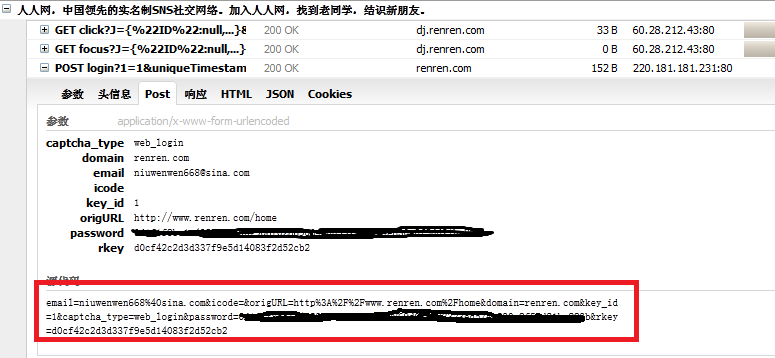
POST提交的数据可以在抓包工具中得到,以下是FireBug中得到的信息:
把代码Copy执行以下,自动登录成功了吧!!
好了,就这些了,此过程中就是每次请求都延续应用前一次请求返回的Cookie数据,只要这步原理理解,此过程也就没有什么难度了。
C# 模拟网站登陆的更多相关文章
- python urllib2 模拟网站登陆
python urllib2 模拟网站登陆 1. 可用浏览器先登陆,然后查看网页源码,分析登录表单 2. 使用python urllib2,cookielib 模拟网页登录 import urllib ...
- python模拟网站登陆-滑动验证码
普通滑动验证 以http://admin.emaotai.cn/login.aspx为例这类验证码只需要我们将滑块拖动指定位置,处理起来比较简单.拖动之前需要先将滚动条滚动到指定元素位置. impor ...
- C# 模拟网站登陆并截图
1.在窗体上加一个按钮,为按钮添加点击事件 private void button1_Click(object sender, EventArgs e) { Bitmap m_Bitmap = Web ...
- 模拟Post登陆带验证码的网站
前言: 作者在一个项目需求 模拟用户登陆,获取该用户的订单记录. 该系统需要用户名,密码,验证码 (验证码为正楷的数字4位),于是参考网络一些文章,并进行了很多测试,总结步骤如下: 步骤1 : 通过h ...
- cookielib和urllib2模块相结合模拟网站登录
1.cookielib模块 cookielib模块的主要作用是提供可存储cookie的对象,以便于与urllib2模块配合使用来访问Internet资源.例如可以利用 本模块的CookieJar类的对 ...
- curl模拟自动登陆&采集网页数据
<!DOCTYPE> <html> <head> <meta http-equiv="Content-Type" content=&quo ...
- HttpClient4的使用,模拟浏览器登陆新浪微博,发表微博和文字+图片微博
HttpClient4,最原始的需求就是使用其来模拟浏览器想服务器发起http请求,当然,他的功能不止于此,但是我需要的就是这个功能而已,jdk也有其自带的类似的api:UrlConnection,效 ...
- Java模拟新浪微博登陆抓取数据
前言: 兄弟们来了来了,最近有人在问如何模拟新浪微博登陆抓取数据,我听后默默地抽了一口老烟,暗暗的对自己说,老汉是时候该你出场了,所以今天有时间就整理整理,浅谈一二. 首先: 要想登陆新浪微博需要 ...
- jQuery数字滚动(模拟网站人气、访问量递增)原创
插件描述:实现数字上下滚动,模拟网站人气.访问量递增的动画效果,兼容性如下: 使用方法 $(el).runNum(val,params); 参数详解 val:数值型(默认70225800): pa ...
随机推荐
- Web Api 的 路由机制
ASP.NET Web API 是一种框架,用于轻松构建可以访问多种客户端(包括浏览器和移动设备)的 HTTP 服务. ASP.NET Web API 是一种用于在 .NET Framework 上构 ...
- Python全栈开发之13、CSS
一.css简介 CSS 是 Cascading Style Sheets的缩写,用来设计网页的样式布局,以及大小来适应不同的屏幕等,使网页的样式和网页数据分离, 二.导入css 导入css有4种方式: ...
- atomikos + druid 连接超时失效
atomikos + druid 连接超时失效,需要多次连接才能成功. 首次连接会报异常: 2018-01-08 16:58:12 DEBUG [com.jpcar.model.dao.jpcar.A ...
- Bootstrap--响应式导航条布局
<!DOCTYPE html> <html> <head> <meta name="viewport" content="wid ...
- 基于 Laravel 开发博客应用系列 —— Homestead 和 Laravel 安装器
1.Homestead 从主机操作系统的控制台中(Windows 中被称作命令提示符,Linux 中被称作终端),你可以轻松通过不带参数的homestead 命令查看所有有效的 Homestead 命 ...
- CSUOJ 1901 赏赐 OR 灾难 单调栈
Description 大G南征北战终于打下了大片土地成立了G国,大G在开国大典上传召帮助自己南征北战的三大开国元勋小A,小B,小C进殿,并要赏赐三人大量宝物以显示天恩浩荡.大G在征服其他国家的时候抢 ...
- Centos7 如何减少/home分区,扩大/root分区
把/home内容备份,然后将/home文件系统所在的逻辑卷删除,扩大/root文件系统,新建/home:tar cvf /tmp/home.tar /home #备份/home umount /hom ...
- centos+uwsgi+nginx+python+django服务器安装配置
1.ssh登录后使用fdisk –l查看需要格式化硬盘的名称: 2.运行fdisk /dev/vdb,对数据盘进行分区,按照提示,依次输入n,p,1,两次回车,wq,分区开始.(注意数据盘的名称,和阿 ...
- android viewStub
韩梦飞沙 韩亚飞 313134555@qq.com yue31313 han_meng_fei_sha 开发应用的时候,需要根据条件决定显示某个视图, 这个时候可以用ViewStub Stub ...
- 【推导】Codeforces Round #484 (Div. 2) C. Cut 'em all!
题意:给你一棵树,让你切掉尽可能多的边,使得产生的所有连通块都有偶数个结点. 对于一棵子树,如果它有奇数个结点,你再从里面怎么抠掉偶数结点的连通块,它都不会变得合法.如果它本来就有偶数个结点,那么你怎 ...