
Solr与MySQL查询性能对比
测试环境
本文简单对比下Solr与MySQL的查询性能速度。
测试数据量:10407608 Num Docs: 10407608
普通查询
这里对MySQL的查询时间都包含了从MySQL Server获取数据的时间。
在项目中一个最常用的查询,查询某段时间内的数据,SQL查询获取数据,30s左右
SELECT * FROM `tf_hotspotdata_copy_test` WHERE collectTime BETWEEN '2014-12-06 00:00:00' AND '2014-12-10 21:31:55';
对collectTime建立索引后,同样的查询,2s,快了很多。
Solr索引数据:
<!--Index Field for HotSpot-->

<field name="CollectTime" type="tdate" indexed="true" stored="true"/>

<field name="IMSI" type="string" indexed="true" stored="true"/>

<field name="IMEI" type="string" indexed="true" stored="true"/>

<field name="DeviceID" type="string" indexed="true" stored="true"/>
Solr查询,同样的条件,72ms
"status": 0,

    "QTime": 72,

    "params": {

      "indent": "true",

      "q": "CollectTime:[2014-12-06T00:00:00.000Z TO 2014-12-10T21:31:55.000Z]",

      "_": "1434617215202",

      "wt": "json"

    }
好吧,查询性能提高的不是一点点,用Solrj代码试试:
SolrQuery params = new SolrQuery();

params.set("q", timeQueryString);

params.set("fq", queryString);

params.set("start", 0);

params.set("rows", Integer.MAX_VALUE);

params.setFields(retKeys);

QueryResponse response = server.query(params);
Solrj查询并获取结果集,结果集大小为220296,返回5个字段,时间为12s左右。
为什么需要这么长时间?上面的"QTime"只是根据索引查询的时间,如果要从solr服务端获取查询到的结果集,solr需要读取stored的字段(磁盘IO),再经过Http传输到本地(网络IO),这两者比较耗时,特别是磁盘IO。
时间对比:
|
查询条件 |
时间 |
|
MySQL(无索引) |
30s |
|
MySQL(有索引) |
2s |
|
Solrj(select查询) |
12s |
如何优化?看看只获取ID需要的时间:
SQL查询只返回id,没有对collectTime建索引,10s左右:
SELECT id FROM `tf_hotspotdata_copy_test` WHERE collectTime BETWEEN '2014-12-06 00:00:00' AND '2014-12-10 21:31:55';
SQL查询只返回id,同样的查询条件,对collectTime建索引,0.337s,很快。
Solrj查询只返回id,7s左右,快了一点。
id Size: 220296
Time: 7340
时间对比:
|
查询条件(只获取ID) |
时间 |
|
MySQL(无索引) |
10s |
|
MySQL(有索引) |
0.337s |
|
Solrj(select查询) |
7s |
继续优化。。
关于Solrj获取大量结果集速度慢的一些类似问题:
http://stackoverflow.com/questions/28181821/solr-performance#
http://grokbase.com/t/lucene/solr-user/11aysnde25/query-time-help
http://lucene.472066.n3.nabble.com/Solrj-performance-bottleneck-td2682797.html
这个问题没有好的解决方式,基本的建议都是做分页,但是我们需要拿到大量数据做一些比对分析,做分页没有意义。
偶然看到一个回答,solr默认的查询使用的是"/select" request handler,可以用"/export" request handler来export结果集,看看solr对它的说明:
It's possible to export fully sorted result sets using a special rank query parser and response writer specifically designed to work together to handle scenarios that involve sorting and exporting millions of records. This uses a stream sorting techniquethat begins to send records within milliseconds and continues to stream results until the entire result set has been sorted and exported.
Solr中已经定义了这个requestHandler:
<requestHandler name="/export" class="solr.SearchHandler">

  <lst name="invariants">

    <str name="rq">{!xport}</str>

    <str name="wt">xsort</str>

    <str name="distrib">false</str>

  </lst>

  <arr name="components">

    <str>query</str>

  </arr>

</requestHandler>
使用/export需要字段使用docValues建立索引:
<field name="id" type="string" indexed="true" stored="true" required="true" multiValued="false" docValues="true"/>

<field name="CollectTime" type="tdate" indexed="true" stored="true" docValues="true"/>

<field name="IMSI" type="string" indexed="true" stored="true" docValues="true"/>

<field name="IMEI" type="string" indexed="true" stored="true" docValues="true"/>

<field name="DeviceID" type="string" indexed="true" stored="true" docValues="true"/>
使用docValues必须要有一个用来Sort的字段,且只支持下列类型:
Sort fields must be one of the following types: int,float,long,double,string
docValues支持的返回字段:
Export fields must either be one of the following types: int,float,long,double,string
使用Solrj来查询并获取数据:
        SolrQuery params = new SolrQuery();

        params.set("q", timeQueryString);

        params.set("fq", queryString);

        params.set("start", 0);

        params.set("rows", Integer.MAX_VALUE);

        params.set("sort", "id asc");

        params.setHighlight(false);

        params.set("qt", "/export");

        params.setFields(retKeys);

        QueryResponse response = server.query(params);
一个Bug:
org.apache.solr.client.solrj.impl.HttpSolrClient$RemoteSolrException: Error from server at http://192.8.125.30:8985/solr/hotspot: Expected mime type application/octet-stream but got application/json.
Solrj没法正确解析出结果集,看了下源码,原因是Solr server返回的ContentType和Solrj解析时检查时不一致,Solrj的BinaryResponseParser这个CONTENT_TYPE是定死的:
public class BinaryResponseParser extends ResponseParser {

    public static final String BINARY_CONTENT_TYPE = "application/octet-stream";
一时半会也不知道怎么解决这个Bug,还是自己写个Http请求并获取结果吧,用HttpClient写了个简单的客户端请求并解析json获取数据,测试速度:
    String url = "http://192.8.125.30:8985/solr/hotspot/export?q=CollectTime%3A[2014-12-06T00%3A00%3A00.000Z+TO+2014-12-10T21%3A31%3A55.000Z]&sort=id+asc&fl=id&wt=json&indent=true";

    long s = System.currentTimeMillis();

    SolrHttpJsonClient client = new SolrHttpJsonClient();

    SolrQueryResult result = client.getQueryResultByGet(url);

    System.out.println("Size: "+result.getResponse().getNumFound());

    long e = System.currentTimeMillis();

    System.out.println("Time: "+(e-s));
同样的查询条件获取220296个结果集,时间为2s左右,这样的查询获取数据的效率和MySQL建立索引后的效果差不多,暂时可以接受。
为什么使用docValues的方式获取数据速度快?
DocValues是一种按列组织的存储格式,这种存储方式降低了随机读的成本。
传统的按行存储是这样的:
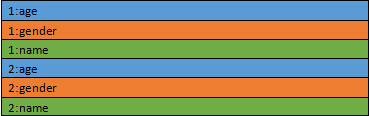
1和2代表的是docid。颜色代表的是不同的字段。
改成按列存储是这样的:
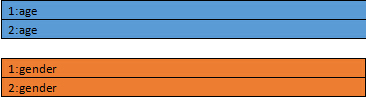
按列存储的话会把一个文件分成多个文件,每个列一个。对于每个文件,都是按照docid排序的。这样一来,只要知道docid,就可以计算出这个docid在这个文件里的偏移量。也就是对于每个docid需要一次随机读操作。
那么这种排列是如何让随机读更快的呢?秘密在于Lucene底层读取文件的方式是基于memory mapped byte buffer的,也就是mmap。这种文件访问的方式是由操作系统去缓存这个文件到内存里。这样在内存足够的情况下,访问文件就相当于访问内存。那么随机读操作也就不再是磁盘操作了,而是对内存的随机读。
那么为什么按行存储不能用mmap的方式呢?因为按行存储的方式一个文件里包含了很多列的数据,这个文件尺寸往往很大,超过了操作系统的文件缓存的大小。而按列存储的方式把不同列分成了很多文件,可以只缓存用到的那些列,而不让很少使用的列数据浪费内存。
注意Export fields只支持int,float,long,double,string这几个类型,如果你的查询结果只包含这几个类型的字段,那采用这种方式查询并获取数据,速度要快很多。
下面是Solr使用“/select”和“/export”的速度对比。
时间对比:
|
查询条件 |
时间 |
|
MySQL(无索引) |
30s |
|
MySQL(有索引) |
2s |
|
Solrj(select查询) |
12s |
|
Solrj(export查询) |
2s |
项目中如果用分页查询,就用select方式,如果一次性要获取大量查询数据就用export方式,这里没有采用MySQL对查询字段建索引,因为数据量每天还在增加,当达到亿级的数据量的时候,索引也不能很好的解决问题,而且项目中还有其他的查询需求。
分组查询
我们来看另一个查询需求,假设要统计每个设备(deviceID)上数据的分布情况:
用SQL,需要33s:
SELECT deviceID,Count(*) FROM `tf_hotspotdata_copy_test` GROUP BY deviceID;
同样的查询,在对CollectTime建立索引之后,只要14s了。
看看Solr的Facet查询,只要540ms,快的不是一点点。
SolrQuery query = new SolrQuery();

query.set("q", "*:*");

query.setFacet(true);

query.addFacetField("DeviceID");

QueryResponse response = server.query(query);

FacetField idFacetField = response.getFacetField("DeviceID");

List<Count> idCounts = idFacetField.getValues();

for (Count count : idCounts) {

    System.out.println(count.getName()+": "+count.getCount());

}
时间对比:
|
查询条件(统计) |
时间 |
|
MySQL(无索引) |
33s |
|
MySQL(有索引) |
14s |
|
Solrj(Facet查询) |
0.54s |
如果我们要查询某台设备在某个时间段上按“时”、“周”、“月”、“年”进行数据统计,Solr也是很方便的,比如以下按天统计设备号为1013上的数据:
    String startTime = "2014-12-06 00:00:00";

    String endTime = "2014-12-16 21:31:55";

    SolrQuery query = new SolrQuery();

    query.set("q", "DeviceID:1013");

    query.setFacet(true);

    Date start = DateFormatHelper.ToSolrSearchDate(DateFormatHelper.StringToDate(startTime));

    Date end = DateFormatHelper.ToSolrSearchDate(DateFormatHelper.StringToDate(endTime));

    query.addDateRangeFacet("CollectTime", start, end, "+1DAY");

    QueryResponse response = server.query(query);

    List<RangeFacet> dateFacetFields = response.getFacetRanges();

    for (RangeFacet facetField : dateFacetFields{

        List<org.apache.solr.client.solrj.response.RangeFacet.Count> dateCounts= facetField.getCounts();

        for (org.apache.solr.client.solrj.response.RangeFacet.Count count : dateCounts) {

            System.out.println(count.getValue()+": "+count.getCount());

        }

    }
这里为什么Solr/Lucene的Facet(聚合)查询会这么快呢?
想想Solr/Lucene的索引数据的方式就清楚了:倒排索引。对于某个索引字段,该字段下有哪几个值,对于每个值,对应的文档集合是建立索引的时候就清楚的,做聚合操作的时候“统计”下就知道结果了。
如果通过docValues建立索引,对于这类Facet查询会更快,因为这时候索引已经通过字段(列)分割好了,只需要去对应文件中查询统计就行了,如上文所述,通过“内存映射”,将该索引文件映射到内存,只需要在内存里统计下结果就出来了,所以就非常快。
水平拆分表:
由于本系统采集到的大量数据和“时间”有很大关系,一些业务需求根据“时间”来查询也比较多,可以按“时间”字段进行拆分表,比如按每月一张表来拆分,但是这样做应用层代码就需要做更多的事情,一些跨表的查询也需要更多的工作。综合考虑了表拆分和使用Solr来做索引查询的工作量后,还是采用了Solr。
总结:在MySQL的基础上,配合Lucene、Solr、ElasticSearch等搜索引擎,可以提高类似全文检索、分类统计等查询性能。
参考:
http://wiki.apache.org/solr/
https://lucidworks.com/blog/2013/04/02/fun-with-docvalues-in-solr-4-2/
Solr与MySQL查询性能对比的更多相关文章
- MySQL查询性能优化(精)
MySQL查询性能优化 MySQL查询性能的优化涉及多个方面,其中包括库表结构.建立合理的索引.设计合理的查询.库表结构包括如何设计表之间的关联.表字段的数据类型等.这需要依据具体的场景进行设计.如下 ...
- 170727、MySQL查询性能优化
MySQL查询性能优化 MySQL查询性能的优化涉及多个方面,其中包括库表结构.建立合理的索引.设计合理的查询.库表结构包括如何设计表之间的关联.表字段的数据类型等.这需要依据具体的场景进行设计.如下 ...
- 到底该不该使用存储过程 MySQL查询性能优化一则
到底该不该使用存储过程 看到<阿里巴巴java编码规范>有这样一条 关于这条规范,我说说我个人的看法 用不用存储过程要视所使用的数据库和业务场景而定的,不能因为阿里巴巴的技术牛逼,就视 ...
- MySQL查询性能优化七种武器之索引下推
前面已经讲了MySQL的其他查询性能优化方式,没看过可以去了解一下: MySQL查询性能优化七种武器之索引潜水 MySQL查询性能优化七种武器之链路追踪 今天要讲的是MySQL的另一种查询性能优化方式 ...
- MySQL优化技巧之五(mysql查询性能优化)
对于高性能数据库操作,只靠设计最优的库表结构.建立最好的索引是不够的,还需要合理的设计查询.如果查询写得很糟糕,即使库表结构再合理.索引再合适,也无法实现高性能.查询优化.索引优化.库表结构优化需要齐 ...
- MySQL查询性能优化---高性能(二)
转载地址:https://segmentfault.com/a/1190000011330649 避免向数据库请求不需要的数据 在访问数据库时,应该只请求需要的行和列.请求多余的行和列会消耗MySql ...
- MySQL查询缓存设置提高MySQL查询性能
首先看看MSYQL逻辑框架:图片来自高性能mysql 如果使用了QueryCache,当查询接收到一个和之前同样的查询,服务器将会从查询缓存中检索结果,而不是再次分析和执行相同的查询.这样就能大大提高 ...
- Oracle Spatial分区应用研究之一:分区与分表查询性能对比
1.名词解释 分区:将一张大表在物理上分成多个分区,逻辑上仍然是同一个表名. 分表:将一张大表拆分成多张小表,不同表有不同的表名. 两种数据组织形式的原理图如下: 图 1分表与分区的原理图 2.实验目 ...
- 《高性能MySQL》之MySQL查询性能优化
为什么查询会慢? 响应时间过长.如果把查询看做是一个任务,那么它由一系列子任务组成,每个子任务都会消耗一定的时间.如果要优化查询,实际上优化其子任务,要么消除其中一些子任务,要么减少子任务的执行次数, ...
随机推荐
- Généralement c'est un mélange qui me devient personnellement
Parmi mes plus grands problèmes personnels avec maisons de rue conventionnelles est en fait ils sont ...
- Eclipse中.calsspath文件解析
来自帅气的Sublime Text
- SpringMVC学习记录3
这次的主题 最近一直在学习SpringMVC..(这句话我已经至少写了3,4遍了....).这次的研究主要是RequestMappingHandlerAdapter中的各种ArgumentsResol ...
- Java基础——继承、接口
一个对象变量(例如,变量e)可以引用多种实际类型的现象被称为多态(polymorphism). 在运行时能够自动地选择调用哪个方法的现象称为动态绑定(dynamic binding). 在Java程序 ...
- Redis实战阅读笔记——第一章
Redis 实战 中文版 的20-21页看的人郁闷死了,最后看英文版才明白意思,哎,我理解能力差成这样了 其中,图 1-12 有错误,草,这个是英文版的错--应该是group:programming
- ZOJ Problem Set - 3329(概率DP)
One Person Game Time Limit: 1 Second Memory Limit: 32768 KB Special Judge There is a very ...
- solr 安装
1:solr简介 solr是一个开源的搜索引擎,是对lucene做了封装,对外提供类似于webservice接口, 可以使用http请求的方式对solr进行操作. lucene.solr.elasti ...
- 码云以及git使用
码云的使用方法以及git的连用 创建公钥的方法 打开码云,点击个人资料---->SSH公钥---->点击怎样生成公钥 SSH Keys ssh keys可以让你在你的电脑和Git@OSC知 ...
- Lisp永远成不了编程主流语言
Lisp语言是第二古老的高级编程语言.许多的黑客和开发者对Lisp推崇备至,Paul Graham甚至说"编程语言现在的发展,不过刚刚赶上1958年Lisp语言的水平". ...
- Hadoop基础思维导图