
SKLearn数据集API(二)
注:本文是人工智能研究网的学习笔记
计算机生成的数据集
用于分类任务和聚类任务,这些函数产生样本特征向量矩阵以及对应的类别标签集合。
| 数据集 | 简介 |
|---|---|
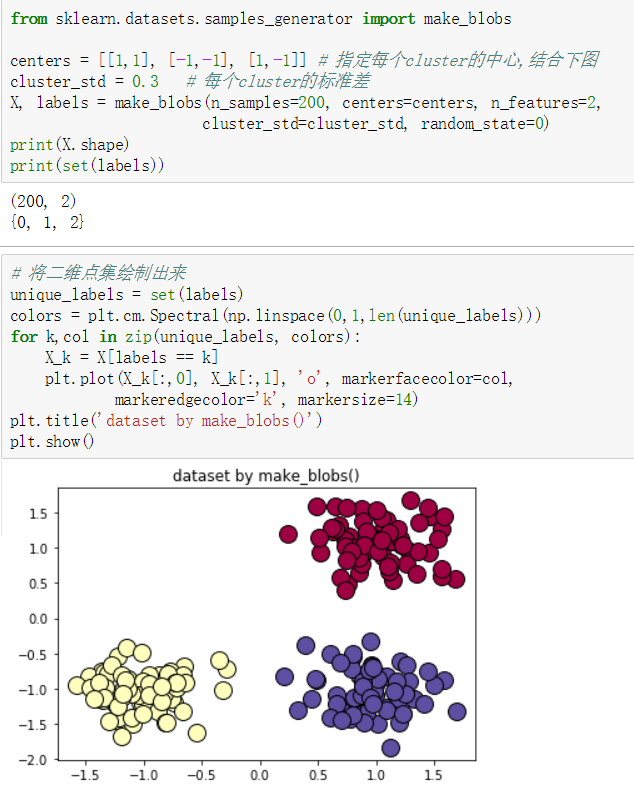
| make_blobs | 多类单标签数据集,为每个类分配一个或者多个正态分布的点集,提供了控制每个数据点的参数:中心点(均值),标准差,常用于聚类算法。 |
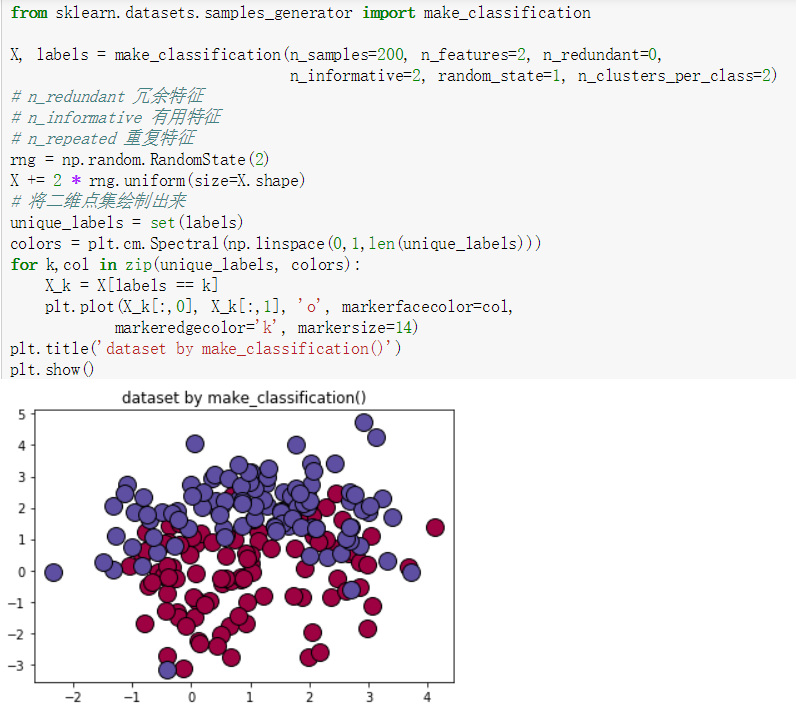
| make_classification | 多类单标签数据集,为每个类分配了一个或者多个正态分布的点集。提供了为数据集添加噪声的方式,包括维度相性,无效特征和冗余特征等。 |
| make_gaussian_quantiles | 将一个单高斯分布的点集活粉为两个数量均等的点集,作为两类。 |
| make_hastie_10_2 | 产生一个相似的二元分类器数据集,有10个维度。 |
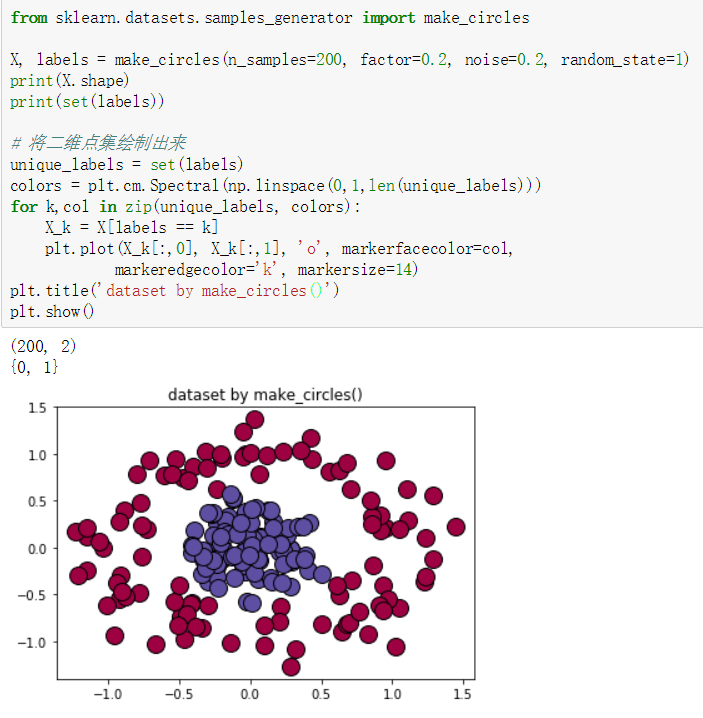
| make_circles/make_moons | 产生二维分类数据集来测试某些算法(e.g.centroid-based clustering或linear classfication)的性能。可以为数据集添加噪声,可以为二元分类器产生一些球形判决表面的数据。 |
用于多标签分类任务
| 数据集 | 简介 |
|---|---|
| make_multilabel_classification | 产生多类多标签随机样本,这些样本模拟了从很多话题的混合分布中抽取的词袋模型,每个文档的话题数量符合泊松分布,话题本身则从一个固定的随机分布中抽取出来,同样的,单词数量也是泊松分布抽取,句子则是从多项式抽取。 |
用于回归任务的
| 数据集 | 简介 |
|---|---|
| make_regression | 产生回归任务的数据集,期望目标输出是随机特征的稀疏随机线性组合,并且附带有噪声,它的有用的特征可能是不相关的,或者低秩的(引起目标值的变动的只有少量的集合特征) |
| make_sparse_uncorrelated | 产生四个特征的线性组合(固定参数)作为期望目标输出 |
| make_friedman1 | 采用了多项式和正弦变换 |
| make_friedman2 | 包含了特征的乘积和互换操作 |
| make_friedman3 | 类似于arctan变换 |
用于流行学习的
| 数据集 | 简介 |
|---|---|
| make_s_curve | 生成S型曲线数据集 |
| make_swiss_roll | 生成瑞士卷曲线数据集 |
用于因子分解的
| 数据集 | 简介 |
|---|---|
| make_low_rank_matrix | |
| make_sparse_coded_signal | |
| nake_spd_matrix | 产生的是随机的堆成的正定矩阵 |
| make_sparse_spd_matrix | 产生的是稀疏的堆成正定矩阵 |
make_blobs()
make_classification()
make_moons()

make_circles()
svmlight/libsvm格式的数据集
svmlight/libsvm的每一行样本的存放格式
<label> <feature-id>:<feature-value> <feature-id>:<feature-value>...
使用下面的方式导入该格式的数据集
X_train, y_train = sklearn.datasets.load_svmlight_file('train.txt')
还可以使用下面的方式将训练集和测试集一起导入,可以保证X_train和X_test有同样数目的特征
X_train, y_train, X_test, y_test = sklearn.datasets.load_svmlight_file(('train.txt', 'test.txt'))
SKLearn数据集API(二)的更多相关文章
- SKLearn数据集API(一)
注:本文是人工智能研究网的学习笔记 数据集一览 类型 获取方式 自带的小数据集 sklearn.datasets.load_ 在线下载的数据集 sklearn.datasets.fetch_ 计算机生 ...
- 【学习笔记】sklearn数据集与估计器
数据集划分 机器学习一般的数据集会划分为两个部分: 训练数据:用于训练,构建模型 测试数据:在模型检验时使用,用于评估模型是否有效 训练数据和测试数据常用的比例一般为:70%: 30%, 80%: 2 ...
- 机器学习笔记(四)--sklearn数据集
sklearn数据集 (一)机器学习的一般数据集会划分为两个部分 训练数据:用于训练,构建模型. 测试数据:在模型检验时使用,用于评估模型是否有效. 划分数据的API:sklearn.model_se ...
- sklearn——数据集调用及应用
忙了许久,总算是又想起这边还没写完呢. 那今天就写写sklearn库的一部分简单内容吧,包括数据集调用,聚类,轮廓系数等等. 自带数据集API 数据集函数 中文翻译 任务类型 数据规模 load_ ...
- Sklearn数据集与机器学习
sklearn数据集与机器学习组成 机器学习组成:模型.策略.优化 <统计机器学习>中指出:机器学习=模型+策略+算法.其实机器学习可以表示为:Learning= Representati ...
- sklearn数据集
数据集划分: 机器学习一般的数据集会划分为两个部分 训练数据: 用于训练,构建模型 测试数据: 在模型检验时使用,用于评估模型是否有效 sklearn数据集划分API: 代码示例文末! scikit- ...
- Civil 3D API二次开发学习指南
Civil 3D构建于AutoCAD 和 Map 3D之上,在学习Civil 3D API二次开发之前,您至少需要了解AutoCAD API的二次开发,你可以参考AutoCAD .NET API二次开 ...
- 用JSON-server模拟REST API(二) 动态数据
用JSON-server模拟REST API(二) 动态数据 上一篇演示了如何安装并运行 json server , 在这里将使用第三方库让模拟的数据更加丰满和实用. 目录: 使用动态数据 为什么选择 ...
- Express4.x API (二):Request (译)
写在前面 最近学习express想要系统的过一遍API,www.expressjs.com是express英文官网(进入www.epxressjs.com.cn发现也是只有前几句话是中文呀~~),所以 ...
随机推荐
- 外卖(food) & 洛谷4040宅男计划 三分套二分&贪心
food评测传送门 [题目描述] 叫外卖是一个技术活,宅男宅女们一直面对着一个很大的矛盾,如何以有限的金钱在宿舍宅得尽量久. 外卖店一共有 N 种食物,每种食物有固定的价钱 Pi 与保质期 Si ...
- JavaScript逻辑运算符
逻辑运算符 或与非:&& || ! ----------------------------------------------------------- ...
- 深拷贝数组 np.copy
数组对象自带了浅拷贝和深拷贝的方法,但是一般用深拷贝多一些: 代码如下: >>> a = np.ones((2,2)) >>> b = a >>> ...
- python学习之argparse模块的使用
以下内容主要来自:http://wiki.jikexueyuan.com/project/explore-python/Standard-Modules/argparse.html argparse ...
- shutdown系统调用
/* * Shutdown a socket. */ SYSCALL_DEFINE2(shutdown, int, fd, int, how) { int err, fput_needed; stru ...
- 并行运行多个python虚拟机
之前遇到一个问题,需要将场景服务这个模块拆分出来,用独立的一个线程去执行.使用独立的线程好处就是,逻辑写的可以相对简单粗暴点,不必考虑到大量的场景服务逻辑卡主线程的情况. 由于我们服务器之前是使用py ...
- MySQL 5.7.17 Group Relication(组复制)搭建手册【转】
本博文介绍了Group Replication的两种工作模式的架构.并详细介绍了Single-Master Mode的部署过程,以及如何切换到Multi-Master Mode.当然,文末给出了Gro ...
- springmvc与struts的区别
一.拦截机制 1.Struts2 a.Struts2框架是类级别的拦截,每次请求就会创建一个Action,和Spring整合时Struts2的ActionBean注入作用域是原型模式prototype ...
- XP远程连接Win10,提示【远程计算机需要网络级别身份验证,而您的计算机不支持该验证】
最近电脑安装了Win10系统,在办公室可以通过其他电脑远程,但是回去后使用自己的电脑(XP系统)进行远程提示失败, 提示[远程计算机需要网络级别身份验证,而您的计算机不支持该验证],然后上网查找资料, ...
- csslint在前端项目中的使用
大家都听说过jslint,eslint,不过你可能没见过csslint,你可能会问csslint有什么用,为什么今天要说csslint,是因为我在开发中遇到一个坑,其实之前不怎么使用csslint的, ...