
Windows环境下搭建Hadoop(2.6.0)+Hive(2.2.0)环境并连接Kettle(6.0)
前提:配置JDK1.8环境,并配置相应的环境变量,JAVA_HOME
一.Hadoop的安装
1.1 下载Hadoop (2.6.0) http://hadoop.apache.org/releases.html
1.1.1 下载对应版本的winutils(https://github.com/steveloughran/winutils)并将其bin目录下的文件,全部复制到hadoop的安装目录的bin文件下,进行替换。
1.2 解压hadoop-2.6.0.tar.gz到指定目录,并配置相应的环境变量。
1.2.1 新建HADOOP_HOME环境变量,并将其添加到path目录(;%HADOOP_HOME%\bin)
1.2.2 打开cmd窗口,输入hadoop version 命令进行验证,环境变量是否正常
1.3 对Hadoop进行配置:(无同名配置文件,可通过其同名template文件复制,再进行编辑)
1.3.1 编辑core-site.xml文件:(在hadoop的安装目录下创建workplace文件夹,在workplace下创建tmp和name文件夹)
<configuration>

    <property>

        <name>hadoop.tmp.dir</name>

        <value>/E:/software/hadoop-2.6.0/workplace/tmp</value>

    </property>

    <property>

        <name>dfs.name.dir</name>

        <value>/E:/software/hadoop-2.6.0/workplace/name</value>

    </property>

    <property>

        <name>fs.default.name</name>

        <value>hdfs://127.0.0.1:9000</value>

    </property>

    <property>

        <name>hadoop.proxyuser.gl.hosts</name>

        <value>*</value>

    </property>

    <property>

        <name>hadoop.proxyuser.gl.groups</name>

        <value>*</value>

    </property>

</configuration>
1.3.4 编辑hdfs-site.xml文件
<configuration>

    <!-- 这个参数设置为1,因为是单机版hadoop -->

    <property>

        <name>dfs.replication</name>

        <value>1</value>

    </property>

    <property>

        <name>dfs.namenode.name.dir</name>

        <value>file:/hadoop/data/dfs/namenode</value>

    </property>

    <property>

        <name>dfs.datanode.data.dir</name>

        <value>file:/hadoop/data/dfs/datanode</value>

    </property>

</configuration>
1.3.5 编辑mapred-site.xml
<configuration>

    <property>

       <name>mapreduce.framework.name</name>

       <value>yarn</value>

    </property>

    <property>

      <name>mapred.job.tracker</name>

      <value>127.0.0.1:9001</value>

    </property>

</configuration>
1.3.5 编辑yarn-site.xml文件
<configuration>

    <property>

        <name>yarn.nodemanager.aux-services</name>

        <value>mapreduce_shuffle</value>

    </property>

    <property>

        <name>yarn.nodemanager.aux-services.mapreduce.shuffle.class</name>

        <value>org.apache.hadoop.mapred.ShuffleHandler</value>

    </property>

</configuration>
1.4 初始化并启动Hadoop
1.4.1 在cmd窗口输入: hadoop namenode –format(或者hdfs namenode -format) 命令,对节点进行初始化
1.4.2 进入Hadoop安装目录下的sbin:(E:\software\hadoop-2.6.0\sbin),点击运行 start-all.bat 批处理文件,启动hadoop
1.4.3 验证hadoop是否成功启动:新建cmd窗口,输入:jps 命令,查看所有运行的服务,如果NameNode、NodeManager、DataNode、ResourceManager服务都存在,则说明启动成功。
1.5 文件传输测试
1.5.1 创建输入目录,新建cmd窗口,输入如下命令:(hdfs://localhost:9000 该路径为core-site.xml文件中配置的 fs.default.name 路径)
hadoop fs -mkdir hdfs://localhost:9000/user/
hadoop fs -mkdir hdfs://localhost:9000/user/wcinput
1.5.2 上传数据到指定目录:在cmd窗口输入如下命令:
hadoop fs -put E:\temp\MM.txt hdfs://localhost:9000/user/wcinput
hadoop fs -put E:\temp\react文档.txt hdfs://localhost:9000/user/wcinput
1.5.3 查看文件是否上传成功,在cmd窗口输入如下命令:
hadoop fs -ls hdfs://localhost:9000/user/wcinput
1.5.4 前台页面显示情况:
1.5.4 在前台查看hadoop的运行情况:(资源管理界面:http://localhost:8088/)
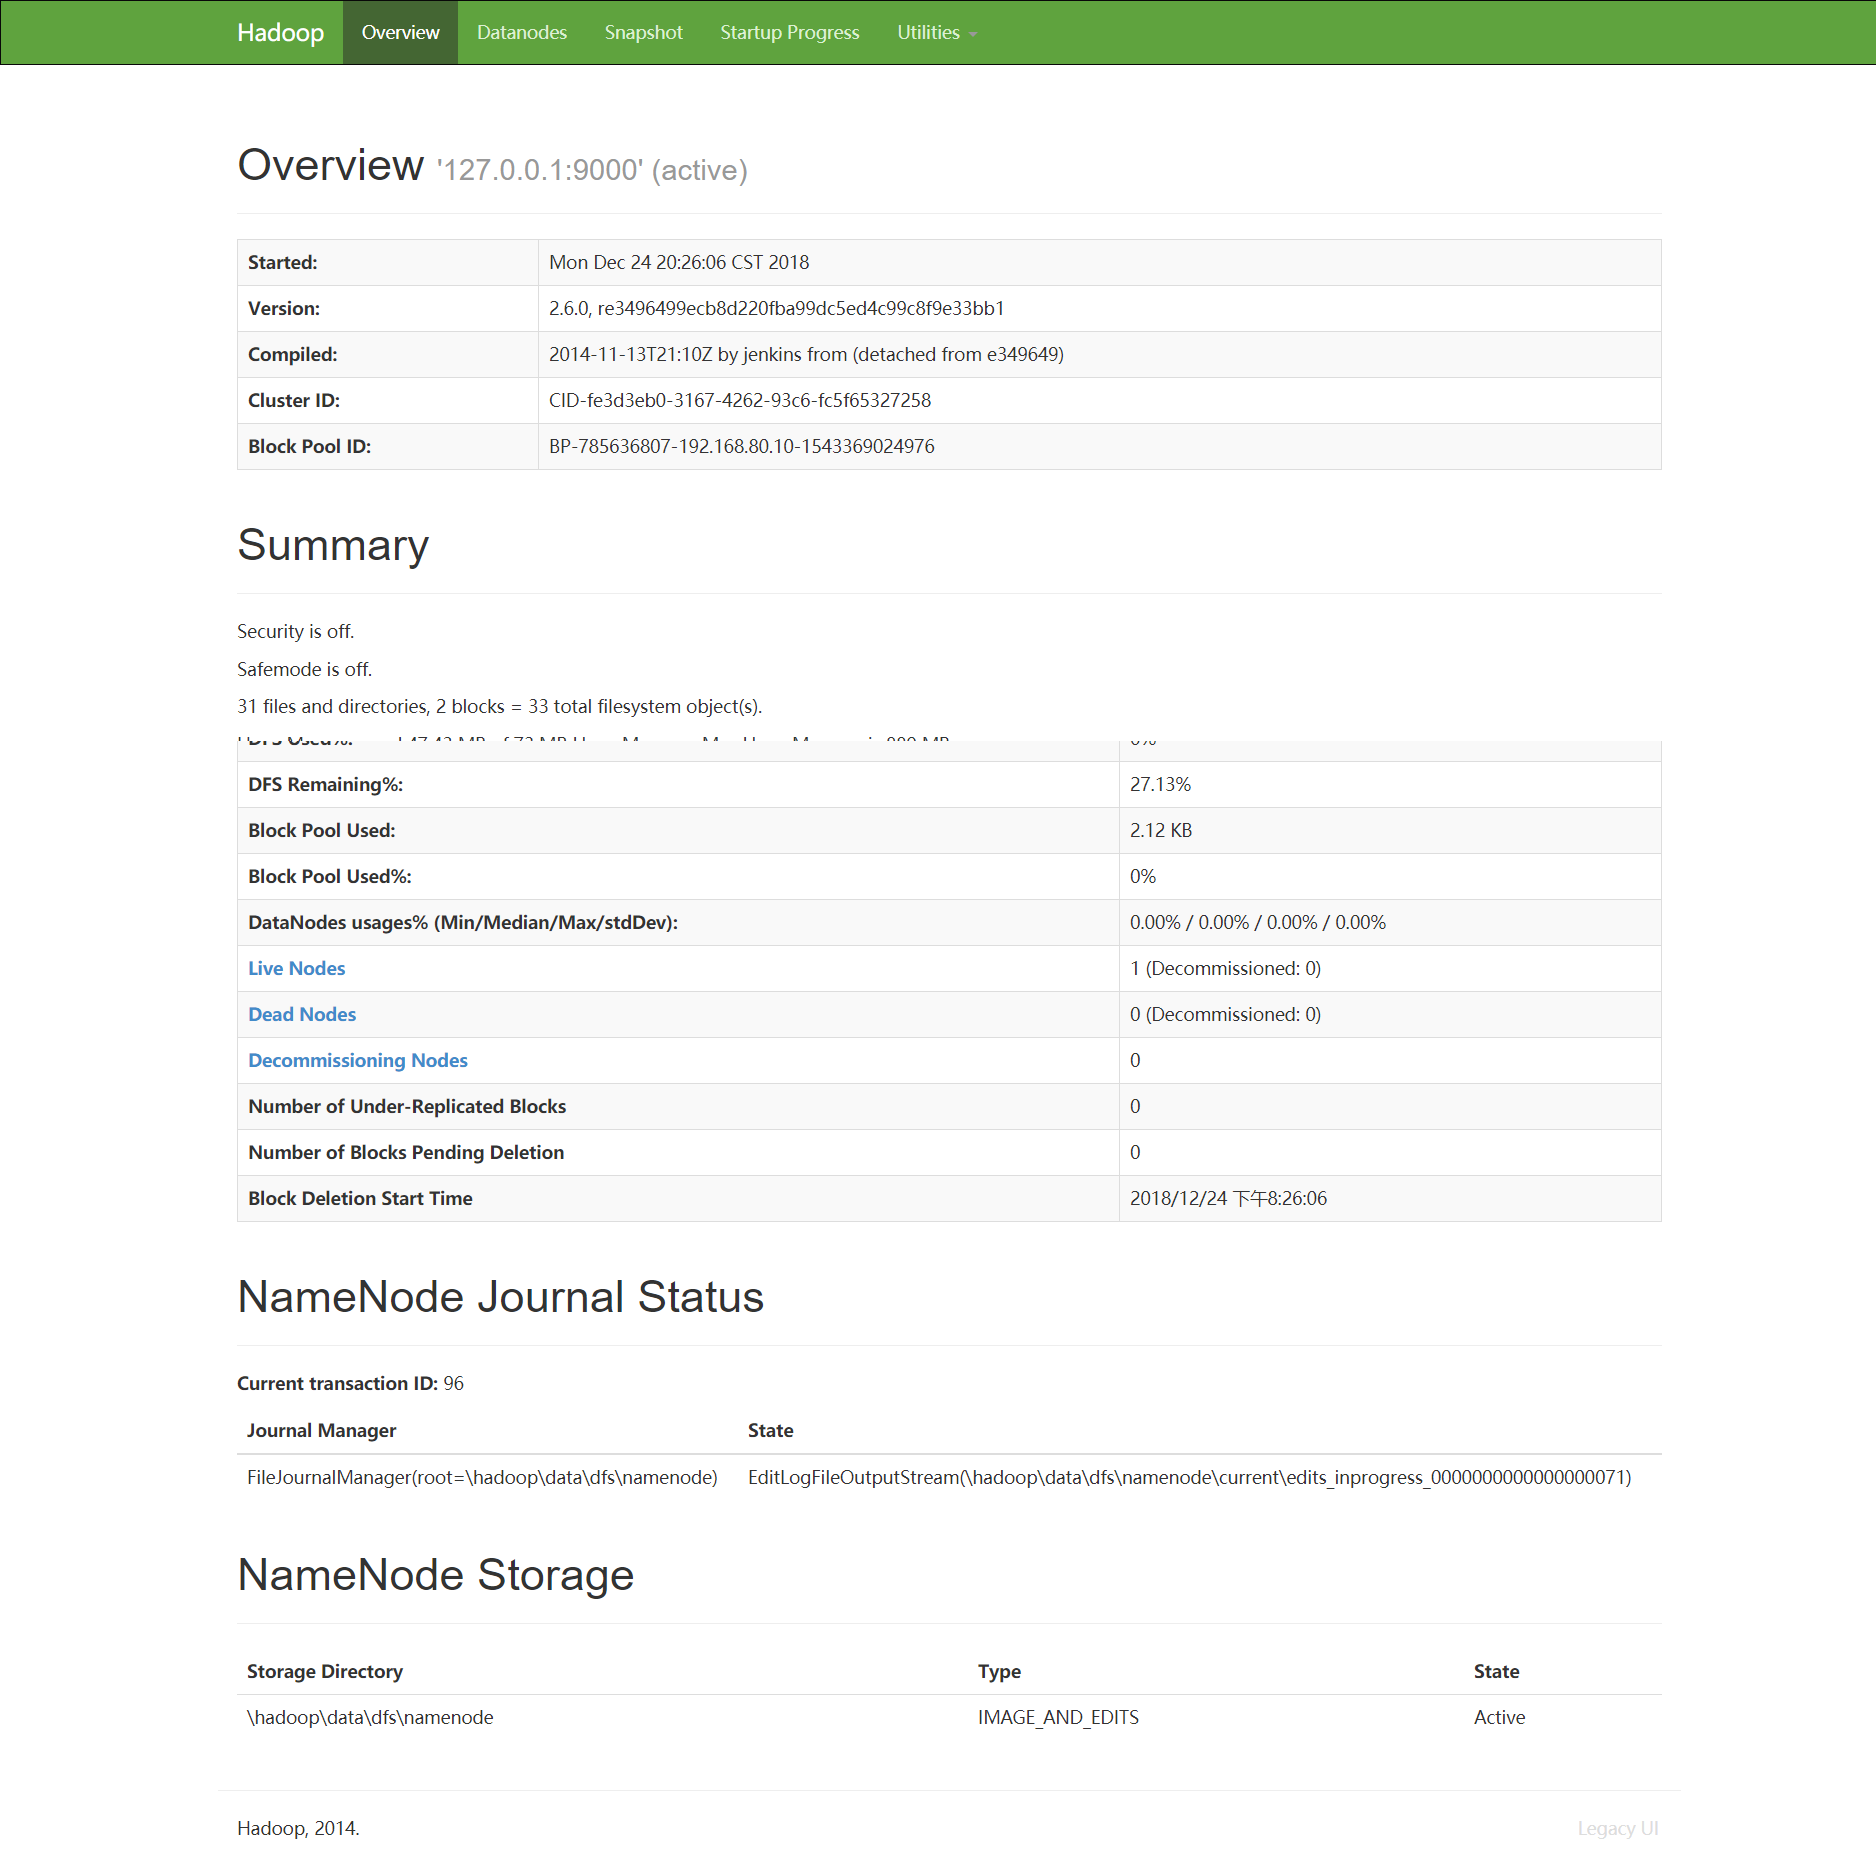
 1.5.5 节点管理界面(http://localhost:50070/)
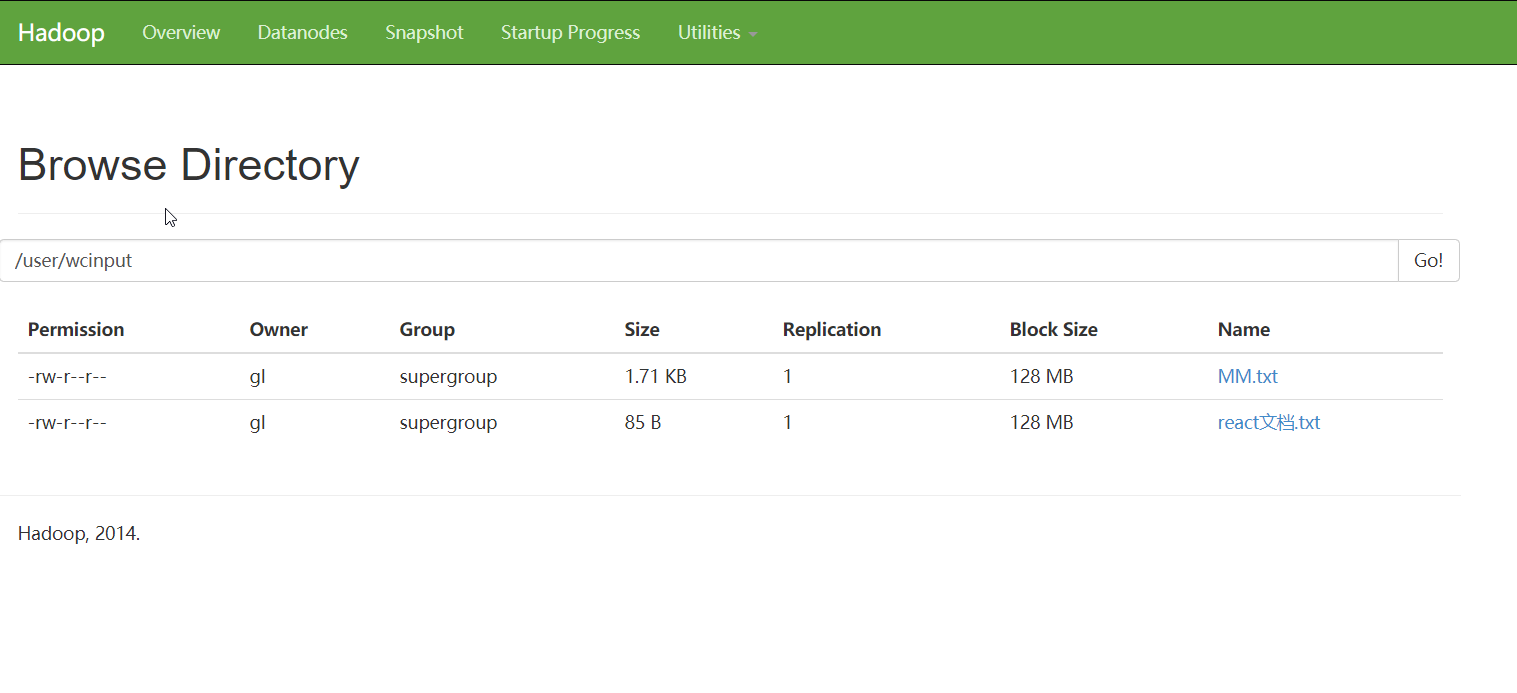
1.5.6 通过前台查看Hadoop的文件系统:(点击进入Utilities下拉菜单,再点击Browse the file system,依次进入user和wcinput,即可查看到上传的文件列表)如下图:
二. 安装并配置Hive
2.1 下载Hive 地址:http://mirror.bit.edu.cn/apache/hive/
2.2 将apache-hive-2.2.0-bin.tar.gz解压到指定的安装目录,并配置环境变量
2.2.1 新建HIVE_HOME环境变量,并将其添加到path目录(;%HIVE_HOME%\bin)
2.2.2 打开cmd窗口,输入hive version 命令进行验证环境变量是否正常
2.3 配置hive-site.xml文件(不解释,可以直接看配置的相关描述)
<property>
<name>hive.metastore.warehouse.dir</name>
<value>/user/hive/warehouse</value>
<description>location of default database for the warehouse</description>
</property>
<property>
<name>hive.exec.scratchdir</name>
<value>/tmp/hive</value>
<description>HDFS root scratch dir for Hive jobs which gets created with write all (733) permission. For each connecting user, an HDFS scratch dir: ${hive.exec.scratchdir}/<username> is created, with ${hive.scratch.dir.permission}.</description>
</property>
<property>
<name>hive.exec.local.scratchdir</name>
<value>E:/software/apache-hive-2.2.0-bin/scratch_dir</value>
<description>Local scratch space for Hive jobs</description>
</property>
<property>
<name>hive.downloaded.resources.dir</name>
<value>E:/software/apache-hive-2.2.0-bin/resources_dir/${hive.session.id}_resources</value>
<description>Temporary local directory for added resources in the remote file system.</description>
</property>
<property>
<name>hive.querylog.location</name>
<value>E:/software/apache-hive-2.2.0-bin/querylog_dir</value>
<description>Location of Hive run time structured log file</description>
</property>
<property>
<name>hive.server2.logging.operation.log.location</name>
<value>E:/software/apache-hive-2.2.0-bin/operation_dir</value>
<description>Top level directory where operation logs are stored if logging functionality is enabled</description>
</property>
<property>
<name>javax.jdo.option.ConnectionURL</name>
<value>jdbc:mysql://127.0.0.1:3306/hive?createDatabaseIfNotExist=true</value>
<description>
JDBC connect string for a JDBC metastore.
To use SSL to encrypt/authenticate the connection, provide database-specific SSL flag in the connection URL.
For example, jdbc:postgresql://myhost/db?ssl=true for postgres database.
</description>
</property>
<property>
<name>javax.jdo.option.ConnectionDriverName</name>
<value>com.mysql.jdbc.Driver</value>
<description>Driver class name for a JDBC metastore</description>
</property>
<property>
<name>javax.jdo.option.ConnectionUserName</name>
<value>root</value>
<description>Username to use against metastore database</description>
</property>
<property>
<name>javax.jdo.option.ConnectionPassword</name>
<value>123</value>
<description>password to use against metastore database</description>
</property>
<property>
<name>hive.metastore.schema.verification</name>
<value>false</value>
<description>
Enforce metastore schema version consistency.
True: Verify that version information stored in is compatible with one from Hive jars. Also disable automatic
schema migration attempt. Users are required to manually migrate schema after Hive upgrade which ensures
proper metastore schema migration. (Default)
False: Warn if the version information stored in metastore doesn't match with one from in Hive jars.
</description>
</property>
<!--配置用户名和密码-->
<property>
<name>hive.jdbc_passwd.auth.zhangsan</name>
<value>123</value>
</property>
2.4 在安装目录下创建配置文件中相应的文件夹:
E:\software\apache-hive-2.2.0-bin\scratch_dir
E:\software\apache-hive-2.2.0-bin\resources_dir
E:\software\apache-hive-2.2.0-bin\querylog_dir
E:\software\apache-hive-2.2.0-bin\operation_dir
2.5 对Hive元数据库进行初始化:(将mysql-connector-java-*.jar拷贝到安装目录lib下)
进入安装目录:apache-hive-2.2.0-bin/bin/,在新建cmd窗口执行如下命令(MySql数据库中会产生相应的用户和数据表)
hive --service schematool
(程序会自动进入***apache-hive-2.2.0-bin\scripts\metastore\upgrade\mysql\文件中读取对应版本的sql文件)
2.6 启动Hive ,新建cmd窗口,并输入以下命令:
启动metastore : hive --service metastore
启动hiveserver2:hive --service hiveserver2
(HiveServer2(HS2)是服务器接口,使远程客户端执行对hive的查询和检索结果(更详细的介绍这里)。目前基于Thrift RPC的实现,是HiveServer的改进版本,并支持多客户端并发和身份验证。
它旨在为JDBC和ODBC等开放API客户端提供更好的支持。)
2.7 验证:
新建cmd窗口,并输入以下 hive 命令,进入hive库交互操作界面:
hive> create table test_table(id INT, name string);

hive> create table student(id int,name string,gender int,address string);

hive> show tables;

student

test_table

2 rows selected (1.391 seconds)
三. 通过Kettle 6.0 连接Hadoop2.6.0 + Hive 2.2.0 大数据环境进行数据迁移
3.1 明确自己hadoop的发行版本,kettle自带的hadoop大致可以分为四种版本:
1. Apache 原生版本
2. Cloudera发行的CDH
3. Google发行的MapR
4. Amazon发行的EMR
5. hortworks发行的hdp
其他需要连接kettle的需要自行将所需要的依赖和配置文件导入到kettle的文件夹下:
E:\software\pdi-ce-6.0.1.0-386\data-integration\plugins\pentaho-big-data-plugin\hadoop-configurations
3.2 配置plugin.properties文件(以前在kettle的相关文档中看到对应的解释)
修改:active.hadoop.configuration=hdp22
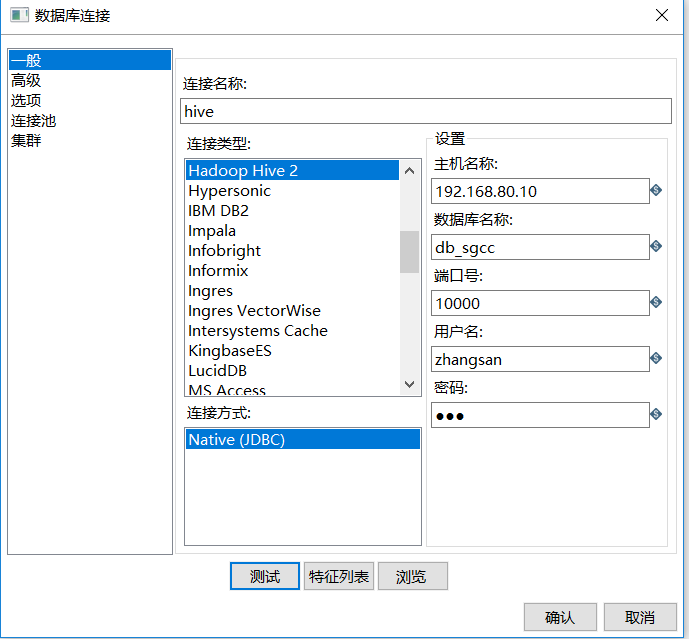
3.3 无需添加任何其他的jar包,开启kettle,并编辑如数据库连接,如下图:
3.4 测试连接,成功,如下图:

搭建Hadoop过程中报错和解决办法:
报错:1. error Couldn't find a package.json file in "***\\hadoop-2.6.0\\sbin
解决:下载webutils覆盖安装目录bin下的文件
报错:2.FATAL org.apache.hadoop.hdfs.server.datanode.DataNode: Initialization failed for Block pool <registering> (Datanode Uuid unassigned) service to localhost ***. Exiting.
org.apache.hadoop.hdfs.server.datanode.DataNode: Initialization failed for Block pool <registering> (Datanode Uuid unassigned) service to node****:9000. Exiting.
java.io.IOException: Incompatible clusterIDs in ****dfs/data: namenode clusterID = CID-9f0a13ce-d7c-****-4d60e63d8392; datanode clusterID = CID-29ff9b68-****-e-aa06-816513a36add
解决:暴力:删除tmp,name,data文件下的所有内容,重新生成,hdfs namenode -format
温柔:将name/current下的VERSION中的clusterID复制到data/current下的VERSION中,覆盖掉原来的clusterID让两个保持一致
报错:3. 执行sbin/start-all.cmd 启动命令
命令行报错:This script is deprecated. Instead use start-dfs.cmd and start - yard.cmd (windows找不到指定文件‘hadoop’)
bin/hadoop dfsadmin -report 查看报错详细信息
解决:
修改配置文件:hdfs-site.xml
修改前配置:

<property>

    <name>dfs.data.dir</name>

    <value>/E:/software/hadoop-2.6.0/workplace/data</value>

</property>

修改后配置:

<property>

    <name>dfs.namenode.name.dir</name>

    <value>file:/hadoop/data/dfs/namenode</value>

</property>

<property>

    <name>dfs.datanode.data.dir</name>

    <value>file:/hadoop/data/dfs/datanode</value>

</property>
搭建Hive和连接Kettle过程中的报错:
报错:1. ERROR [main]: metastore.MetaStoreDirectSql (MetaStoreDirectSql.java:<init>(135)) - Self-test query [select "DB_ID" from "DBS"] failed; direc
t SQL is disabled javax.jdo.JDODataStoreException: Error executing SQL query "select "DB_ID" from "DBS"".
解决:第一次启动hive时,需要对Hive元数据库进行初始化,以上报错因为元数据库初始化有问题导致的。
删除数据库中所有表,重新进行初始化
进入安装目录:apache-hive-2.2.0-bin/bin/,在命令行执行如下命令:hive --service schematool
程序会自动进入***apache-hive-2.2.0-bin\scripts\metastore\upgrade\mysql\文件中读取对应版本的sql文件
报错:2. Error: Could not open client transport with JDBC Uri: jdbc:hive2://hadoop01:10000: Failed to open new session: java.lang.RuntimeException:
org.apache.hadoop.ipc.RemoteException(org.apache.hadoop.security.authorize.AuthorizationException): User: A is not allowed to impersonate B(state=08S01,code=0)
解决:hadoop目录下/etc/hadoop/core-site.xml加入配置:
<property>

    <name>hadoop.proxyuser.A.hosts</name>

    <value>*</value>

</property>

<property>

    <name>hadoop.proxyuser.A.groups</name>

    <value>*</value>

</property>
(hadoop引入了一个安全伪装机制,使得hadoop 不允许上层系统直接将实际用户传递到hadoop层,而是将实际用户传递给一个超级代理,由此代理在hadoop上执行操作,避免任意客户端随意操作hadoop)
完结。。。。。
Windows环境下搭建Hadoop(2.6.0)+Hive(2.2.0)环境并连接Kettle(6.0)的更多相关文章
- 【大数据系列】windows环境下搭建hadoop开发环境使用api进行基本操作
前言 搭建完hadoop集群之后在windows环境下搭建java项目进行测试 操作hdfs中的文件 版本一 package com.slp.hadoop274.hdfs; import java.i ...
- [转] Hadoop入门系列(一)Window环境下搭建hadoop和hdfs的基本操作
转自:https://blog.csdn.net/qq_32938169/article/details/80209083 版权声明:本文为博主原创文章,遵循 CC 4.0 BY-SA 版权协议,转载 ...
- ubuntu环境下搭建Hadoop集群中必须需要注意的问题
博主安装的hadoop是3.1.3这里是按照厦门大学那个博客安装的,在安装与启动过程中,费了不少事,特此记录一下问题. 安装的连接: 安装环境:http://dblab.xmu.edu.cn/blog ...
- CentOS7 环境下 在Hadoop集群安装Hive
1.下载Hive的tar.gz包:http://mirror.bit.edu.cn/apache/hive/ 2.放入CentOS 7 系统中并解压:tar -zxvf apache-hive-2.3 ...
- 在Eclipse下搭建Hadoop开发环境
在前面的博文中博主展示了如何在虚拟机中搭建Hadoop的单节点伪分布集群,今天给大家介绍一下如何在Eclipse环境中搭建Hadoop的管理和开发环境,话不多说,下面我们就进入正题吧! 1.JDK安装 ...
- Windows 7下搭建Jmeter测试环境
jmeter配置.安装 一. 工具描述 apache jmeter是100%的java桌面应用程序,它被设计用来加载被测试软件功能特性.度量被测试软件的性能.设计jmeter的初衷是测试web应用,后 ...
- freeSSHD在windows环境下搭建SFTP服务器
freeSSHD在windows环境下搭建SFTP服务器 0 建议现在windows环境下安装cygwin,否则在windows环境下cmd模式使用不了sftp去连接,可以利用win scp去测试连接 ...
- windows环境下搭建Redis集群
转载请注明出处,原文章地址: https://www.cnblogs.com/tommy-huang/p/6240083.html Redis集群: 如果部署到多台电脑,就跟普通的集群一样:因为Red ...
- Apache Nifi在Windows环境下搭建伪群集及证书登录
代码地址如下:http://www.demodashi.com/demo/11986.html 前些时间做了关于Apache Nifi分布式集群的搭建分享,但很多时候要搭建分布式集群机器资源是个问题, ...
随机推荐
- 如何在github上fork以及同步原作者代码
参考网址:https://blog.csdn.net/llll2020/article/details/86140488 转 GitHub上fork别人打代码后如何保持和原作者同步的更新 </ ...
- C#如何调用DOS命令
在使用C#编辑过程中,通常需要利用外部命令来执行一些操作,从而完成特定的功能.下面小编就以利用C#调用DOS命令"Ver"显示系统版本号为例,给初学C#语言的网友讲解一下具体的调用 ...
- C#基础知识---迭代器与Foreach语句
一.Foreach语句简介 在C# 1.0中我们经常使用foreach来遍历一个集合中的元素,然而如果一个集合要支持使用foreach语句来进行遍历,这个集合一般需要IEnumerable或IEnum ...
- 关于Ubuntu18.04 linux系统下使用Tim QQ 微信
先配上张图 步骤: 1.1 :需要安装环境deepin-wine 1.1:(你把他理解为jdk就好,没有jdk无法运行java程序,同理没有deepin-wine环境无法运行腾讯产品) 1.2 :去哪 ...
- tomcat过滤器异常
Connected to server[2019-11-25 04:40:58,976] Artifact DUBBO_BG:Web exploded: Artifact is being deplo ...
- 六、Abp vNext 基础篇丨文章聚合功能上
介绍 9月开篇讲,前面几章群里已经有几个小伙伴跟着做了一遍了,遇到的问题和疑惑也都在群里反馈和解决好了,9月咱们保持保持更新.争取10月份更新完基础篇. 另外番外篇属于 我在abp群里和日常开发的问题 ...
- vue element-ui 做分页功能之封装
在 vue 项目中的 components 中 创建一个 文件夹,文件夹里创建一个 name(这个名字你随意取).vue <template> <div class=" ...
- Appium问题解决方案(6)- Java堆栈错误:java.lag.ClassNotFoundException:org.eclipse.swt.widets.Control
背景 运行脚本出现 SWT folder '..\lib\location of your Java installation.' does not exist. Please set ANDROID ...
- Cython 模块扩展 - 编程语言 替代实现 应用领域 汇总一览
Python 本身只是一种编程语言规范,可以使用其它编程语言实现它或扩展它:譬如:采有 Python C Java .Net 等重实现 Python,而采用 Python C/C++ C# Java ...
- java 集合特性面试必备
collection 集合体系 数据结构栈和队列栈结构 :先进后出队列结构 :先进先出 数据结构之数组和链表数组结构:查询快.增删慢队列结构 :查询慢.增删快 List集合概述有序集合(也称为序列), ...