
PyTorch 介绍 | DATSETS & DATALOADERS
用于处理数据样本的代码可能会变得凌乱且难以维护;理想情况下,我们希望数据集代码和模型训练代码解耦(分离),以获得更好的可读性和模块性。PyTorch提供了两个data primitives:torch.utils.data.DataLoader 和 torch.utils.data.Dataset,允许你使用预加载的datasets和你自己的data。Dataset 存储样本及其对应的标签,DataLoader 给 Dataset 包装了一个迭代器,以便访问样本。
PyTorch库提供了一些预加载的数据集(如FashionMNIST),它们是 torch.utils.data.Dataset 的子类,特定的数据对应特定的实现函数。它们可以用来原型化和基准化你的模型。你可以在这里查看它们:Image Datasets, Text Datasets, and Audio Datasets。
加载数据集
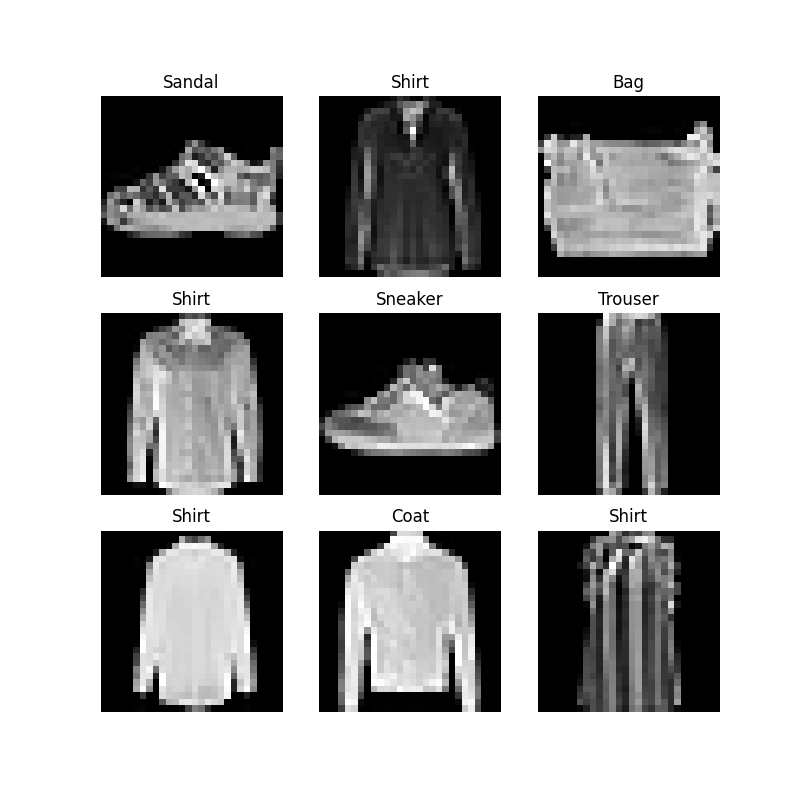
这是一个怎样从TorchVision加载Fashion-MNIST数据集的例子。Fashion-MNIST来自于Zalando的文章,由60000张训练样本和10000张测试样本组成。每一个样本包含一个28x28
的灰度图片和对应的10类中的1个类的标签。
我们用以下参数加载FashionMNIST Dataset
root是训练/测试数据的保存路径train指定是训练集还是测试集download=True如果root中没有,则从网上下载transform和target_transform指定样本的变换
import torch

from torch.utils.data import Dataset

from torchvision import datasets

from torchvision.transforms import ToTensor

import matplotlib.pyplot as plt

training_data = datasets.FashionMNIST(

    root='data',

    train=True,

    download=True,

    transform=ToTensor()

)

test_data = datasets.FashionMNIST(

    root='data',

    train=False,

    download=True

    transform=ToTensor()

)
输出:
点击查看代码
Downloading http://fashion-mnist.s3-website.eu-central-1.amazonaws.com/train-images-idx3-ubyte.gz

Downloading http://fashion-mnist.s3-website.eu-central-1.amazonaws.com/train-images-idx3-ubyte.gz to data/FashionMNIST/raw/train-images-idx3-ubyte.gz

Extracting data/FashionMNIST/raw/train-images-idx3-ubyte.gz to data/FashionMNIST/raw

Downloading http://fashion-mnist.s3-website.eu-central-1.amazonaws.com/train-labels-idx1-ubyte.gz

Downloading http://fashion-mnist.s3-website.eu-central-1.amazonaws.com/train-labels-idx1-ubyte.gz to data/FashionMNIST/raw/train-labels-idx1-ubyte.gz

Extracting data/FashionMNIST/raw/train-labels-idx1-ubyte.gz to data/FashionMNIST/raw

Downloading http://fashion-mnist.s3-website.eu-central-1.amazonaws.com/t10k-images-idx3-ubyte.gz

Downloading http://fashion-mnist.s3-website.eu-central-1.amazonaws.com/t10k-images-idx3-ubyte.gz to data/FashionMNIST/raw/t10k-images-idx3-ubyte.gz

Extracting data/FashionMNIST/raw/t10k-images-idx3-ubyte.gz to data/FashionMNIST/raw

Downloading http://fashion-mnist.s3-website.eu-central-1.amazonaws.com/t10k-labels-idx1-ubyte.gz

Downloading http://fashion-mnist.s3-website.eu-central-1.amazonaws.com/t10k-labels-idx1-ubyte.gz to data/FashionMNIST/raw/t10k-labels-idx1-ubyte.gz

Extracting data/FashionMNIST/raw/t10k-labels-idx1-ubyte.gz to data/FashionMNIST/raw
迭代和数据集可视化
我们可以像list一样索引Datasets:training_data[index]。使用 matplotlib 可视化一些训练集的样本。
labels_map = {

    0: "T-Shirt",

    1: "Trouser",

    2: "Pullover",

    3: "Dress",

    4: "Coat",

    5: "Sandal",

    6: "Shirt",

    7: "Sneaker",

    8: "Bag",

    9: "Ankle Boot",

}

figure = plt.figure(figsize=(8, 8))

cols, rows = 3, 3

for i in range(1, cols * rows + 1):

    sample_idx = torch.randint(len(training_data), size=(1,)).item()

    img, label = training_data[sample_idx]

    figure.add_subplot(rows, cols, i)

    plt.title(labels_map[label])

    plt.axis("off")

    # torch.squeeze():删除维数为1的维度

    plt.imshow(img.squeeze(), cmap="gray")

plt.show()
创建自定义数据集
一个自定义的数据集类必须实现三个函数:init,len,getitem。查看下面的实现过程,FashionMNIST图片保存在 img_dir,它们的标签分别保存在一个CSV文件(逗号分隔值文件) annotations_file 中。
下一节,我们将分解每个函数做了什么的。
import os

import pandas as pd

from torchvision.io import read_image

class CustomImageDataset(Dataset):

    def __init__(self, annotations_file, img_dir, transform=None, target_transform=None):

        # 利用pandas读取csv并转换为DataFrame

        self.img_labels = pd.read_csv(annotations_file)

        self.img_dir = img_dir

        self.transform = transform

        self.target_transform = target_transform

    def __len__(self):

        return len(self.img_labels)

    def __getitem__(self, idx):

        img_path = os.path.join(self.img_dir, self.img_labels.iloc[idx, 0])

        image = read_image(img_path)

        label = self.img_labels.iloc[idx, 1]

        if self.transform:

            image = self.transform(image)

        if self.target_transform:

            label = self.target_transform(label)

        return image, label
init
一旦实例化Datase对象,函数__init__ 就会立即运行:初始化包含图片的目录,标签文件,以及两个转换(下一节有更详细的介绍)
labels.csv类似这样:
tshirt1.jpg, 0

tshirt2.jpg, 0

...

anleboot999.jpg, 9
def __init__(self, annotations_file, img_dir, transform=None, target_transform=None):

    # 这里指定了列名

    self.img_labels = pd.read_csv(annotations_file, names=['file_name', 'labels'])

    self.img_dir = img_dir

    self.transform = transform

    self.target_transform = target_transform
len
__len__ 函数返回数据集的样本数
例如:
def __len__(self):

    return len(self.img_labels)
getitem
__getitem__函数加载和返回数据集中给定索引 idx 的样本。根据索引,它获得了硬盘上图片的位置,利用 read_image 转换为tensor,在 self.img_labels ,从csv中检索相应的标签,并调用转换函数(如果可用),返回一个包含图片和对应标签张量的元组。
def __getitem__(self, idx):

    img_path = os.path.join(self.img_dir, self.img_labels.iloc[idx, 0])

    image = read_image(img_path)

    label = self.img_labels.iloc[idx, 1]

    if self.transform:

        image = self.transform(image)

    if self.target_transform:

        label = self.target_transform(label)

    return image, label
利用DataLoader为训练准备你的数据
Dataset只能同时检索一个样本的数据特征和标签。当训练模型时,通常需要传递“minibatches”样本,每一个epoch重复打乱数据减少过拟合,并使用Python的 multiprocessing 加速数据检索。
DataLoader 是一个迭代器。
from torch.utils.data import DataLoader

train_dataloader = DataLoader(training_data, batch_size=64, shuffle=True)

test_dataloader = DataLoader(test_data, batch_size=64, shuffle=True)
通过DataLoader迭代
我们已经将该数据集加载到 DataLoader,根据需要可以对数据集进行迭代。每次迭代返回一个 train_features 和 train_labels 的batch(分别包含 batch_size=64的特征和标签)。因为我们指定了 shuffle=True, 在我们迭代完所有的batch之后,数据就会被打乱(为了对数据加载顺序进行更细致的控制,参阅Samplers)
# Display image and label.

train_features, train_labels = next(iter(train_dataloader))

print(f"Feature batch shape: {train_features.size()}")

print(f"Labels batch shape: {train_labels.size()}")

img = train_features[0].squeeze()

label = train_labels[0]

plt.imshow(img, cmap="gray")

plt.show()

print(f"Label: {label}")
输出:
Feature batch shape: torch.Size([64, 1, 28, 28])

Labels batch shape: torch.Size([64])

Label: 7
延伸阅读
PyTorch 介绍 | DATSETS & DATALOADERS的更多相关文章
- PyTorch 介绍 | BUILD THE NEURAL NETWORK
神经网络由对数据进行操作的layers/modules组成.torch.nn 命名空间提供了所有你需要的构建块,用于构建你自己的神经网络.PyTorch的每一个module都继承自nn.Module. ...
- PyTorch 介绍 | AUTOMATIC DIFFERENTIATION WITH TORCH.AUTOGRAD
训练神经网络时,最常用的算法就是反向传播.在该算法中,参数(模型权重)会根据损失函数关于对应参数的梯度进行调整. 为了计算这些梯度,PyTorch内置了名为 torch.autograd 的微分引擎. ...
- PyTorch 介绍 | TRANSFORMS
数据并不总是满足机器学习算法所需的格式.我们使用transform对数据进行一些操作,使得其能适用于训练. 所有的TorchVision数据集都有两个参数,用以接受包含transform逻辑的可调用项 ...
- Pytorch(一)
一.Pytorch介绍 Pytorch 是Torch在Python上的衍生物 和Tensorflow相比: Pytorch建立的神经网络是动态的,而Tensorflow建立的神经网络是静态的 Tens ...
- PyTorch 实战:计算 Wasserstein 距离
PyTorch 实战:计算 Wasserstein 距离 2019-09-23 18:42:56 This blog is copied from: https://mp.weixin.qq.com/ ...
- Tensorflow和pytorch安装(windows安装)
一. Tensorflow安装 1. Tensorflow介绍 Tensorflow是广泛使用的实现机器学习以及其它涉及大量数学运算的算法库之一.Tensorflow由Google开发,是GitHub ...
- PyTorch专栏开篇
目前研究人员正在使用的深度学习框架不尽相同,有 TensorFlow .PyTorch.Keras等.这些深度学习框架被应用于计算机视觉.语音识别.自然语言处理与生物信息学等领域,并获取了极好的效果. ...
- 如何入门Pytorch之一:Pytorch基本知识介绍
前言 PyTorch和Tensorflow是目前最为火热的两大深度学习框架,Tensorflow主要用户群在于工业界,而PyTorch主要用户分布在学术界.目前视觉三大顶会的论文大多都是基于PyTor ...
- pytorch学习笔记(九):PyTorch结构介绍
PyTorch结构介绍对PyTorch架构的粗浅理解,不能保证完全正确,但是希望可以从更高层次上对PyTorch上有个整体把握.水平有限,如有错误,欢迎指错,谢谢! 几个重要的类型和数值相关的Tens ...
随机推荐
- 【LeetCode】532. K-diff Pairs in an Array 解题报告(Python & C++)
作者: 负雪明烛 id: fuxuemingzhu 个人博客: http://fuxuemingzhu.cn/ 目录 题目描述 题目大意 解题方法 字典 日期 题目地址:https://leetcod ...
- SpringCloud创建Config读取本地配置
1.说明 Config Server获取配置支持的方式很多, 包括Git仓库(github/gitee等),任何与JDBC兼容的数据库, Subversion,Hashicorp Vault,Cred ...
- Unity——ShaderLab实现玻璃和镜子效果
在这一篇中会实现会介绍折射和反射,以及菲尼尔反射:并且实现镜子和玻璃效果: 这里和之前不同的地方在于取样的是一张CubeMap: demo里的cubemap使用的一样,相机所在位置拍出来的周围环境图: ...
- [Docker] 制作并运行 Nginx 镜像
环境 操作系统(cat /etc/redhat-release):CentOS Linux release 7.6.1810 (Core) Docker:18.09.6 文件 Dockerfile F ...
- 新增访客数量MR统计之数据库准备
关注公众号:分享电脑学习回复"百度云盘" 可以免费获取所有学习文档的代码(不定期更新)云盘目录说明:tools目录是安装包res 目录是每一个课件对应的代码和资源等doc 目录是一 ...
- 编写java程序压缩Linux本地目录
注:图片如果损坏,点击文章链接:https://www.toutiao.com/i6809285459722633736/ 创建工程 使用maven工程 勾选,然后下一步 填写基本信息 注意改一下编码 ...
- 微信小程序封装mixins方法
在app.js中这样引入 import '@src/utils/mixins' mixins函数如下 /** * 封装类似vue的混入功能 */ let native = Page Page = (o ...
- .NET对接极光消息推送
什么是APP消息推送? 很多手机APP会不定时的给用户推送消息,例如一些新闻APP会给用户推送用户可能感兴趣的新闻,或者APP有更新了,会给用户推送是否选择更新的消息等等,这就是所谓的"消息 ...
- kubernetes运行应用2之DaemonSet详解
kubernetes运行应用1之Deployment详解 查看daemonset 如下,k8s自身的 DaemonSet kube-flannel-ds和kube-proxy分别负责在每个结点上运 ...
- 【刷题-LeetCode】306. Additive Number
Additive Number Additive number is a string whose digits can form additive sequence. A valid additiv ...