
Spark的Streaming + Flume进行数据采集(flume主动推送或者Spark Stream主动拉取)
1、针对国外的开源技术,还是学会看国外的英文说明来的直接,迅速,这里简单贴一下如何看:
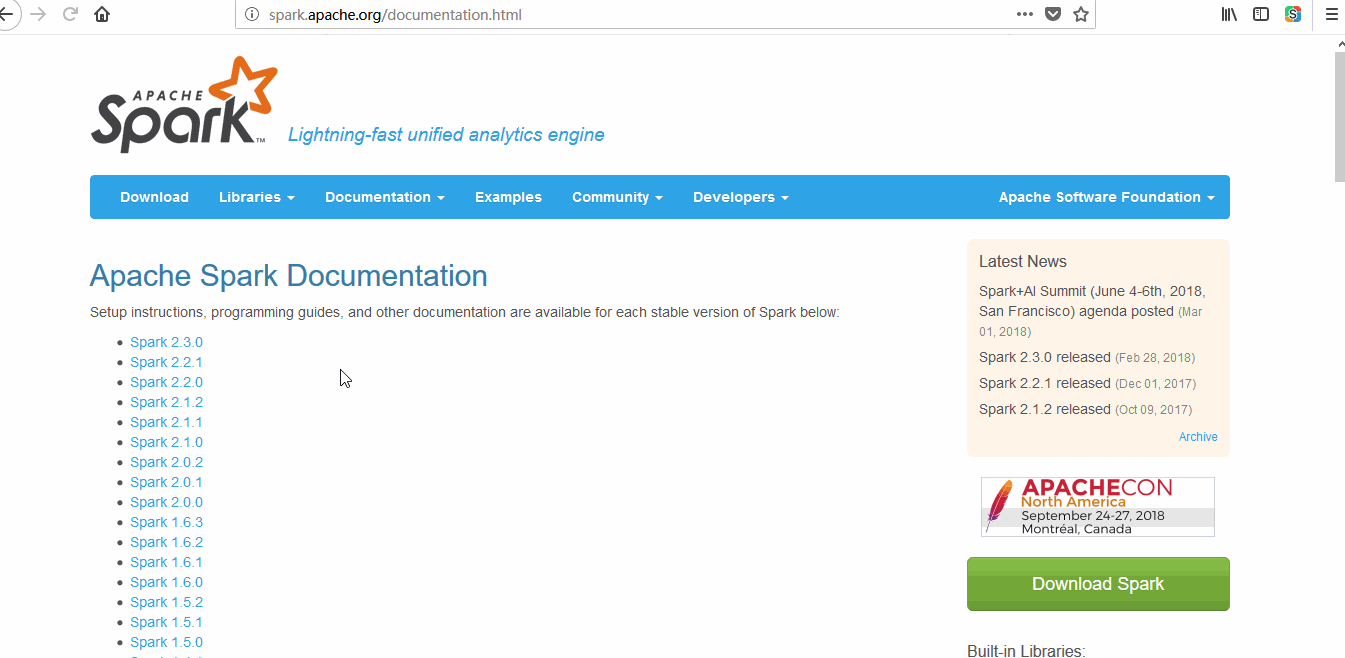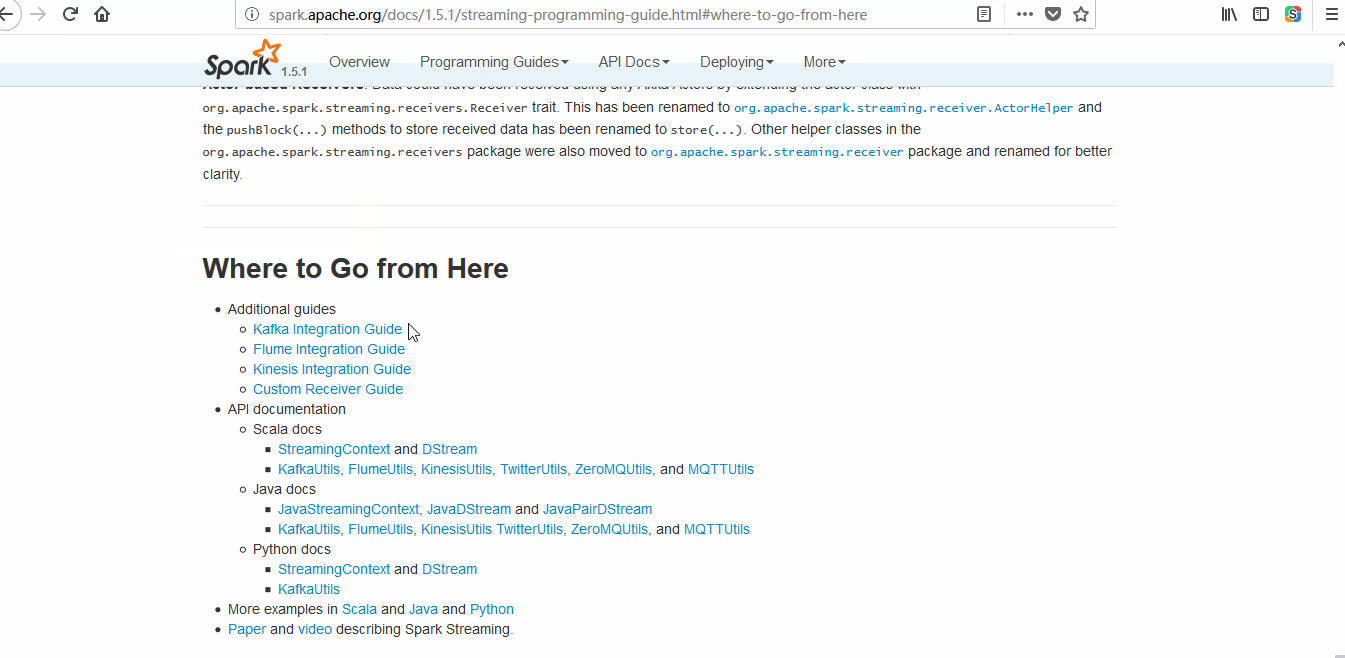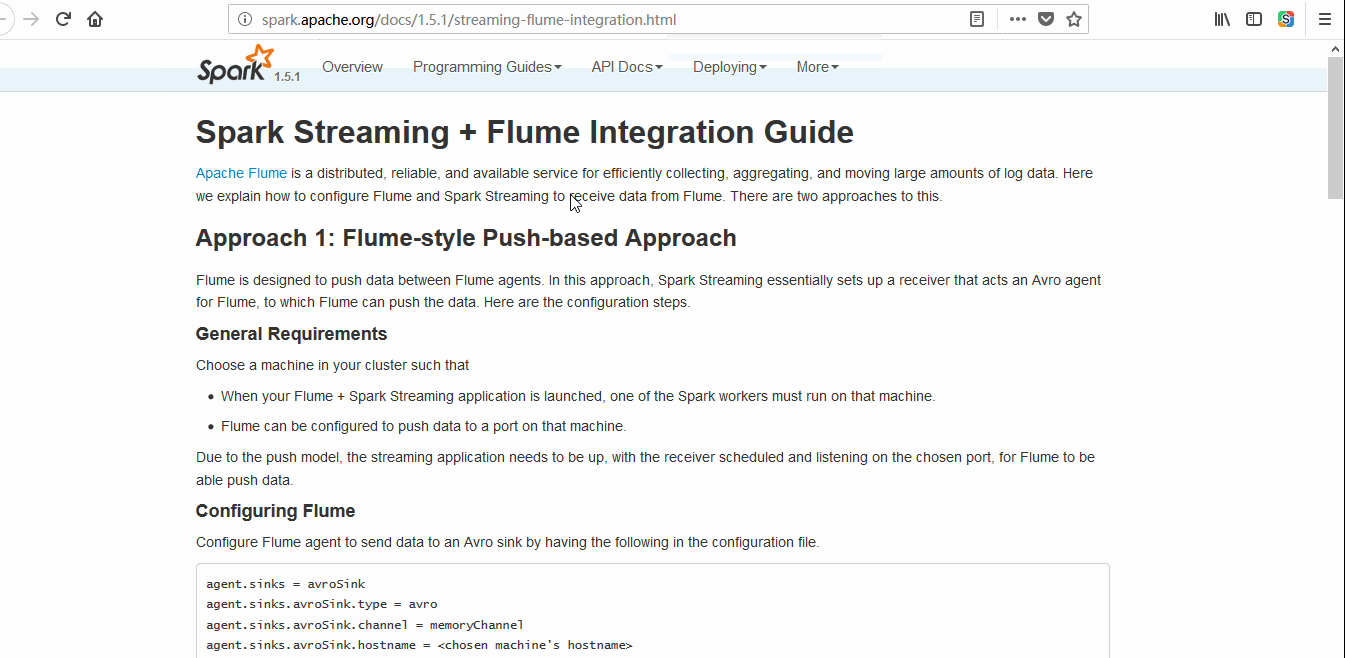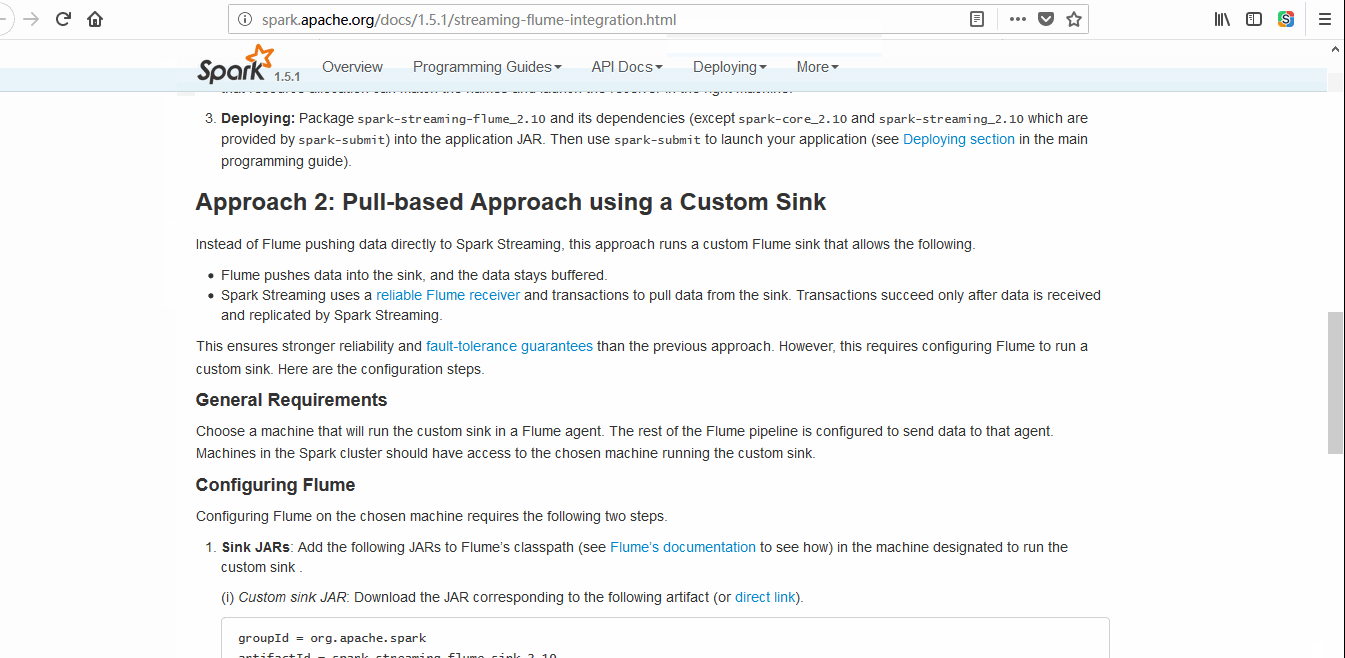
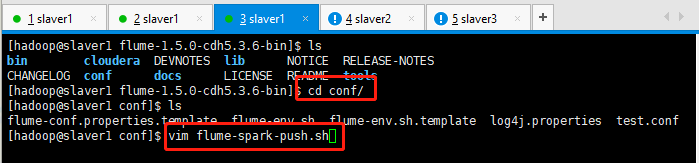
2、进入到flume的conf目录,创建一个flume-spark-push.sh的文件:
[hadoop@slaver1 conf]$ vim flume-spark-push.sh
配置一下这个文件,flume使用avro的。
# example.conf: A single-node Flume configuration

# Name the components on this agent

#定义这个agent中各组件的名字,给那三个组件sources,sinks,channels取个名字,是一个逻辑代号:

#a1是agent的代表。

a1.sources = r1

a1.channels = c1

a1.sinks = k1

# Describe/configure the source 描述和配置source组件:r1

#类型, 从网络端口接收数据,在本机启动, 所以localhost, type=spoolDir采集目录源,目录里有就采

#type是类型,是采集源的具体实现,这里是接受网络端口的,netcat可以从一个网络端口接受数据的。netcat在linux里的程序就是nc,可以学习一下。

#bind绑定本机localhost。port端口号为44444。

a1.sources.r1.type = exec

a1.sources.r1.bind = tail -f /home/hadoop/data_hadoop/spark-flume/wctotal.log

a1.sources.r1.shell = /bin/bash -c

# Describe the sink 描述和配置sink组件:k1

#type,下沉类型,使用logger,将数据打印到屏幕上面。

#a1.sinks.k1.type = logger

# Use a channel which buffers events in memory 描述和配置channel组件,此处使用是内存缓存的方式

#type类型是内存memory。

#下沉的时候是一批一批的, 下沉的时候是一个个eventChannel参数解释:

#capacity:默认该通道中最大的可以存储的event数量,1000是代表1000条数据。

#trasactionCapacity:每次最大可以从source中拿到或者送到sink中的event数量。

a1.channels.c1.type = memory

a1.channels.c1.capacity =

a1.channels.c1.transactionCapacity =

# define sink

a1.sinks.k1.type= avro

a1.sinks.k1.hostname = slaver1

a1.sinks.k1.port =

# Bind the source and sink to the channel 描述和配置source  channel   sink之间的连接关系

#将sources和sinks绑定到channel上面。

a1.sources.r1.channels = c1

a1.sinks.k1.channel = c1
3、然后去Spark的github查看项目demo:https://github.com/apache/spark
代码如下所示:
import org.apache.spark._

import org.apache.spark.streaming._

import org.apache.spark.streaming.StreamingContext._

import org.apache.spark.streaming.flume._

import org.apache.spark.util.IntParam

val ssc = new StreamingContext(sc, Seconds())

val stream = FlumeUtils.createStream(ssc, slaver1, , StorageLevel.MEMORY_ONLY_SER_2)

stream.count().map(cnt => "Received " + cnt + " flume events." ).print()

ssc.start()             // Start the computation

ssc.awaitTermination()  // Wait for the computation to terminate
导入flume的包的时候出现问题,找不到包:import org.apache.spark.streaming.flume._
scala> import org.apache.spark.streaming.flume._

<console>:: error: object flume is not a member of package org.apache.spark.streaming

       import org.apache.spark.streaming.flume._
由于没有搭建maven项目,在命令行需要导入jar包,这里先放置一下,稍后继续记笔记。
待续.......
Spark的Streaming + Flume进行数据采集(flume主动推送或者Spark Stream主动拉取)的更多相关文章
- 百度链接提交-主动推送Python版
百度目前提供自动提交链接和手动提交链接两种方式,其中自动提交又分为主动推送.自动推送和sitemap三种形式,按百度的说法,主动推送的效果最好,百度站长平台后台也提供了curl.php.ruby的推送 ...
- PHP版微信公共平台消息主动推送,突破订阅号一天只能发送一条信息限制
2013年10月06日最新整理. PHP版微信公共平台消息主动推送,突破订阅号一天只能发送一条信息限制 微信公共平台消息主动推送接口一直是腾讯的私用接口,相信很多朋友都非常想要用到这个功能. 通过学习 ...
- SEO 百度后台主动推送链接
实践步骤,先用爬虫程序将本网站的所有连接爬取出来,再用python文件处理程序把爬虫来的东东整理成一行一个链接的文本格式.再用postman接口测试工具,使用post方式,将所有的链接post过去,这 ...
- asp.net 实现微信公众平台的主动推送信息
通过学习借鉴朋友的实现方法进行整理(微信公众帐号主动发送消息给用户,asp.net版本). /// <summary> /// MD5 32位加密 /// </summary> ...
- 1.使用SignalR实现页面即时刷新(服务端主动推送)
模块功能说明: 实现技术:sqlserver,MVC,WebAPI,ADO.NET,SignalR(服务器主动推送) 特殊车辆管理--->移动客户端采集数据存入数据库---->只要数据库数 ...
- Django2.0.4 + websocket 实现实时通信,主动推送,聊天室及客服系统
webSocket是一种在单个TCP连接上进行全双工通信的协议. webSocket使得客户端和服务器之间的数据交换变得更加简单,允许服务端主动向客户端推送数据.在WebSocket API中,浏览器 ...
- Python 版百度站长平台链接主动推送脚本
如果自己的网站需要被百度收录,可以在搜索结果中找到,就需要将网站的链接提交给百度.依靠百度的爬虫可能无法检索到网站所有的内容,因此可以主动将链接提交给百度. 在百度的站长平台上介绍了链接提交方法,目前 ...
- 【SpringBoot】服务器端主动推送SSE技术讲解
=====================16.高级篇幅之SpringBoot2.0服务器端主动推送SSE技术讲解 ============================ 1.服务端推送常用技术介绍 ...
- 使用SignalR实现页面即时刷新(服务端主动推送)
模块功能说明: 实现技术:sqlserver,MVC,WebAPI,ADO.NET,SignalR(服务器主动推送) 特殊车辆管理--->移动客户端采集数据存入数据库---->只要数据库数 ...
随机推荐
- VUE环境部署
npm install vue-router --save 下载node.js安装https://nodejs.org/en/ npm install -g cnpm --registry=http ...
- WM_COMMAND消息
原文地址:https://blog.csdn.net/whm243149796/article/details/78966065 当用户点击菜单.按钮.下拉列表框等控件时候,会触发WM_COMMAND ...
- 阿里云服务器上通过Docker部署redmine
背景:在日常工作的过程中会遇到各种各样的问题,每个问题来了之后需要花时间解决.这里就面临两个问题. 1:问题责任不明确,有时候会遇到数据库或者物理服务器的问题,这时候就需要把相应问题指派给相应的人,传 ...
- Nodejs脚手架搭建基于express的应用
原文链接:https://www.cnblogs.com/FE-yanyi1993/p/6413042.html 这篇写的非常详细,此处只做记录. 1.安装生成器 $ npm install expr ...
- MySQL--视图view、触发器trigger、事务(start transaction)、存储过程(特殊的数据逻辑处理函数)、流程控制(if,case....)
mysql致力于项目开发及数据库管理之间解耦合(帮忙封装一些数据处理方法,使应用程序的开发者可以专注于应用程序的开发),但受限于不同部门沟通的成本问题,现阶段直接使用的价值不大. 一.视图(只能sel ...
- OpenStack实践系列⑥构建虚拟机实例
OpenStack实践系列⑥构建虚拟机实例 四.创建一台虚拟机图解网络,并创建一个真实的桥接网络 创建一个单一扁平网络(名字:flat),网络类型为flat,网络适共享的(share),网络提供者:p ...
- SQL Server 2017 安装详解
SQL server 2017下载链接:https://pan.baidu.com/s/1FSzqJfHQAa0QpZ_fObrfjQ 提取码:1xvb 1.双击iso镜像文件 打开setup ...
- python实现求最大公约数与最小公倍数
记录python实现最大公约数&最小公位数两种算法 概念 最大公约数:指两个或多个整数共有约数中最大的一个 最小公倍数:两个或多个整数公有的倍数叫做它们的公倍数,其中除0以外最小的一个公倍数就 ...
- HDU 1077
题意 : 给你 N 个点, 问一个单位圆最大能包括几个点 直接暴力枚举圆心, 计算个数 O(n^ 3): 精度,细节都要注意, //#include<bit/stdc++.h> ...
- 模块 -- 序列化 hashlib sha logging (加密 加盐 )
模块: 一个py文件就是一个模块 模块分类: 1:内置模块,登录模块,时间模块,sys模块,os模块等等 2: 扩展模块, 3:自定义模块,自己写的py文件 python 开发效率之高:python ...