
Unicode 与 Unicode Transformation Format(UTF-8 / UTF-16 / UTF-32)
- ASCII(American Standard Code for Information Interchange):早期它使用7 bits来表示一个字符,总共表示27 = 128个字符;后来扩展到8 bits,即用一个字节来表示一个字符,总共表示28 = 256个字符,这种ASCII扩展字符集如IBM字符集和ISO Latin-1,首位为1(128~255)的编码区域表示扩展字符
- Unicode:由于ASCII字符集总数有限且只适用于欧洲语言国家,不同语言体系的国家要统一使用同一种字符集,就需要一种更大的字符集。Unicode早期采用2个字节编码,总共可表示216 = 65536个字符,它通过增加一个高字节对ISO Latin-1字符集进行扩展,当这些高字节位为0时,低字节就是ISO Latin-1字符;然而,可以用ASCII表示的字符使用Unicode并不高效,因为Unicode比ASCII占用大一倍的空间,对ASCII来说高字节的0对他毫无用处。为了解决这个问题,就出现了一些中间格式的字符集,他们被称为通用转换格式,即UTF(Unicode Transformation Format),如UTF-8、UTF-16、UTF-32。Universal Character Set(UCS)是由ISO制定的ISO 10646(或称ISO/IEC 10646)标准所定义的标准字符集,UCS-2用两个字节编码,UCS-4用4个字节编码。从Unicode 2.0开始,Unicode采用了与ISO 10646-1相同的字库和字码,以保持两者兼容。Unicode计划使用17个平面(Plane,包含216 = 65536个码位。Plane 0被称为Basic Multilingual Plane),一共有17×65536=1114112个码位(0~1114111)。ISO承诺ISO 10646将不会替超出U+10FFFF(1114111)的UCS-4编码赋值,以使得两者保持一致
- BOM(Byte Order Mark,字节顺序标记):特殊字符U+FEFF叫做 "Zero Width No-Break Space" ,中文译作“零宽无间断间隔”的字符,实际不会出现在正常字节流中。但在传输字节流前,先传输字符 "Zero Width No-Break Space",如果收到FFFE,就表明这个字节流是 Little- Endian (小端序、小字节序、低字节序、小尾序,即低位字节排放在内存的低地址端,高位字节排放在内存的高地址端)的;如果收到 FEFF,就表明这个字节流是 Big-Endian (大端序,字节顺序与 Little- Endian 刚好相反)的。因此字符 "Zero Width No-Break Space" 又被称作 BOM,它将出现在文本文件头部,表明文件的编码方式。UTF-8 虽是字节顺序无关的,但仍然可以用 BOM (EF BB BF)来表明其编码方式。下图展示了编码方式与BOM的对应关系:
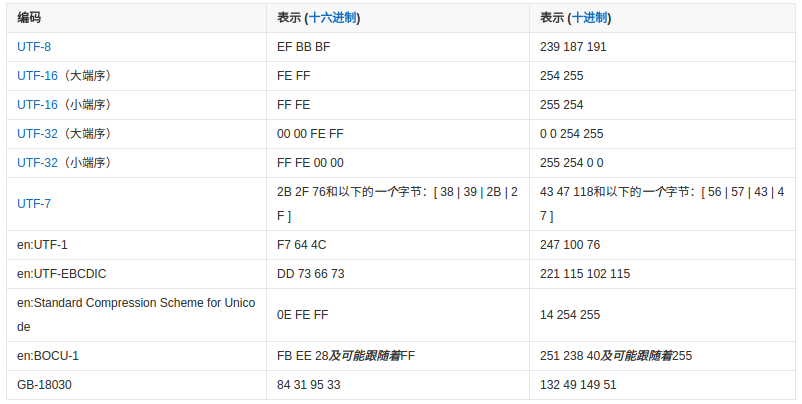
PHP并不会忽略UTF-8文件的BOM,所以在读取、包含或者引用这些文件时,会把BOM作为该文件开头正文的一部分。因此,PHP文件采用UTF-8编码时可保存无BOM格式。
如果U+FEFF出现在数据流中,该怎么办呢?下面这段来自Wikipedia,关于Word Joiner(WJ, U+2060):
The word joiner replaces the zero-width no-break space (ZWNBSP), a deprecated use of the Unicode character at code point U+FEFF. Character U+FEFF is intended for use as a Byte Order Mark at the start of a file. However, if encountered elsewhere it should, according to Unicode, be treated as a "zero-width non-breaking space." The deliberate use of U+FEFF for this purpose is deprecated as of Unicode 3.2, with the word joiner strongly preferred.
- UTF-8(万国码):它是可变长编码,即用1~4个字节来编码Unicode字符集。其与Unicode的转换关系如下:
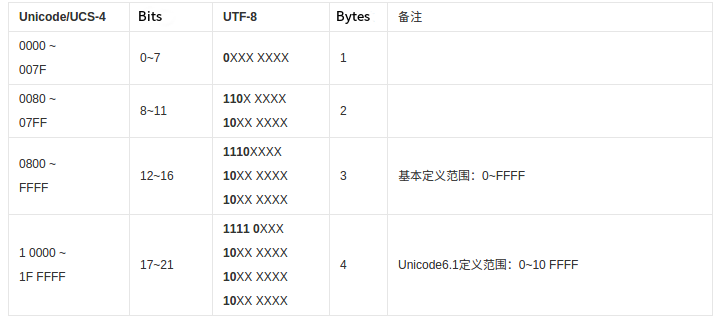
另外,以下部分非Unicode编码范围,属于UCS-4 编码早期的规范:

UTF-8用1个字节(U+0000~U+007F)来编码所有ASCII字符,并且与ASCII字符表示是一样的,故其与ASCII兼容,而那些ISO Latin-1扩展ASCII字符集的字符(128~255)是Unicode的子集,但不是UTF-8的子集;其他的字符UTF-8编码将需要2~4个字节,首字节连续的1的个数表示字符编码所需的字节数。“编”的Unicode编码是U+7F16,因此UTF-8需要3个字节来表示,形如1110xxxx 10xxxxxx 10xxxxxx这种格式。
由于UTF-8采用的是变长字符编码,与UTF-16和UTF-32相比,无论是计算字符数,还是执行索引操作效率都不高,因此UTF-8适合在传输数据中使用,可在数据接收完毕后将其转换为UTF-16或UTF-32进行处理,最后再转换回UTF-8(但这转换本身也会有性能损耗);但UTF-8空间足够大,无字节序问题,且容错性高,局部的字节错误(丢失、增加、改变)不会导致连锁性的错误,因为 UTF-8 的字符边界很容易检测出来。另外,utf8mb4是utf8的一个超集,支持最多4个字节来表示一个字符,如emoji表情字符就占用4个字节。
- UTF-16:以2个字节16bits为编码基本单位。假设U代表字符的Unicode编码,如果U < 0x10000且U∉[0xD800,0xDFFF],U的UTF-16编码就是U对应的16位无符号整数(0x00000~0xFFFF,除去0xD800-0xDFFF作为BMP的代理区部分);如果U ≥ 0x10000,则使U' = U - 0x10000(最大为0x10FFFF - 0x10000 = 0xFFFFF),然后将U'写成二进制形式:yyyy yyyy yyxx xxxx xxxx,U的UTF-16编码二进制表示就是:110110yyyyyyyyyy(0xD800~0xDBFF) 110111xxxxxxxxxx(0xDC00~0xDFFF)。由此可见,Unicode字符的UTF-16表示要么是2个字节长度,要么是4个字节长度,为将二者区分开来、防止冲突,设计者将0xD800-0xDFFF保留下来,称代理区(Surrogate):
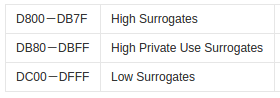
High Surrogates就是指这个范围的码位是Unicode字符4字节UTF-16编码的头两个字节;Low Surrogates就是指这个范围的码位是Unicode字符4字节UTF-16编码的后两个字节;High Private Use Surrogates是指这个范围的码位是Unicode字符4字节UTF-16编码的头两个字节,但该Unicode字符属于平面15和平面16这两个专用区 - UTF-32:用4个字节32bits来编码一个Unicode字符,Unicode的UTF-32编码就是其对应的32位无符号整数
- 更多信息参考链接:http://www.unicode.org/faq/utf_bom.html
Unicode 与 Unicode Transformation Format(UTF-8 / UTF-16 / UTF-32)的更多相关文章
- Unicode 与 Unicode Transformation Format(UTF,UTF-8 / UTF-16 / UTF-32)
ASCII(American Standard Code for Information Interchange):早期它使用7 bits来表示一个字符,总共表示27 = 128个字符:后来扩展到8 ...
- 细说Unicode(一) Unicode初认识
https://segmentfault.com/a/1190000007992346 细说Unicode(一) Unicode初认识 网站开发中经常会被乱码问题困扰.知道文件编码错误会导致乱码,但对 ...
- Ansi、GB2312、GBK、Unicode(utf8、16、32)
关于ansi,一般默认为本地编码方式,中文应该是gb编码 他们之间的关系在这边文章里描写的很清楚:http://blog.csdn.net/ldanduo/article/details/820353 ...
- js 中文汉字转Unicode、Unicode转中文汉字、ASCII转换Unicode、Unicode转换ASCII、中文转换&#XXX函数代码
最近看不少在线工具里面都有一些编码转换的代码,很多情况下我们都用得到,这里脚本之家小编就跟大家分享一下这些资料 Unicode介绍 Unicode(统一码.万国码.单一码)是一种在计算机上使用的字符编 ...
- 杂项-Unicode:Unicode
ylbtech-杂项-Unicode:Unicode Unicode(统一码.万国码.单一码)是计算机科学领域里的一项业界标准,包括字符集.编码方案等.Unicode 是为了解决传统的字符编码方案的局 ...
- java 中文转Unicode 以及 Unicode转中文
package com.sun; public class Snippet { public static void main(String[] args) { String cn ...
- .net C#实现 中文转Unicode、Unicode转中文 及与js对应关系
中文转Unicode:HttpUtility.UrlEncodeUnicode(string str); 转换后中文格式:"%uxxxx" 举例:"柳_abc123&q ...
- unicode和unicode编码
unicode编码是什么? 这其实是两个问题,unicode 是什么什么?unicode是怎样编码的? What is Unicode? Unicode provides a unique numbe ...
- JAVA中String.format的用法 转16进制,还可以补0
1.对整数进行格式化:%[index$][标识][最小宽度]转换方式 我们可以看到,格式化字符串由4部分组成,其中%[index$]的含义我们上面已经讲过,[最小宽度]的含义也很好理解, ...
随机推荐
- WPF实现Windows资源管理器(附源码)
今天我来写一篇关于利用WPF来实现Windows的资源管理器功能,当然只是局部实现这个功能,因为在很多时候我们需要来实现对本机资源的管理,当然我们可以使用OpenFileDialog dialog ...
- Python自动化运维之pexpect从入门到精通
1. 应用场景 模拟ssh, telnet远程登录, 模拟ftp文件上传 2. 安装 参考资料: <pexpect实例分析>https://www.ibm.com/developerwor ...
- Visual Studio常用插件整理
Visual Studio Tools for Git GIT代码管理工具 Resharper 代码生成工具 CSOutline2017 语法级别的代码折叠 ...
- 2.23日刷数论题后总结(题目整理自SCUT
第一道:Rightmost digit 求N^N次最后一个数字 快速幂mod10咯 代码如下: #include <cstdio> #define ll long long using n ...
- 【数学建模】day08-数理统计III
2. 回归分析 回归分析与曲线拟合区分. 曲线拟合是,根据得到的若干有关变量的一组数据,寻找因变量与(一个或几个)自变量之间的一个函数,使这个函数对那组数据拟合得好.通常,函数的形式可以由经验.先验知 ...
- mybatis,mysql批量delete多个记录
1.dao 接口中 Integer delete(List<UserDeviceRela> relas); 2.xml <delete id="delete" p ...
- Let's Encrypt免费泛域名证书申请
一. 下载acme.sh,以下四条命令任选一条即可 curl https://get.acme.sh | shwget -O - https://get.acme.sh | sh curl https ...
- SPOJ705-New Distinct Substrings-后缀数组
计算所都不相同子串的个数,做法是所有子串的个数减去sigma(height[]).其中height数组的和便是所有相同子串的个数. 注意 N×(N+1)/2会爆int!但是最终答案在int内.所以使用 ...
- P1495 曹冲养猪
原题链接 https://www.luogu.org/problemnew/show/P1495 这个题明显的中国剩余定理(孙子定理),如果有不懂孙子定理的点这个链接https://baike.bai ...
- 大学jsp实验5request,response
1.request对象的使用 (1)编写一个包含有表单的JSP页面form.jsp,其中包含可以输入姓名和出生地的文本框,提交表单后在另一个页面中显示用户提交的姓名和出生地.请写出相应代码: form ...