
Hadoop学习笔记(六):hive使用
1. 安装hive:上传apache-hive-2.1.1-bin.tar.gz文件到/usr/local目录下,解压后更名为hive。
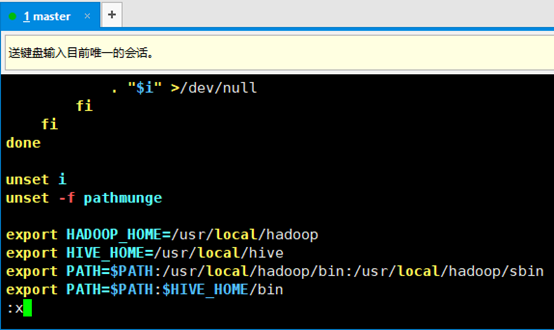
2. 配置hive环境变量,编辑/etc/profile文件(配置完后记得source /etc/profile使其生效)
3. 配置hive,进入到hive文件夹内,将hive-default.xml.template拷贝一份,命名为hive-site.xml,编辑它,将其中的hive.metastore.schema.verification属性设置为false(内容较多不方便,可是用查找命令,vim在非编辑状态下按/键,然后输入要搜索的内容,回车即可,按小写N键往后翻,按大写N键往前翻)

4. 创建/usr/local/hive/tmp目录,替换${system:java.io.tmpdir}为该目录(vim下使用替换命令,进入命令模式,输入%s#A#B#回车,即为将所有的A替换为B,按照此方式将所有的${system:java.io.tmpdir}替换为/usr/local/hive/tmp)
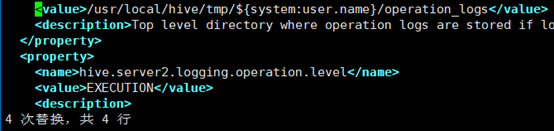
5. 同理,将所有${system:user.name}替换为登录用户,此处为root(共三处)
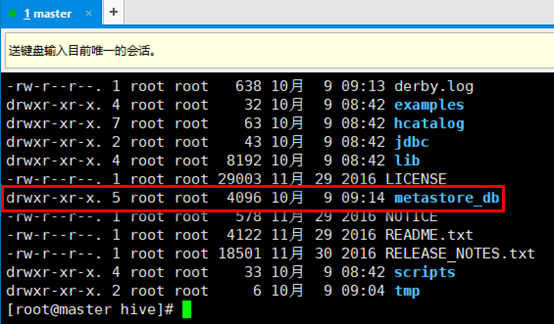
6. 进入/usr/local/hive目录下,执行schematool -initSchema -dbType derby命令。该命令会初始化derby数据库,该数据库中存放的是hive数据库的元数据,实际生产环境中可能用MySQL替换derby数据库,或者其他数据库,不过MySQL使用的较多。执行完该命令后,在hive目录下会多出一个metastore_db文件。(注意!!!下次执行hive时应该还在同一目录,derby默认会到当前目录下寻找metastore。如果遇到问题,把metastore_db删掉,重新执行命令)
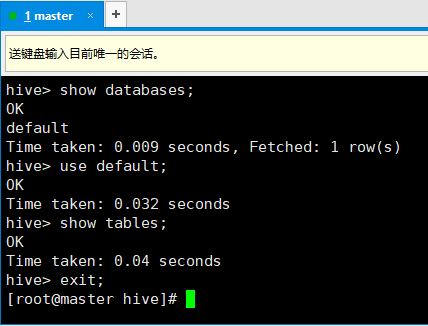
7. 启动hive(此时hadoop和yarn也要启动起来),直接输入hive回车即可。
8. 此后的操作和MySQL的命令行差不多:
9. 使用hive创建一张表:
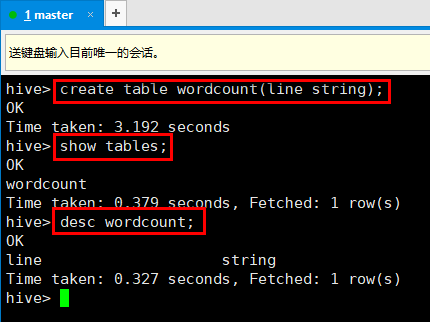
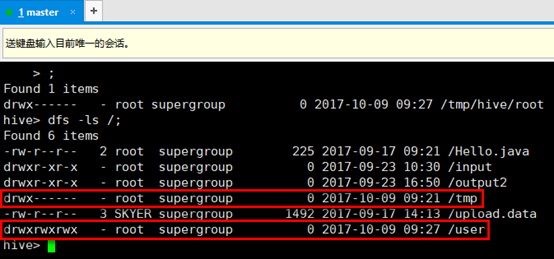
10. 可以直接在hive里执行hadoop语句,观察刚才创建的数据库,红框为刚才创建表时hive创建的目录,其中/user/hive/warehouse目录下有刚才的创建的表的信息。
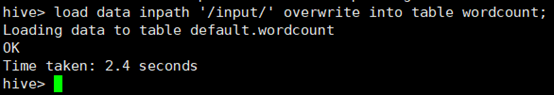
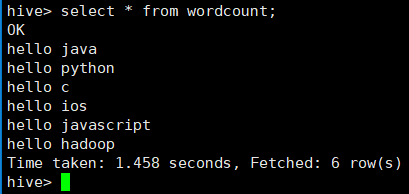
11. 往表里装数据,在hive命令模式下,输入load data inpath '/input/' overwrite into table wordcount;
其中/input/目录下有一个txt文件,内容如下:
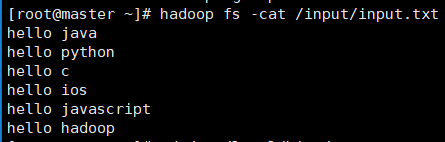
12. 上一步操作即为将/input/input.txt这个文件和wordcount这张表建立一个关联,查询这张表的时候,就会通过hdfs查询到该文件的内容。
13. 下面使用hive执行上一节中wordcount程序,直接在hive命令模式写输入:select word, count(*) num from (select explode(split(line, ' ')) as word from wordcount) w group by word;其中,split为分割,即将line字段按照空格进行分割,expode函数的作用是,将数组中每一个元素作为单独的一行进行输出。该sql语句的执行结果如下图:
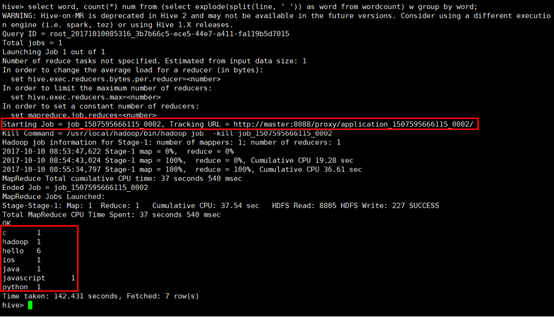
可以看出,该sql语句实际上执行MapReduce成功,开启了一个job,和上一节中编写的java代码是一个效果。
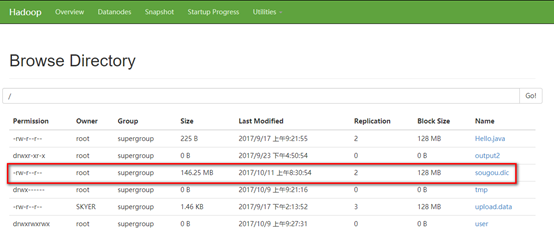
14. 下面用hive分析一个实际当中的日志文件,将该文件上传至hadoop根目录(该文件为搜狗的搜索日志文件)
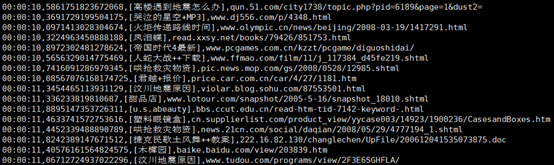
该文件的内容大致如下图,其格式为搜索时间+搜索ID+搜索内容+结果URL,期间都是用逗号隔开。
15. 创建一张表,用来装载sougou.dic的数据,然后对这张表进行操作。进入hive命令模式,输入命令:
create table sougou (qtime string, qid string, qword string, url string) row format delimited fields terminated by ',';
其中,row format delimited fields terminated by ','表示将每一行用逗号进行分割,分别作为一个字段。
16. 装载数据,将sougou.dic里的数据装载到刚才创建的表里(不是将里边的内容装载到了表里,而是在它们两者之间建立了一种联系)。输入命令:
load data inpath '/sougou.dic' into table sougou;
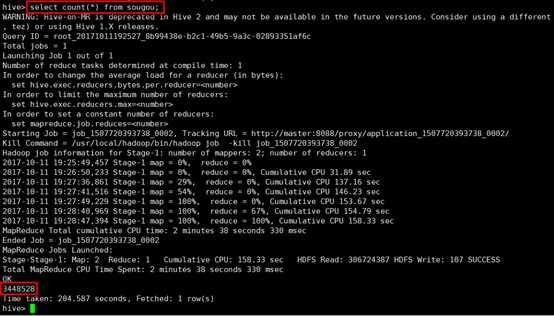
17. 下面就可以通过这个张表来操作这个日志文件了,先统计一下一共有多少条记录(由于这个日志文件有146M,而hadoop默认块大小为128M,因此操作这张表的时候一般会启动MapReduce程序),输入select count(*) from sougou;观察结果:
18. 下面来查询热搜榜,首先创建一张表,用来记录搜索的关键字和该关键字的搜索次数,按照由大到小排序,输入HQL语句:
create table sougou_results as select keyword, count(1) as count from (select qword as keyword from sougou) t group by keyword order by count desc;
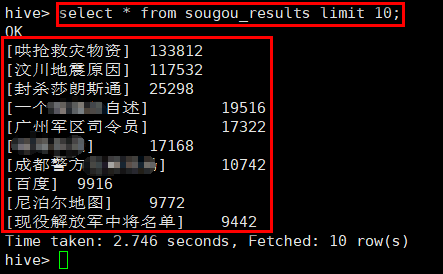
19. 接下来查询热搜榜前十名的搜索记录,输入HQL语句,并观察执行结果:
select * from sougou_results limit 10;
Hadoop学习笔记(六):hive使用的更多相关文章
- Hadoop学习笔记—17.Hive框架学习
一.Hive:一个牛逼的数据仓库 1.1 神马是Hive? Hive 是建立在 Hadoop 基础上的数据仓库基础构架.它提供了一系列的工具,可以用来进行数据提取转化加载(ETL),这是一种可以存储. ...
- hadoop学习笔记-目录
以下是hadoop学习笔记的顺序: hadoop学习笔记(一):概念和组成 hadoop学习笔记(二):centos7三节点安装hadoop2.7.0 hadoop学习笔记(三):hdfs体系结构和读 ...
- Hadoop学习笔记系列
Hadoop学习笔记系列 一.为何要学习Hadoop? 这是一个信息爆炸的时代.经过数十年的积累,很多企业都聚集了大量的数据.这些数据也是企业的核心财富之一,怎样从累积的数据里寻找价值,变废为宝炼 ...
- Hadoop学习笔记—22.Hadoop2.x环境搭建与配置
自从2015年花了2个多月时间把Hadoop1.x的学习教程学习了一遍,对Hadoop这个神奇的小象有了一个初步的了解,还对每次学习的内容进行了总结,也形成了我的一个博文系列<Hadoop学习笔 ...
- Hadoop学习笔记(7) ——高级编程
Hadoop学习笔记(7) ——高级编程 从前面的学习中,我们了解到了MapReduce整个过程需要经过以下几个步骤: 1.输入(input):将输入数据分成一个个split,并将split进一步拆成 ...
- Hadoop学习笔记(6) ——重新认识Hadoop
Hadoop学习笔记(6) ——重新认识Hadoop 之前,我们把hadoop从下载包部署到编写了helloworld,看到了结果.现是得开始稍微更深入地了解hadoop了. Hadoop包含了两大功 ...
- Hadoop学习笔记(2)
Hadoop学习笔记(2) ——解读Hello World 上一章中,我们把hadoop下载.安装.运行起来,最后还执行了一个Hello world程序,看到了结果.现在我们就来解读一下这个Hello ...
- Hadoop学习笔记(5) ——编写HelloWorld(2)
Hadoop学习笔记(5) ——编写HelloWorld(2) 前面我们写了一个Hadoop程序,并让它跑起来了.但想想不对啊,Hadoop不是有两块功能么,DFS和MapReduce.没错,上一节我 ...
- Hadoop学习笔记(3)——分布式环境搭建
Hadoop学习笔记(3) ——分布式环境搭建 前面,我们已经在单机上把Hadoop运行起来了,但我们知道Hadoop支持分布式的,而它的优点就是在分布上突出的,所以我们得搭个环境模拟一下. 在这里, ...
- Hadoop学习笔记(2) ——解读Hello World
Hadoop学习笔记(2) ——解读Hello World 上一章中,我们把hadoop下载.安装.运行起来,最后还执行了一个Hello world程序,看到了结果.现在我们就来解读一下这个Hello ...
随机推荐
- redis学习-集合set常用命令
redis学习-集合set常用命令 1.sadd:添加一个元素到集合中(集合中的元素无序的并且唯一) 2.smembers:查看集合中所有的元素(上图事例) 3.srem:删除结合中指定的元素 4 ...
- $("").append无反应
网页中F12看控制台提示“ReferenceError: $ is not defined” 解决: script src路径出了问题,改为 <script type="text/ja ...
- JavaWeb三大组件之Filter
对请求或者响应进行拦截,并做额外的逻辑处理 filter能在一个请求访问目标资源之前对其进行拦截然后做某些逻辑处理,例如权限检查,也可以在一个输出响应到达客户端之前对其进行拦截并做一些额外的操作(例如 ...
- 自学Python第一天
大学毕业后在一家第三方小程序公司做客服,心有不甘,看着同学们有做安防售前的,有在政府.企业里面做网络工程师的.更有甚者天天搭建个云计算啥的都是家常便饭,再想想自己,堂堂网络工程专业,却做了客服,还是没 ...
- python 单例模式的四种实现方法及注意事项
一.模块单例 Python 的模块就是天然的单例模式,因为模块在第一次导入时,会生成 .pyc 文件,当第二次导入时,就会直接加载 .pyc 文件,而不会再次执行模块代码. #foo1.py clas ...
- CentOS---zabbix使用sendEamil发送报警
一.sendEmail简介 sendEmail是一个轻量级,命令行的SMTP邮件客户端.如果你需要使用命令行发送邮件,那么sendEmail是非常完美的选择:使用简单并且功能强大.这个被设计用在php ...
- Exp6 信息搜集与漏洞扫描——20164325王晓蕊
1.实践目标 掌握信息搜集的最基础技能与常用工具的使用方法. 2.实践内容 2.1 各种搜索技巧的应用 2.1.1 Netcraft查询 Netcraft这个网站可以查询到特定网站的IP地址,以wei ...
- 继承Thread类和实现Runnable接口
一.采用继承Thread类方法的特点: 优势:编写简单,如果需要访问当前的线程,只需要使用this,并可以在run()方法中调用其他线程的方法: 劣势:线程已经继承了Thread类,不能继承其他的父类 ...
- mysql case when then else end 的写法
select t.colum1,t.colum2 (case when t.colum1 = '' then '' t.when colum2 = '' then '' else '' end ) a ...
- Android学习笔记(1):常用按钮点击事件处理方式
1.从布局文件获取对应的控件然后对其添加点击监听器. Button loginBtn; @Override protected void onCreate(Bundle savedInstanceSt ...