
Centos7安装Hadoop2.7
准备
1、三台Centos7的机器:
| hostname | IP地址 | 部署规划 |
| node1 | 172.20.0.4 | NameNode、DataNode |
| node2 | 172.20.0.5 | DataNode |
| node3 | 172.20.0.6 | DataNode |
在/etc/hosts中都加上主机名解析:
172.20.0.4  node1

172.20.0.5  node2

172.20.0.6  node3
2、配置node1到三台机器的免密登录。
3、全部安装jdk8,配置JAVA_HOME。
4、官网下载安装包:hadoop-2.7.7.tar.gz(推荐去清华大学或中科大的开源镜像站)。
6、三台都创建路径/mydata/,并配置环境变量:
export HADOOP_HOME=/mydata/hadoop-2.7.

export PATH=${HADOOP_HOME}/bin:${HADOOP_HOME}/sbin:$PATH
配置
先在node1上修改hadoop的配置,完成后再统一复制到其他节点,保证配置内容一致。
解压hadoop-2.7.7.tar.gz到/mydata/,进入/mydata/hadoop-2.7.7/etc/hadoop/,进行配置(有些文件需要去掉,template后缀,或拷贝一份重命名):
<!-- 文件名 core-site.xml -->
<configuration>

    <property>

        <name>fs.defaultFS</name>

        <value>hdfs://node1:9000</value>

    </property>

    <property>

        <name>hadoop.tmp.dir</name>

        <value>/mydata/data/hadoop-${user.name}</value>

    </property>

</configuration>
<!-- 文件名 hdfs-site.xml -->

<configuration>

    <property>

        <name>dfs.replication</name>

        <value></value>

    </property>

</configuration>
<!-- 文件名 mapred-site.xml 拷贝自mapred-site.xml.template -->

<configuration>

    <property>

        <name>mapreduce.framework.name</name>

        <value>yarn</value>

    </property>

</configuration>
<!-- 文件名 yarn-site.xml -->

<configuration>

    <property>

        <name>yarn.nodemanager.aux-services</name>

        <value>mapreduce_shuffle</value>

    </property>
    <property>
        <name>yarn.resourcemanager.hostname</name>
        <value>node1</value>
    </property>
</configuration>
<!-- 文件名 slaves -->

node1

node2

node3
| 配置项 | 含义 |
| fs.defaultFS | namenode上文件系统的地址 |
| hadoop.tmp.dir | 多个路径的基础,包括namenode和datanode的数据,默认是/tmp/hadoop-${user.name} |
| dfs.replication | 副本数,这里设为2,这样集群中共三份数据,适用日常大部分情况了 |
| yarn.resourcemanager.hostname | yarn资源管理器所在host |
| slaves | 该文件中列出的是作为从节点的datanode,若node1只打算作为namenode则不需要写进去 |
默认日志目录在$HADOOP_HOME/logs,pid文件在/tmp,可以进行修改:
# 文件名 hadoop-env.sh

export HADOOP_PID_DIR="/mydata/data/pid"

export HADOOP_LOG_DIR="/mydata/logs/hadoop"
# 文件名 yarn-env.sh

export YARN_LOG_DIR="/mydata/logs/yarn"

export YARN_PID_DIR="/mydata/data/pid"
配置完成后将hadoop程序文件拷贝到其他两台:
node1> scp -r /mydata/hadoop-2.7.7/ root@node2:/mydata/

node1> scp -r /mydata/hadoop-2.7.7/ root@node3:/mydata/
启动
需要先在node1初始化namenode(只有第一次启动前需要,除非删除了hadoop.tmp.dir下namenode的数据):
node1> hdfs namenode -format
看到 Storage directory /mydata/data/hadoop-root/dfs/name has been successfully formatted. 则表示成功。
下面先启动hdfs,后启动yarn:
node1> start-dfs.sh

node1> start-yarn.sh
| node1上用jps命令验证进程 |
NameNode、SecondaryNameNode、ResourceManager、DataNode、NodeManager |
| node2上用jps命令验证进程 |
DataNode、NodeManager |
| node3上用jps命令验证进程 |
DataNode、NodeManager |
测试
通过浏览器可以访问以下地址:
| namenode的后台 | http://node1:50070 |
| yarn资源管理的后台 | http://node1:8088 |
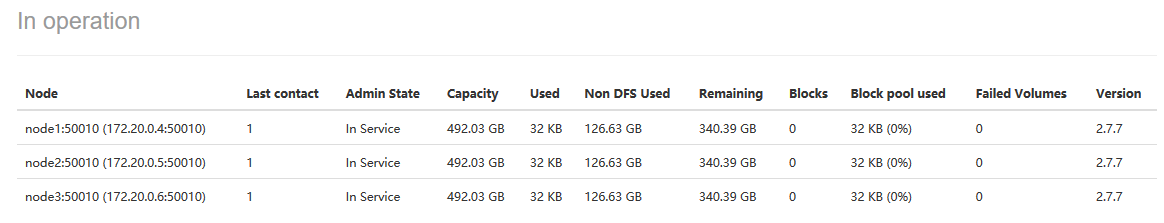
前者切换到 Datanodes :
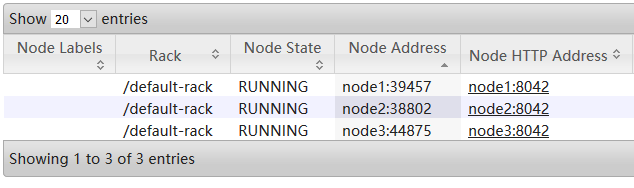
后者进入 Cluster -> Nodes :
下面执行一个官方示例(wordcount),先准备两个文件,内容如下:
# 文件名 1.txt

天空    sky

天空    sky

天空    sky

# 文件名 .txt

海洋    ocean

海洋    ocean
将这两个文件上传到hdfs,然后执行任务:
# 创建路径(将root改为自己的用户名)
node1> hdfs dfs -mkdir -p /user/root/input
# 上传文件
node1> hdfs dfs -put *.txt input
# 执行wordcount任务统计文件中每个单词的数量,并等待其执行结束
node1> hadoop jar $HADOOP_HOME/share/hadoop/mapreduce/hadoop-mapreduce-examples-2.7.7.jar wordcount input output
# 查看结果
node1> hdfs dfs -cat output/*
ocean  2
sky   3
天空   3
海洋   2
# 若要重复执行任务,需要删除output文件夹,或者在命令中换一个输出目录
node1> hdfs dfs -rm -r output
可以在yarn的资源管理平台 Cluster -> Applications 查看到该任务:

启用jobhistory
这个不是必须的,但可以更好的查看job的历史记录和管理job的日志。
# 文件名 mapred-env.sh

export HADOOP_MAPRED_LOG_DIR="/mydata/logs/mapred"

export HADOOP_MAPRED_PID_DIR="/mydata/data/pid"
<!-- 文件名 mapred-site.xml -->

    <property>

        <name>mapreduce.jobhistory.address</name>

        <value>node1:</value>

    </property>
<!-- 文件名 yarn-site.xml 日志聚合,开启后job的日志不再存到node本地,而是上传到hdfs -->

    <property>

        <name>yarn.log-aggregation-enable</name>

        <value>true</value>

    </property>
停止集群:
node1> stop-yarn.sh

node1> stop-dfs.sh
然后将修改的配置同步更新到其他所有节点,并在启动集群后启动historyserver:
node1> start-dfs.sh

node1> start-yarn.sh

node1> mr-jobhistory-daemon.sh start historyserver
# 通过jps查看进程
node1> jps
...
[pid]  JobHistoryServer
...
通过浏览器访问 http://node1:19888 :
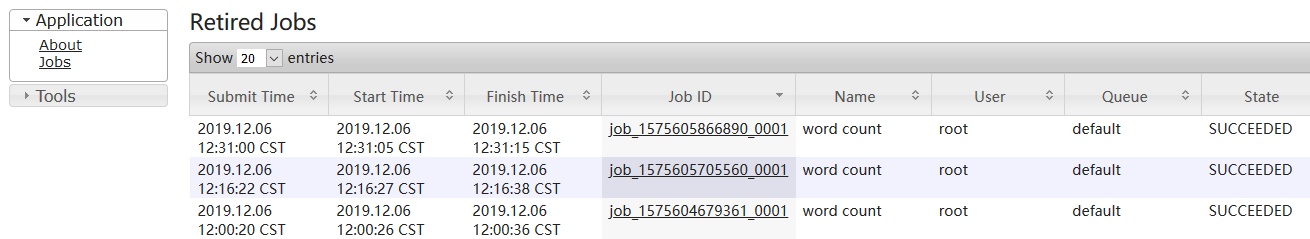
默认情况下,日志会分散在各个工作的datanode,查看非常麻烦;配置了日志聚合后则会上传到hdfs,各节点本地的会被删除,可以点击上图的 Job ID ,然后 ApplicationMaster -> logs 即可看到聚合后的日志:

在yarn的资源管理后台 http://node1:8088/cluster/apps ,点击 application 后面的 History 就可以跳转到 jobhistory:

另外,还可以通过命令行查看聚合日志:
shell> yarn logs -applicationId [application id]
yarn的资源管理后台 http://node1:8088/cluster/apps 直接就能看到 application id,而在 jobhistory 中只要将 Job ID 的job前缀替换为application即可。
over
Centos7安装Hadoop2.7的更多相关文章
- CentOS7安装Hadoop2.7完整流程
总体思路,准备主从服务器,配置主服务器可以无密码SSH登录从服务器,解压安装JDK,解压安装Hadoop,配置hdfs.mapreduce等主从关系. 1.环境,3台CentOS7,64位,Hadoo ...
- CentOS7安装Hadoop2.7完整步骤
总体思路,准备主从服务器,配置主服务器可以无密码SSH登录从服务器,解压安装JDK,解压安装Hadoop,配置hdfs.mapreduce等主从关系. 1.环境,3台CentOS7,64位,Hadoo ...
- CentOS7安装Hadoop2.7流程
准备3个虚拟机节点 其实这一步骤非常简单,如果你已经完成了第2步,此时你已经准备好了第一个虚拟节点,那第二个和第三个虚拟机节点如何准备?可能你已经想明白了,你可以按第2步的方法,再分别安装两遍lin ...
- centos7安装hadoop2.6.1,详细教程
1.我搭建的是三台centos7的环境 首先准备三个centos7(文中出现的所有的链接都是我自己的) centos7下载地址(也可以上官网自行下载):https://pan.baidu.com/s/ ...
- centos7 安装Hadoop-2.6.0-cdh5.16.1.tar.gz
准备Hadoop-2.6.0-cdh5.16.1.tar.gz 下载网址 http://archive.cloudera.com/cdh5/cdh/5/Hadoop-2.6.0-cdh5.16.1.t ...
- centos7安装hadoop2.7.7
下载hadoop-2.7.7 网址如下 https://www-eu.apache.org/dist/hadoop/core/ 移动到/opt 路径下 在/opt下新建一个文件夹,名为app mkdi ...
- 原创centos7安装hadoop2.7(转载请注明出处)
启用ip vi /etc/sysconfig/network-scripts/ifcfg-ONBOOT=yes 编辑DNS /etc/resolv.conf nameserver 114.114.11 ...
- centos7 安装hadoop2.7.6(分布式)
本文只做简单介绍,具体步骤操作请参考centos6.5 安装hadoop1.2.1亲测版 本篇只简单介绍安装步骤 1.安装目录 /usr/local/hadoop (HADOOP_HOME) 2,创建 ...
- Centos7安装Spark2.4
准备 1.hadoop已部署(若没有可以参考:Centos7安装Hadoop2.7),集群情况如下(IP地址与之前文章有变动): hostname IP地址 部署规划 node1 172.20.0.2 ...
随机推荐
- Python的基本数据类型2
1.str(字符串) 1.切片 str = "你好,我是Python" s = str[0:4] #用法[start:end:step],指定开始下标和结束下标,step是步长,默 ...
- day23——继承
day23 初识继承 字面意思:儿子可以完全使用父亲的所有内容 专业角度:如果B类继承A类, B类就称为子类.派生类 A类就称为父类.基类.超类 面向对象三大特性:继承.封装.多态 继承:单继承.多继 ...
- 1. Spark GraphX概述
1.1 什么是Spark GraphX Spark GraphX是一个分布式图处理框架,它是基于Spark平台提供对图计算和图挖掘简洁易用的而丰富的接口,极大的方便了对分布式图处理的需求.那么什么是图 ...
- 解决clover配置文件conf.plist中nv_disable=1或者nvda_drv=1不生效或者说不能删除的问题
情况一:U盘安装MacOS的时候conf.plist中设置了nv_disable=1,但是启动的时候任然显示nvda_drv=1. 这种情况一般出现在该机器曾经安装过MacOS,MacOS会将这个参数 ...
- eclipse不提示问题
按照上面截图输入26个字母大小写,即可.
- 没有足够的内存继续执行程序(mscorlib)
原文:https://blog.csdn.net/yao940622/article/details/79690953 问题描述: 在Microsoft SQL Server Management S ...
- The underlying connection was closed: An unexpected error occurred on a rece
服务器问题,在后台访问外网了,特别是https的网站,容易出这个问题. 修改服务器配置,或修改代码解决.
- Docker 四种网络模式
原文 https://www.cnblogs.com/gispathfinder/p/5871043.html 我们在使用docker run创建Docker容器时,可以用--net选项指定容器的网络 ...
- 自学Python编程的第一天----------来自苦逼的转行人
学习Python的第一天,也是我第一次写博客的一天,不怎么会写博客,也不怎么会Python,也不怎么会写总结.在学Python的第一天发现自己脑子不是很好用,在学习过程中出现很多错误,错误锦集如下,哈 ...
- pandas-08 pd.cut()的功能和作用
pandas-08 pd.cut()的功能和作用 pd.cut()的作用,有点类似给成绩设定优良中差,比如:0-59分为差,60-70分为中,71-80分为优秀等等,在pandas中,也提供了这样一个 ...