
常用文件操作模块json,pickle、shelve和XML
一、json 和 pickle模块
用于序列化的两个模块
- json,用于字符串 和 python数据类型间进行转换
- pickle,用于python特有的类型 和 python的数据类型间进行转换
Json模块提供了四个功能:dumps、dump、loads、load
pickle模块提供了四个功能:dumps、dump、loads、load
例子:
json序列化:
import json
info = {
    'name':'lxj',
    'age':27
}

with open('text.json','w') as f:
    f.write(json.dumps(info))   #这句话等同于json.dump(info,f)
把内容写到文件中,字符串存储的形式为"",''是错误的,这里需要注意

json反序列化:
import json

with open("text.json",'r') as f:
    data = json.loads(f.read())  #这句话等同于data = json.load(f)
    print(data.get('age'))       #不用做任何转换就可以读取字典,读取字典age内容 27

注意:这里如果用json.loads(s),这里只能传入字符串。上面的例子,虽然data读出来是字典,但是f.read()是字符串
import json

fp = open('test.json','w',encoding='utf-8')

json.dump(["alex", 123, 'eric'],fp)

fp.close()

fp = open('test.json','r',encoding='utf-8')

s = fp.read()

print(s,type(s))

s = json.loads(s)

print(s,type(s))
json总结:json在所有语言都通用,只能保存简单数据类型,如字典、列表、字符串。像函数、类则不能存储。这里注意只dump一次(虽然可以dump多次,但别这么用),只load一次(在3.x模式下)

pickle序列化
pickle:只能在python中用,用法与上面一致,可以序列化函数、类
如:
pickle序列化:
import pickle

def sayhi(name):
    print("name is %s"%name)

info = {
    'name':'lxj',
    'age':28,
    "func":sayhi          #序列化sayhi函数对象
}

with open('text.text','wb') as f:   #这里注意要用二进制模式写。
    pickle.dump(info,f)
pickle反序列化:
import pickle

def sayhi(name):               #在pickle序列化时,是序列化整个对象。伴随程序运行完结束,sayhi指向的内存地址就释放了。我们这里再调用就会出错,所以一定要定义sayhi函数,我们调用func()才有用。没什么用。
    print("name is %s"%name)  #函数体可以变成其他内容

with open("text.text",'rb') as f: #这里注意要用二进制模式读。,
    data = pickle.load(f)
    print(data.get('func')('lxj')) #运行函数

二、shelve模块
shelve模块是一个简单的k,v将内存数据通过文件持久化的模块,可以持久化任何pickle可支持的python数据格式

shelve模块写:
import shelve

f = shelve.open('shelve_text')  #这里注意文件名不能加后缀(如.text,.json都是不行的)

names = ["lxj","sx"]
infos = {
    'name':'lxj',
    'age':27
}

f['name'] = names
f['info'] = infos
执行完成后会生成三个文件,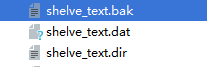
shelve模块读:
import shelve

f = shelve.open('shelve_text')

print(f['name'])
print(f['info'])

总结:相当于可以dump多次,load多次

三、XML模块
xml是实现不同语言或程序之间进行数据交换的协议,跟json差不多,但json使用起来更简单,不过,古时候,在json还没诞生的黑暗年代,大家只能选择用xml呀,至今很多传统公司如金融行业的很多系统的接口还主要是xml。
xml的格式如下,就是通过<>节点来区别数据结构的(类似于字典):
<?xml version="1.0"?>
<data> <country name="Liechtenstein"> <rank updated="yes">2</rank> <year>2008</year> <gdppc>141100</gdppc> <neighbor name="Austria" direction="E"/> <neighbor name="Switzerland" direction="W"/> </country> <country name="Singapore"> <rank updated="yes">5</rank> <year>2011</year> <gdppc>59900</gdppc> <neighbor name="Malaysia" direction="N"/> </country> <country name="Panama"> <rank updated="yes">69</rank> <year>2011</year> <gdppc>13600</gdppc> <neighbor name="Costa Rica" direction="W"/> <neighbor name="Colombia" direction="E"/> </country></data>import xml.etree.ElementTree as ET
tree = ET.parse("text_xml.xml") #打开文件
root = tree.getroot() #获取根节点
print(root.tag) #获取根节点标签 ,结果data
#遍历XML文档
# for child in root: #遍历子节点
# print(child.tag,child.attrib) #打印子节点的标签,属性
# for i in child: #遍历子节点下的数据
# print("\t",i.tag,i.attrib,i.text) #打印子节点下的标签,属性,及文本
#过滤neighbor数据
# for node in root.iter('neighbor'): #遍历子节点下所有neighbor的数据
# print(node.tag,node.attrib,node.text)
# #过滤子节点下的neighbor数据
# for child in root:
# print(child.tag)
# for i in child.iter('neighbor'):
# print("\t",i.tag,i.attrib,i.text)
#修改数据
# for child in root: #遍历子节点
# if child.attrib['name'] == 'Liechtenstein': #过滤出子节点属性name为Liechtenstein的节点
# for i in child.iter('year'): #在该子节点下过滤出year的数据
# i.text = '2018' #修改文本
# i.set("abc","123") #修改属性
#
# tree.write('text1.xml') #写入文件
#删除node
# for country in root.findall('country'): ##遍历所有country子节点
# rank = int(country.find('rank').text) #找到counrry下的rank的文本
# if rank >50:
# root.remove(country) #移除country节点
# tree.write('text1.xml') #写入文件
#创建xml文件
namelist = ET.Element("NameList") #创建一个根节点
name = ET.SubElement(namelist,"name",attrib={"whatever":'yes',"name":"lxj"}) #创建一个子节点并添加属性
age = ET.SubElement(name,'age') #添加节点至name子节点下
age.text = '26' #为该节点添加文件信息
role = ET.SubElement(name,'role')
role.text = 'teacher'
et = ET.ElementTree(namelist) #生成文档对象
et.write("text3.xml",encoding="utf-8",xml_declaration=True) #写入文件
常用文件操作模块json,pickle、shelve和XML的更多相关文章
- 保存数据到文件的模块(json,pickle,shelve,configparser,xml)_python
一.各模块的主要功能区别 json模块:将数据对象从内存中完成序列化存储,但是不能对函数和类进行序列化,写入的格式是明文. (与其他大多语言交互的类型) pickle模块:将数据对象从内存中完成序列 ...
- python 常用模块 time random os模块 sys模块 json & pickle shelve模块 xml模块 configparser hashlib subprocess logging re正则
python 常用模块 time random os模块 sys模块 json & pickle shelve模块 xml模块 configparser hashlib subprocess ...
- python 全栈开发,Day25(复习,序列化模块json,pickle,shelve,hashlib模块)
一.复习 反射 必须会 必须能看懂 必须知道在哪儿用 hasattr getattr setattr delattr内置方法 必须能看懂 能用尽量用__len__ len(obj)的结果依赖于obj. ...
- python模块--json \ pickle \ shelve \ XML模块
一.json模块 之前学习过的eval内置方法可以将一个字符串转成一个python对象,不过eval方法时有局限性的,对于普通的数据类型,json.loads和eval都能用,但遇到特殊类型的时候,e ...
- 模块 - json/pickle/shelve/xml/configparser
序列化: 序列化是指把内存里的数据类型转变成字符串,以使其能存储到硬盘或通过网络传输到远程,因为硬盘或网络传输时只能接受bytes. 为什么要序列化: 有种办法可以直接把内存数据(eg:10个列表,3 ...
- python开发模块基础:序列化模块json,pickle,shelve
一,为什么要序列化 # 将原本的字典.列表等内容转换成一个字符串的过程就叫做序列化'''比如,我们在python代码中计算的一个数据需要给另外一段程序使用,那我们怎么给?现在我们能想到的方法就是存在文 ...
- python序列化模块 json&&pickle&&shelve
#序列化模块 #what #什么叫序列化--将原本的字典.列表等内容转换成一个字符串的过程叫做序列化. #why #序列化的目的 ##1.以某种存储形式使自定义对象持久化 ##2.将对象从一个地方传递 ...
- python_ 模块 json pickle shelve
一,什么是模块? 常见的场景:一个模块就是一个包含了python定义和声明的文件,文件名就是模块名字加上.py的后缀. 但其实import加载的模块分为四个通用类别: 1 使用python编写的代码( ...
- 常用模块(json/pickle/shelve/XML)
一.json模块(重点) 一种跨平台的数据格式 也属于序列化的一种方式 介绍模块之前,三个问题: 序列化是什么? 我们把对象(变量)从内存中变成可存储或传输的过程称之为序列化. 反序列化又是什么? 将 ...
随机推荐
- 关于a标签的onclick和href谁先执行的问题
今天上午遇到一个问题,我想在a标签跳转的时候增加一些程序上的判断,但又不会影响a标签的正常跳转,于是就有了这篇文章. 我的具体代码是这样的: <a href="http://www.m ...
- 在echars上发布的半圆环形图
http://gallery.echartsjs.com/editor.html?c=xBJvoMcPfz&v=1
- hdu 5040 Instrusive【BFS+优先队列】
11733274 2014-09-26 12:42:31 Accepted 5040 62MS 1592K 4848 B G++ czy 先转一个优先队列的用法: http://www.cppblog ...
- excel批量导入数据库SQL server
思路: 第一是文件上传,可以参照Jakarta的FileUpload组件,用普通的Post也就行了.第二是Excel解析,用JSL或者POI都行第三是数据保存,这个应该简单吧,一个循环,一行对应一条数 ...
- pandaboard安装ubuntu14.04系统遇到的问题
按照该网址步骤安装https://www.eewiki.net/display/linuxonarm/PandaBoard 在linux kernel的./build_kernel.sh时,自动安装交 ...
- Java 一个?格式的解决
用Java 出现了这样的一个问题?好几天都没解决掉 然后最近一直找资料 截个图: 本来格式中时没有这个?号的,代码里面用GBK和utf-8都不能解决. 即使我加了 Str.trim(Str)去除 字符 ...
- 紫书p199 八数码(BFS,hash)
八数码问题 紫书上的简单搜索 渣渣好久才弄懂 #include<cstdio> #include<cstring> using namespace std; const i ...
- Android的activity的生命周期
activity的生命周期有四个重要的状态:活动,暂停,停止,销毁 基本的方法有:onCreate.onStart.onResume.onPause.onStop.onDestory 最经常使用的方法 ...
- C# step by step 学习笔记8 CHAPTER 9 使用枚举和结构创建值类型
C# 2012 step by step 学习笔记8 CHAPTER 9 使用枚举和结构创建值类型 本章内容 声明一个枚举类型 创建并使用一个枚举类型 声明一个结构类型 创建并使用一个结构类型 解释结 ...
- reorder-list——链表、快慢指针、逆转链表、链表合并
Given a singly linked list L: L0→L1→…→Ln-1→Ln,reorder it to: L0→Ln→L1→Ln-1→L2→Ln-2→… You must do thi ...