
CvT: Introducing Convolutions to Vision Transformers-首次将Transformer应用于分类任务
CvT: Introducing Convolutions to Vision Transformers
Paper:https://arxiv.org/pdf/2103.15808.pdf
Code:https://github.com/rishikksh20/convolution-vision-transformers/
Motivation:在相似尺寸下,VIT的性能要弱于CNN架构;VIT所需的训练数据量要远远大于CNN模型
CvT将卷积引入Transformer,总架构是一个multi-stage的hierarchical的结构:
首先embedding的方式变成了卷积操作,在每个Multi-head self-attention之前都进行Convolutional Token Embedding。其次在 Self-attention的Projection操作不再使用传统的Linear Projection,而是使用Convolutional Projection。
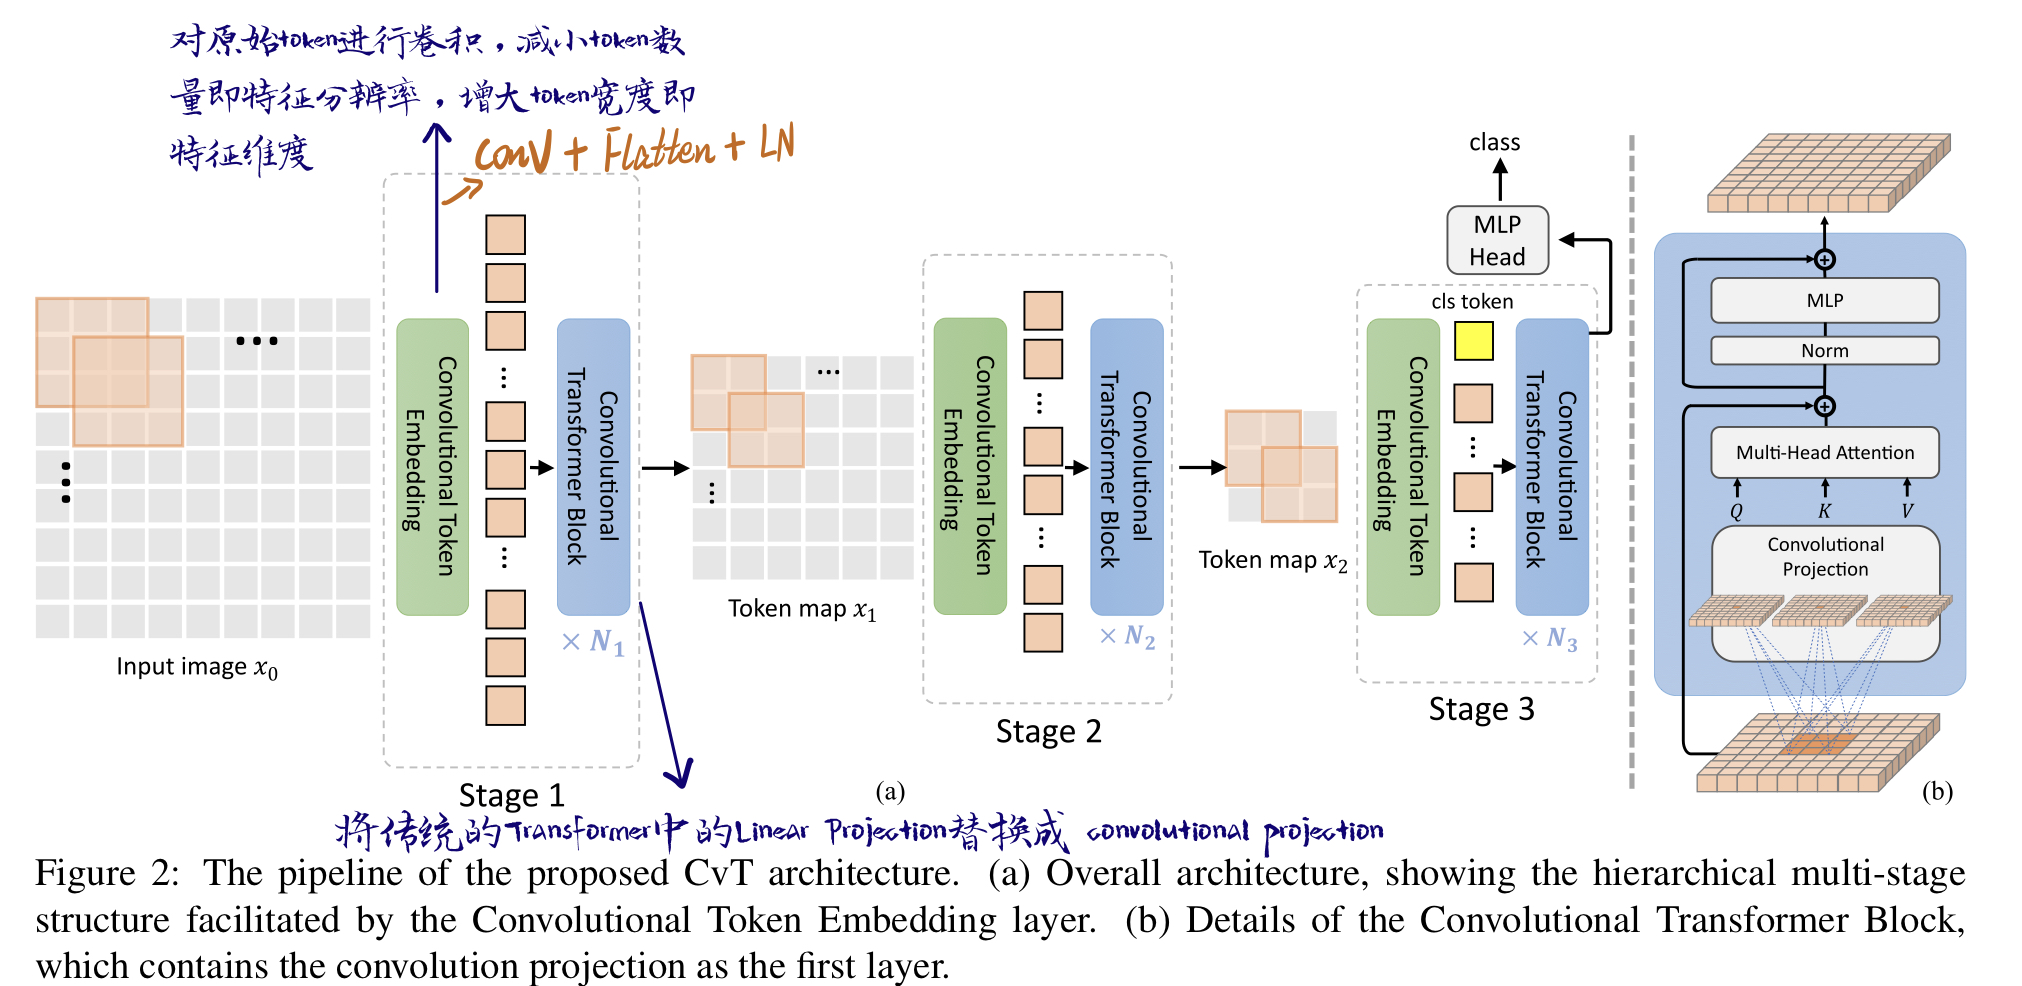
Linear Projection->convolutional Projection
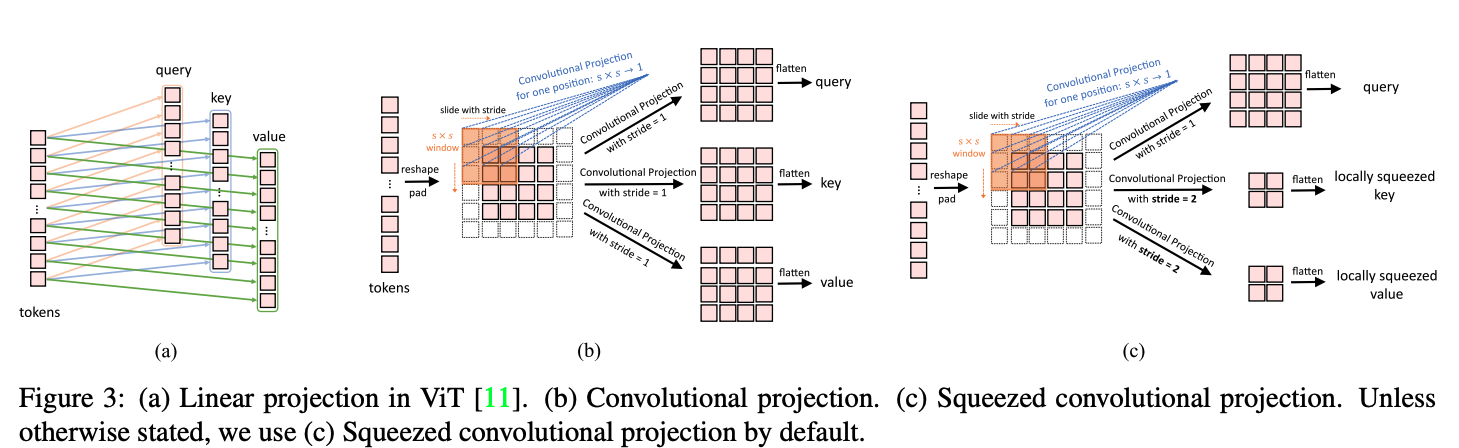
(c)这一步可以补偿分辨率下降的损失
为什么不用位置编码:卷机操作的zero-padding暗含位置信息
CvT: Introducing Convolutions to Vision Transformers-首次将Transformer应用于分类任务的更多相关文章
- How Do Vision Transformers Work?[2202.06709] - 论文研读系列(2) 个人笔记
[论文简析]How Do Vision Transformers Work?[2202.06709] 论文题目:How Do Vision Transformers Work? 论文地址:http:/ ...
- EdgeFormer: 向视觉 Transformer 学习,构建一个比 MobileViT 更好更快的卷积网络
前言 本文主要探究了轻量模型的设计.通过使用 Vision Transformer 的优势来改进卷积网络,从而获得更好的性能. 欢迎关注公众号CV技术指南,专注于计算机视觉的技术总结.最新技术跟 ...
- ICCV2021 | 重新思考视觉transformers的空间维度
论文:Rethinking Spatial Dimensions of Vision Transformers 代码:https://github.com/naver-ai/pit 获取:在CV技 ...
- ICCV2021 | Tokens-to-Token ViT:在ImageNet上从零训练Vision Transformer
前言 本文介绍一种新的tokens-to-token Vision Transformer(T2T-ViT),T2T-ViT将原始ViT的参数数量和MAC减少了一半,同时在ImageNet上从 ...
- 《Vision Permutator: A Permutable MLP-Like ArchItecture For Visual Recognition》论文笔记
论文题目:<Vision Permutator: A Permutable MLP-Like ArchItecture For Visual Recognition> 论文作者:Qibin ...
- Transformers 简介(下)
作者|huggingface 编译|VK 来源|Github Transformers是TensorFlow 2.0和PyTorch的最新自然语言处理库 Transformers(以前称为pytorc ...
- 利用 iOS 14 Vision 的手势估测功能 实作无接触即可滑动的 Tinder App
Vision 框架在 2017 年推出,目的是为了让行动 App 开发者轻松利用电脑视觉演算法.具体来说,Vision 框架中包含了许多预先训练好的深度学习模型,同时也能充当包裹器 (wrapper) ...
- CVPR2022 | A ConvNet for the 2020s & 如何设计神经网络总结
前言 本文深入探讨了如何设计神经网络.如何使得训练神经网络具有更加优异的效果,以及思考网络设计的物理意义. 欢迎关注公众号CV技术指南,专注于计算机视觉的技术总结.最新技术跟踪.经典论文解读.CV招聘 ...
- 预训练语言模型整理(ELMo/GPT/BERT...)
目录 简介 预训练任务简介 自回归语言模型 自编码语言模型 预训练模型的简介与对比 ELMo 细节 ELMo的下游使用 GPT/GPT2 GPT 细节 微调 GPT2 优缺点 BERT BERT的预训 ...
- 机器学习(ML)十一之CNN各种模型
深度卷积神经网络(AlexNet) 在LeNet提出后的将近20年里,神经网络一度被其他机器学习方法超越,如支持向量机.虽然LeNet可以在早期的小数据集上取得好的成绩,但是在更大的真实数据集上的表现 ...
随机推荐
- 【已解决】SpringBoot + Mybatis-plus 实体类属性注解 @TableField 无法获取到数据库值(属性变量名带下划线)
问题描述: 实体类变量的命名格式 如果采用的是 XX_XX带下划线的形式,那么在低版本的mybatis-plus是不支持和数据库映射的. 如果是单个单词不存在这个问题,如果出现多个单词,尽量采用驼峰式 ...
- python读取xml格式数据
读取节点文本值和,属性值 # -*- coding: UTF-8 -*- from xml.dom import minidom dom=minidom.parse('F:\\python_proje ...
- PCB Layout之EMMC_Flash走线总结@@@
PCB Layout之EMMC_Flash走线总结 1,数据线DATA[0-7]走线要(基本)等长(含芯片内部线长),线要短,线间距控制3W原则,参考面要完整(参考面下面最好不要走其它高速信号线),阻 ...
- 使用CSS 绘制各种形状
如何使用CSS 绘制各种形状? 很多小伙伴在做开发的时候,遇到一些要画很多形状的时候,就很纠结了,知道怎么用CSS去布局,就是不知道怎么画图案. 其实使用CSS可以绘制出很形状的,比如三角形,梯形 ...
- 把本地项目上传到github
一在本地项目文件内,git初始化,并add, commit cd /test/xxxdemo git init add . commit -m "inits" 二在github创建 ...
- Markdown中如何让# * >等符号原样显示,不转义解析成对应Markdown语法
加\转义: * markdown 中如果遇到有字符与原有语法冲突, 可以使用反引号"`"包裹需要转移的内容. * 反引号位于键盘左上角Esc下面的位置 示例: # * > 原 ...
- c#遍历一个对象的字段信息
c#遍历对象字段 场景:有一个对象作为导出word段落的数据.每一个字段就代表一个段落,可以对相应段落数据设置样式(字体.颜色.加粗--) 参考文献:(12条消息) C#获取实体类字段信息Proper ...
- Python学习笔记组织文件之将指定目录下的指定格式文件压缩到指定文件夹
随笔记录方便自己和同路人查阅. #------------------------------------------------我是可耻的分割线--------------------------- ...
- class声明中初始化静态成员变量的问题
1. const静态变量,允许整型或枚举类型成员直接初始化. 2. constexpr静态变量,允许literal类型成员直接初始化. 3. c++17引入inline变量,允许其他类型成员直接初始化 ...
- nginx配置透明代理
来自:https://blog.csdn.net/weixin_34072458/article/details/91677177 user nginx; worker_processes auto; ...