
Python词频分析
Python词频分析
一、前言
在日常工作或者生活中,有时候会遇到词频分析的场景。如果是要进行词频分析,那么首先需要对句子进行分词,将句子中的单词进行切割并按照词性进行归类。
在Python中有个第三方库叫jieba(结巴),可以对文章或者语句进行分词。不得不佩服这个库的作者,真是个取名鬼才:)
二、分词
2.1 安装库
jieba库github地址
jieba库官方给出了3中安装库的方式,分别如下:
全自动安装:
easy_install jieba 或者 pip install jieba / pip3 install jieba
半自动安装:
先下载 http://pypi.python.org/pypi/jieba/ ,解压后运行 python setup.py install
手动安装:
将 jieba 目录放置于当前目录或者 site-packages 目录
2.2 方法介绍
2.2.1 jieba.cut
方法接受四个输入参数:
1、需要分词的字符串;
2、cut_all 参数用来控制是否采用全模式;
3、HMM 参数用来控制是否使用 HMM 模型;
4、use_paddle 参数用来控制是否使用paddle模式下的分词模式,paddle模式采用延迟加载方式,通过enable_paddle接口安装paddlepaddle-tiny,并且import相关代码;
注意:
1、实测paddle模式无法开启(jieba.enable_paddle()),会报错。
2、该方法返回的是generator,如果需要返回list,则可以通过list转换结果或者使用jieba.lcut方法
3、待分词的字符串可以是 unicode 或 UTF-8 字符串、GBK 字符串。不建议直接输入 GBK 字符串,可能无法预料地错误解码成 UTF-8。
2.2.1 jieba.cut_for_search
方法接受两个参数:
1、需要分词的字符串;
2、是否使用 HMM 模型。
注意:
1、该方法适合用于搜索引擎构建倒排索引的分词,粒度比较细。
2、该方法返回的是generator,如果需要返回list,则可以通过list转换结果或者使用jieba.lcut_for_search方法。
2.2.2 jieba.Tokenizer(dictionary=DEFAULT_DICT)
该方法用于新建自定义分词器,可用于同时使用不同词典。jieba.dt 为默认分词器,所有全局分词相关函数都是该分词器的映射。
2.3 代码示例
2.3.1 分词
# encoding=utf-8

import jieba

strs = ["我来到北京清华大学", "乒乓球拍卖完了", "中国科学技术大学"]

for s in strs:

    seg_list = jieba.cut(s, use_paddle=False)  # 使用paddle模式

    print("Paddle Mode: " + '/'.join(list(seg_list)))

seg_list = jieba.cut("我来到北京清华大学", cut_all=True)

print("Full Mode: " + "/ ".join(seg_list))  # 全模式

seg_list = jieba.cut("我来到北京清华大学", cut_all=False)

print("Default Mode: " + "/ ".join(seg_list))  # 精确模式

seg_list = jieba.cut("他来到了网易杭研大厦")  # 默认是精确模式

print(", ".join(seg_list))

seg_list = jieba.cut_for_search("小明硕士毕业于中国科学院计算所,后在日本京都大学深造")  # 搜索引擎模式

print(", ".join(seg_list))
运行结果:
Building prefix dict from the default dictionary ...
Loading model from cache C:\Users\FURONG~1\AppData\Local\Temp\jieba.cache
Loading model cost 0.705 seconds.
Prefix dict has been built successfully.
Paddle Mode: 我/来到/北京/清华大学
Paddle Mode: 乒乓球/拍卖/完/了
Paddle Mode: 中国/科学技术/大学
Full Mode: 我/ 来到/ 北京/ 清华/ 清华大学/ 华大/ 大学
Default Mode: 我/ 来到/ 北京/ 清华大学
他, 来到, 了, 网易, 杭研, 大厦
小明, 硕士, 毕业, 于, 中国, 科学, 学院, 科学院, 中国科学院, 计算, 计算所, ,, 后, 在, 日本, 京都, 大学, 日本京都大学, 深造
2.3.2 载入词典
开发者可以指定自己自定义的词典,以便包含 jieba 词库里没有的词。虽然 jieba 有新词识别能力,但是自行添加新词可以保证更高的正确率。
用法:jieba.load_userdict(file_name) # file_name 为文件类对象或自定义词典的路径。
词典格式和 dict.txt 一样(dict.txt为安装jieba库时自带的词典,路径为:Python安装路径\Lib\site-packages\jieba\dict.txt),一个词占一行;每一行分三部分:
- 词语
- 词频(可省略)
- 词性(可省略)
用空格隔开,顺序不可颠倒。file_name 若为路径或二进制方式打开的文件,则文件必须为 UTF-8 编码。
词频省略时使用自动计算的能保证分出该词的词频。
例如:
创新办 3 i
云计算 5
凱特琳 nz
台中
更改分词器(默认为 jieba.dt)的 tmp_dir 和 cache_file 属性,可分别指定缓存文件所在的文件夹及其文件名,用于受限的文件系统。
范例:
自定义词典:https://github.com/fxsjy/jieba/blob/master/test/userdict.txt
用法示例:https://github.com/fxsjy/jieba/blob/master/test/test_userdict.py
加载自定义词库前: 李小福 / 是 / 创新 / 办 / 主任 / 也 / 是 / 云 / 计算 / 方面 / 的 / 专家 /
加载自定义词库后: 李小福 / 是 / 创新办 / 主任 / 也 / 是 / 云计算 / 方面 / 的 / 专家 /
调整词典
使用 add_word(word, freq=None, tag=None) 和 del_word(word) 可在程序中动态修改词典。
使用 suggest_freq(segment, tune=True) 可调节单个词语的词频,使其能(或不能)被分出来。
注意:自动计算的词频在使用 HMM 新词发现功能时可能无效。
print('/'.join(jieba.cut('如果放到post中将出错。', HMM=False)))
如果/放到/post/中将/出错/。
jieba.suggest_freq(('中', '将'), True)
494
print('/'.join(jieba.cut('如果放到post中将出错。', HMM=False)))
如果/放到/post/中/将/出错/。
print('/'.join(jieba.cut('「台中」正确应该不会被切开', HMM=False)))
「/台/中/」/正确/应该/不会/被/切开
jieba.suggest_freq('台中', True)
69
print('/'.join(jieba.cut('「台中」正确应该不会被切开', HMM=False)))
「/台中/」/正确/应该/不会/被/切开
2.3.3 词性标注
jieba.posseg.POSTokenizer(tokenizer=None) 新建自定义分词器,tokenizer 参数可指定内部使用的 jieba.Tokenizer 分词器。jieba.posseg.dt 为默认词性标注分词器。
标注句子分词后每个词的词性,采用和 ictclas 兼容的标记法。
import jieba.posseg as pseg

words = pseg.cut("我爱北京天安门")

for word, flag in words:

    print('%s %s' % (word, flag))
我 r
爱 v
北京 ns
天安门 ns
词性和专名类别标签集合如下表,其中词性标签 24 个(小写字母),专名类别标签 4 个(大写字母):
三、实例
3.1 分词
这里就拿笔者最近看的一本小说判官.txt来进行实例词频分析吧。目的是想要分析这本小说的人物、名词、地名,从而对这本小说有个大概的认识。
分词代码如下:
    def m_get_content(self):

        """

        获取给定txt或str中的内容

        @return: {str:获取到的内容}

        """

        if self.f_input.endswith('.txt'):

            with open(self.f_input, 'r', encoding='utf-8') as f:

                content = f.read()

        else:

            content = self.f_input

        return content

    def m_get_target_words_from_content(self, p_content):

        """

        从目标内容中获取到指定词性的词语

        @param p_content: 需要分词的内容

        @return: {list:分词后的词语}

        """

        return [

            _.word

            for _ in psg.cut(p_content)

            if len(_.word) > 1 and _.flag in self.f_wordclass

        ]
3.2 按照词频排序
def words_frequency(p_list, p_reverse=True):

    """

    返回给定的list中的所有元素按照频率和指定的顺序组成的list

    @param p_list: 给定的list

    @param p_reverse: 指定的排序顺序(倒序为True,正序为False)

    @return: {list[tuple]:经过排序后的内容}

    """

    result = {}

    for word in p_list:

        result.setdefault(word, 0)

        result[word] += 1

    return sorted(result.items(), key=lambda x: x[1], reverse=p_reverse)

    def m_words_sort(self, p_words: list):

        """

        对获取到的分词的内容进行按照频率排序

        @param p_words: 需要进行按频率排序的内容

        @return: {list[tuple]:经过排序后的内容}

        """

        return words_frequency(p_list=p_words, p_reverse=self.f_reverse)
3.3 获取排序后的前N项内容制作柱图
    def m_show_words_frequency(self, p_words_sort: list):

        """

        将p_words_sort中的内容提取前p_ranknum项使用"-"符号展示柱图。

        @param p_words_sort: 要用来展示柱图的dict内容

        @return: {str:柱图}

        """

        max_frequency = max(p_words_sort[0][1], p_words_sort[-1][1])

        ratio = max_frequency / self.f_shownum

        print('%-5s\t%-5s\t%-5s\t%-15s' % ('序号', '词性', '词频', '柱图'))

        for i in range(self.f_ranknum):

            print(f'{i + 1:<5}\t{p_words_sort[i][0]:<5}\t{p_words_sort[i][1]:<5}\t{"-" * int(p_words_sort[i][1] / ratio):<15}')
3.4 获取排序后的前N项内容制作词云图
用Python制作词云图需要安装wordcloud第三方库。参照如下:
python词云制作(最全最详细的教程)
from wordcloud import WordCloud

        words_cloud = ' '.join([_[0] for _ in words_sort[:10]])

        wordcloud = WordCloud(font_path="msyh.ttc").generate(words_cloud)

        wordcloud.to_file(self.f_wordcloud_fn)
3.5 结果
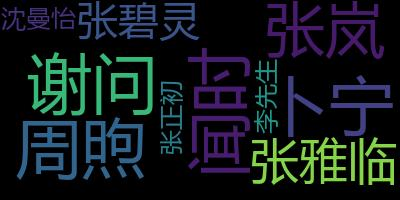
人名部分
序号 词性 词频 柱图
1 闻时 1405 ------------------------------
2 谢问 1092 -----------------------
3 周煦 762 ----------------
4 卜宁 513 ----------
5 张岚 466 ---------
6 张雅临 332 -------
7 张碧灵 219 ----
8 沈曼怡 216 ----
9 张正初 185 ---
10 李先生 164 ---
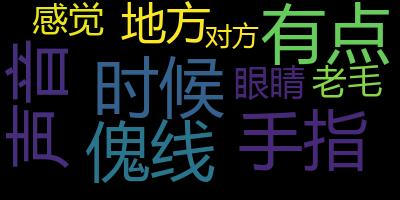
名词部分
序号 词性 词频 柱图
1 时候 777 ------------------------------
2 有点 449 -----------------
3 傀线 376 --------------
4 手指 345 -------------
5 声音 324 ------------
6 地方 316 ------------
7 感觉 293 -----------
8 眼睛 255 ---------
9 老毛 209 --------
10 对方 208 --------
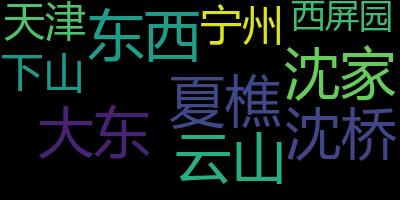
地名部分
序号 词性 词频 柱图
1 夏樵 803 ------------------------------
2 东西 550 --------------------
3 大东 231 --------
4 沈家 184 ------
5 云山 140 -----
6 沈桥 80 --
7 宁州 51 -
8 下山 45 -
9 天津 35 -
10 西屏园 32 -
3.6 完整代码
import jieba.posseg as psg

def words_frequency(p_list, p_reverse=True):

    """

    返回给定的list中的所有元素按照频率和指定的顺序组成的list

    @param p_list: 给定的list

    @param p_reverse: 指定的排序顺序(倒序为True,正序为False)

    @return: {list[tuple]:经过排序后的内容}

    """

    result = {}

    for word in p_list:

        result.setdefault(word, 0)

        result[word] += 1

    return sorted(result.items(), key=lambda x: x[1], reverse=p_reverse)

class WordsFrequency:

    def __init__(self, p_input: str, p_wordclass: list[str], p_ranknum=10, p_reverse=True, p_shownum=30, p_wordcloud_fn='人名.jpg'):

        """

        @param p_input: 要分析的文件名或字符串,文件必须为txt格式,编码为utf-8.

        @param p_wordclass: 要获取的词性。常见的类型有:普通名词n、人名nr、地名ns

        @param p_ranknum: 要获取前多少个目标词性的词语。

        @param p_reverse: 目标词语通过频率指定的排序方向。(倒序为True,正序为False)

        @param p_shownum: 频率最多的元素使用的柱图标识"-"的个数。

        @param p_wordcloud_fn: 生成词云图的图片文件名

        """

        self.f_input = p_input

        self.f_wordclass = p_wordclass

        self.f_ranknum = p_ranknum

        self.f_reverse = p_reverse

        self.f_shownum = p_shownum

        self.f_wordcloud_fn = p_wordcloud_fn

    def m_get_content(self):

        """

        获取给定txt或str中的内容

        @return: {str:获取到的内容}

        """

        if self.f_input.endswith('.txt'):

            with open(self.f_input, 'r', encoding='utf-8') as f:

                content = f.read()

        else:

            content = self.f_input

        return content

    def m_get_target_words_from_content(self, p_content):

        """

        从目标内容中获取到指定词性的词语

        @param p_content: 需要分词的内容

        @return: {list:分词后的词语}

        """

        return [

            _.word

            for _ in psg.cut(p_content)

            if len(_.word) > 1 and _.flag in self.f_wordclass

        ]

    def m_words_sort(self, p_words: list):

        """

        对获取到的分词的内容进行按照频率排序

        @param p_words: 需要进行按频率排序的内容

        @return: {list[tuple]:经过排序后的内容}

        """

        return words_frequency(p_list=p_words, p_reverse=self.f_reverse)

    def m_show_words_frequency(self, p_words_sort: list):

        """

        将p_words_sort中的内容提取前p_ranknum项使用"-"符号展示柱图。

        @param p_words_sort: 要用来展示柱图的dict内容

        @return: {str:柱图}

        """

        max_frequency = max(p_words_sort[0][1], p_words_sort[-1][1])

        ratio = max_frequency / self.f_shownum

        print('%-5s\t%-5s\t%-5s\t%-15s' % ('序号', '词性', '词频', '柱图'))

        for i in range(self.f_ranknum):

            print(f'{i + 1:<5}\t{p_words_sort[i][0]:<5}\t{p_words_sort[i][1]:<5}\t{"-" * int(p_words_sort[i][1] / ratio):<15}')

    def main(self):

        content = self.m_get_content()

        words = self.m_get_target_words_from_content(content)

        words_sort = self.m_words_sort(words)

        # 柱图部分

        self.m_show_words_frequency(words_sort)

        # 生成词云图

        from wordcloud import WordCloud

        words_cloud = ' '.join([_[0] for _ in words_sort[:10]])

        wordcloud = WordCloud(font_path="msyh.ttc").generate(words_cloud)

        wordcloud.to_file(self.f_wordcloud_fn)

if __name__ == '__main__':

    wf = WordsFrequency(p_input='判官.txt', p_wordclass=['ns'], p_wordcloud_fn='地名.jpg')

    wf.main()
Python词频分析的更多相关文章
- json与api- 天气api 博客词频分析
一.json基础 1.1 json的介绍 json现在成为各种程序与语言之间交互的一种数据格式,本质是文本,字符串. json有两种格式: 1. 类似字典 {k:v,k,v} 2. 类似列表 { ...
- Python股票分析系列——自动获取标普500股票列表.p5
该系列视频已经搬运至bilibili: 点击查看 欢迎来到Python for Finance教程系列的第5部分.在本教程和接下来的几节中,我们将着手研究如何为更多公司提供大量的定价信息,以及如何一次 ...
- Python股票分析系列——基础股票数据操作(二).p4
该系列视频已经搬运至bilibili: 点击查看 欢迎来到Python for Finance教程系列的第4部分.在本教程中,我们将基于Adj Close列创建烛台/ OHLC图,这将允许我介绍重新采 ...
- Python股票分析系列——基础股票数据操作(一).p3
该系列视频已经搬运至bilibili: 点击查看 欢迎来到Python for Finance教程系列的第3部分.在本教程中,我们将使用我们的股票数据进一步分解一些基本的数据操作和可视化.我们将要使用 ...
- Python股票分析系列——数据整理和绘制.p2
该系列视频已经搬运至bilibili: 点击查看 欢迎来到Python for Finance教程系列的第2部分. 在本教程中,我们将利用我们的股票数据进一步分解一些基本的数据操作和可视化. 我们将要 ...
- Python股票分析系列——系列介绍和获取股票数据.p1
本系列转载自youtuber sentdex博主的教程视频内容 https://www.youtube.com/watch?v=19yyasfGLhk&index=4&list=PLQ ...
- Python数据采集分析告诉你为何上海二手房你都买不起
感谢关注Python爱好者社区公众号,在这里,我们会每天向您推送Python相关的文章实战干货. 来吧,一起Python. 对商业智能BI.大数据分析挖掘.机器学习,python,R等数据领域感兴趣的 ...
- 【转】python模块分析之collections(六)
[转]python模块分析之collections(六) collections是Python内建的一个集合模块,提供了许多有用的集合类. 系列文章 python模块分析之random(一) pyth ...
- 【转】python模块分析之unittest测试(五)
[转]python模块分析之unittest测试(五) 系列文章 python模块分析之random(一) python模块分析之hashlib加密(二) python模块分析之typing(三) p ...
随机推荐
- 一文彻底搞懂MySQL分区
一个执着于技术的公众号 一.InnoDB逻辑存储结构 首先要先介绍一下InnoDB逻辑存储结构和区的概念,它的所有数据都被逻辑地存放在表空间,表空间又由段,区,页组成. 段 段就是上图的segment ...
- form表单,css简介,css选择器,css样式操作
form表单 简介 表单在Web网页中用以让访问者输入数据,当提交表单时,表单中输入的数据被打包传递给Web服务器端的程序 以处理,从而使得Web服务器与用户之间具有交互功能. 表单实现前后台交互:用 ...
- vmware 虚拟机系统双屏或更多屏
确保 VMware Workstation 软件已打开,且目标虚拟机已关机 编辑 > 首选项 > 显示 > 自动适应,确保 自动适应窗口.自动适应客户机 已勾选,点击 确定 保存 右 ...
- postman 脚本和变量
背景 后端接口有登录或鉴权验证,通过 swagger 调用比较费劲,并且 java 的 swagger 库(不够自动化,嵌套类支持需要各种配置才能正常显示 schema)个人感觉也没有 .net co ...
- Spring Security之短信登录
实现短信验证码登录 前面实现了 用户名+密码 的登录方式,现在实现一下短信验证码登录. 开发短信验证码接口 短信验证码和图形验证码类似,用户从手机短信得到验证码和从图片得到验证码类似. 校验短信验证码 ...
- 一文详解 WebSocket 网络协议
WebSocket 协议运行在TCP协议之上,与Http协议同属于应用层网络数据传输协议.WebSocket相比于Http协议最大的特点是:允许服务端主动向客户端推送数据(从而解决Http 1.1协议 ...
- 安装PostgreSQL到CentOS(YUM)
运行环境 系统版本:CentOS Linux release 7.6.1810 (Core) 软件版本:postgresql-12 硬件要求:无 安装过程 1.安装YUM-PostgreSQL存储库 ...
- MySql笔记Ⅰ
MySql part 1: 数据库概念 数据库:(DataBase, 简称DB):数据库中的数据按一定的数据模型组织.描述和储存,具有较小的冗余度.较高的数据独立性和易扩展性,并可为各种 用户共享 数 ...
- Spring Ioc源码分析系列--Bean实例化过程(二)
Spring Ioc源码分析系列--Bean实例化过程(二) 前言 上篇文章Spring Ioc源码分析系列--Bean实例化过程(一)简单分析了getBean()方法,还记得分析了什么吗?不记得了才 ...
- 【clickhouse专栏】数据库、数据仓库之间的区别与联系
从本篇文章开始,笔者打算写一个系列的<clickhouse专栏>,其全称是Click Stream,Data WareHouse,简称ClickHouse.从其全称中的"Data ...