
spark学习之Lambda架构日志分析流水线
单机运行
一、环境准备
Flume 1.6.0
Hadoop 2.6.0
Spark 1.6.0
Java version 1.8.0_73
Kafka 2.11-0.9.0.1
zookeeper 3.4.6
二、配置
spark和hadoop配置见()
kafka和zookeeper使用默认配置
1、kafka配置
启动
bin/kafka-server-start.sh config/server.properties
创建一个test的topic
bin/kafka-topics.sh --create --zookeeper vm: --replication-factor --partitions --topic test
2、flume配置文件,新建一个dh.conf文件,配置如下
其中发送的内容为apache-tomcat-8.0.32的访问日志
#define c1

agent1.channels.c1.type = memory

agent1.channels.c1.capacity =

agent1.channels.c1.transactionCapacity =

#define c1 end

#define c2

agent1.channels.c2.type = memory

agent1.channels.c2.capacity =

agent1.channels.c2.transactionCapacity =

#define c2 end

#define source monitor a file

agent1.sources.avro-s.type = exec

agent1.sources.avro-s.command = tail -f -n+ /usr/local/hong/apache-tomcat-8.0./logs/localhost_access_log.--.txt

agent1.sources.avro-s.channels = c1 c2

agent1.sources.avro-s.threads =

# send to hadoop

agent1.sinks.log-hdfs.channel = c1

agent1.sinks.log-hdfs.type = hdfs

agent1.sinks.log-hdfs.hdfs.path = hdfs://vm:9000/flume

agent1.sinks.log-hdfs.hdfs.writeFormat = Text

agent1.sinks.log-hdfs.hdfs.fileType = DataStream

agent1.sinks.log-hdfs.hdfs.rollInterval =

agent1.sinks.log-hdfs.hdfs.rollSize =

agent1.sinks.log-hdfs.hdfs.rollCount =

agent1.sinks.log-hdfs.hdfs.batchSize =

agent1.sinks.log-hdfs.hdfs.txnEventMax =

agent1.sinks.log-hdfs.hdfs.callTimeout =

agent1.sinks.log-hdfs.hdfs.appendTimeout =

#send to kafaka

agent1.sinks.log-sink2.type = org.apache.flume.sink.kafka.KafkaSink

agent1.sinks.log-sink2.topic = test

agent1.sinks.log-sink2.brokerList = vm:

agent1.sinks.log-sink2.requiredAcks =

agent1.sinks.log-sink2.batchSize =

agent1.sinks.log-sink2.channel = c2

# Finally, now that we've defined all of our components, tell

# agent1 which ones we want to activate.

agent1.channels = c1 c2

agent1.sources = avro-s

agent1.sinks = log-hdfs log-sink2
三、测试flume发送
1、启动hdfs
./start-dfs.sh
2、启动zookeeper
./zkServer.sh start
3、kafka的见上面
4、启动flume
flume-ng agent -c conf -f dh.conf -n agent1 -Dflume.root.logger=INFO,console
四、测试效果
运行kafka的consumer查看
bin/kafka-console-consumer.sh --zookeeper localhost: --topic test --from-beginning
可以看到如下内容说明kafka和flume的配置成功
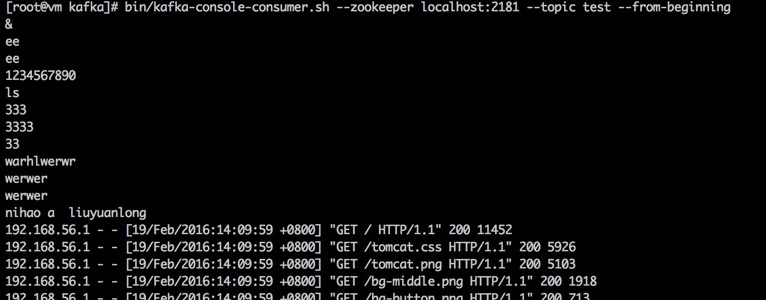
访问hdfs查看如果/flume可以下载文件进行查看验证hdfs发送是否成功
spark学习之Lambda架构日志分析流水线的更多相关文章
- spark SQL学习(综合案例-日志分析)
日志分析 scala> import org.apache.spark.sql.types._ scala> import org.apache.spark.sql.Row scala&g ...
- Hadoop学习笔记—20.网站日志分析项目案例(一)项目介绍
网站日志分析项目案例(一)项目介绍:当前页面 网站日志分析项目案例(二)数据清洗:http://www.cnblogs.com/edisonchou/p/4458219.html 网站日志分析项目案例 ...
- Hadoop学习笔记—20.网站日志分析项目案例(三)统计分析
网站日志分析项目案例(一)项目介绍:http://www.cnblogs.com/edisonchou/p/4449082.html 网站日志分析项目案例(二)数据清洗:http://www.cnbl ...
- Hadoop学习笔记—20.网站日志分析项目案例
1.1 项目来源 本次要实践的数据日志来源于国内某技术学习论坛,该论坛由某培训机构主办,汇聚了众多技术学习者,每天都有人发帖.回帖,如图1所示. 图1 项目来源网站-技术学习论坛 本次实践的目的就在于 ...
- Hadoop学习笔记—20.网站日志分析项目案例(二)数据清洗
网站日志分析项目案例(一)项目介绍:http://www.cnblogs.com/edisonchou/p/4449082.html 网站日志分析项目案例(二)数据清洗:当前页面 网站日志分析项目案例 ...
- 【Spark】通过Spark实现点击流日志分析
文章目录 数据大致内容及格式 统计PV(PageViews) 统计UV(Unique Visitor) 求取TopN 数据大致内容及格式 194.237.142.21 - - [18/Sep/2013 ...
- Spark学习之Spark调优与调试(7)
Spark学习之Spark调优与调试(7) 1. 对Spark进行调优与调试通常需要修改Spark应用运行时配置的选项. 当创建一个SparkContext时就会创建一个SparkConf实例. 2. ...
- 架构之ELK日志分析系统
ELK多种架构及优劣 既然要谈ELK在大数据运维系统中的应用,那么ELK架构就不得不谈.本章节引出四种笔者曾经用过的ELK架构,并讨论各种架构所适合的场景和优劣供大家参考. 先大致介绍ELK组件.EL ...
- 苏宁基于Spark Streaming的实时日志分析系统实践 Spark Streaming 在数据平台日志解析功能的应用
https://mp.weixin.qq.com/s/KPTM02-ICt72_7ZdRZIHBA 苏宁基于Spark Streaming的实时日志分析系统实践 原创: AI+落地实践 AI前线 20 ...
随机推荐
- Mysql索引查询失效的情况
首先,复习一下索引的创建: 普通的索引的创建: CREATE INDEX (自定义)索引名 ON 数据表(字段); 复合索引的创建: CREATE INDEX (自定义)索引名 ON 数据 ...
- Leetcode题目102.二叉树的层次遍历(队列-中等)
题目描述: 给定一个二叉树,返回其按层次遍历的节点值. (即逐层地,从左到右访问所有节点). 例如: 给定二叉树: [3,9,20,null,null,15,7], 3 / \ 9 20 / \ 15 ...
- 第10组Alpha冲刺(3/4)
队名:凹凸曼 组长博客 作业博客 组员实践情况 童景霖 过去两天完成了哪些任务 文字/口头描述 继续学习Android studio和Java 制作登录注册界面前端 展示GitHub当日代码/文档签入 ...
- nginx 部署前端项目(vue)
前提:安装好nginx 打开nginx目录,一般是(/usr/local/nginx) npm run build 打好vue包 一般放到(/usr/local/nginx/html/)目录下 配置: ...
- ubuntu 14.04 升级到18.04
http://www.360doc.com/content/18/0929/09/35082563_790606785.shtml
- ThinkPHP数据查询与添加语句
在ThinkPHP框架中实现数据的查询操作 function ShowAll() { //Model:数据库中每张表对应一个模型 //类名是表名,类里面的成员变量是列名 //把一张表对应一个类,其中一 ...
- CORS和jsonp实现跨域请求
同源策略:所谓同源是指,域名,协议,端口相同,它是由Netscape提出的一个著名的安全策略,现在所有支持JavaScript 的浏览器都会使用这个策略.当浏览器同时打开两个tab页面(两个不同服务器 ...
- kafka可视化工具安装及简单使用
一.安装 双击kafkatool_64bit.exe安装kafka可视化工具,并且C:\Windows\System32\drivers\etc配置HOSTS,打开HOSTS并添加: HOSTS添加: ...
- Android MineType
概述 多用途互联网邮件扩展(MIME,Multipurpose Internet Mail Extensions)是一个互联网标准,它扩展了电子邮件标准,使其能够支持非ASCII字符.二进制格式附件等 ...
- python设计模式-命令模式
命令模式就是对命令的封装.所谓封装命令,就是将一系列操作封装到命令类中,并且命令类只需要对外公开一个执行方法execute,调用此命令的对象只需要执行命令的execute方法就可以完成所有的操作.这样 ...