
Checkpoint的运行原理和源码实现
引言
Checkpoint 到底是什么和需要用 Checkpoint 解决什么问题:
- Spark 在生产环境下经常会面临 Transformation 的 RDD 非常多(例如一个Job 中包含1万个RDD) 或者是具体的 Transformation 产生的 RDD 本身计算特别复杂和耗时(例如计算时常超过1个小时) , 可能业务比较复杂,此时我们必需考虑对计算结果的持久化。
- Spark 是擅长多步骤迭代,同时擅长基于 Job 的复用。这个时候如果可以对计算的过程进行复用,就可以极大的提升效率。因为有时候有共同的步骤,就可以免却重复计算的时间。
- 如果采用 persists 把数据在内存中的话,虽然最快速但是也是最不可靠的;如果放在磁盘上也不是完全可靠的,例如磁盘会损坏,系统管理员可能会清空磁盘。
- Checkpoint 的产生就是为了相对而言更加可靠的持久化数据,在 Checkpoint 可以指定把数据放在本地并且是多副本的方式,但是在正常生产环境下放在 HDFS 上,这就天然的借助HDFS 高可靠的特征来完成最大化的可靠的持久化数据的方式。
- Checkpoint 是为了最大程度保证绝对可靠的复用 RDD 计算数据的 Spark 的高级功能,通过 Checkpoint 我们通过把数据持久化到 HDFS 上来保证数据的最大程度的安任性
- Checkpoint 就是针对整个RDD 计算链条中特别需要数据持久化的环节(后面会反覆使用当前环节的RDD) 开始基于HDFS 等的数据持久化复用策略,通过对 RDD 启动 Checkpoint 机制来实现容错和高可用;
Checkpoint 运行原理图
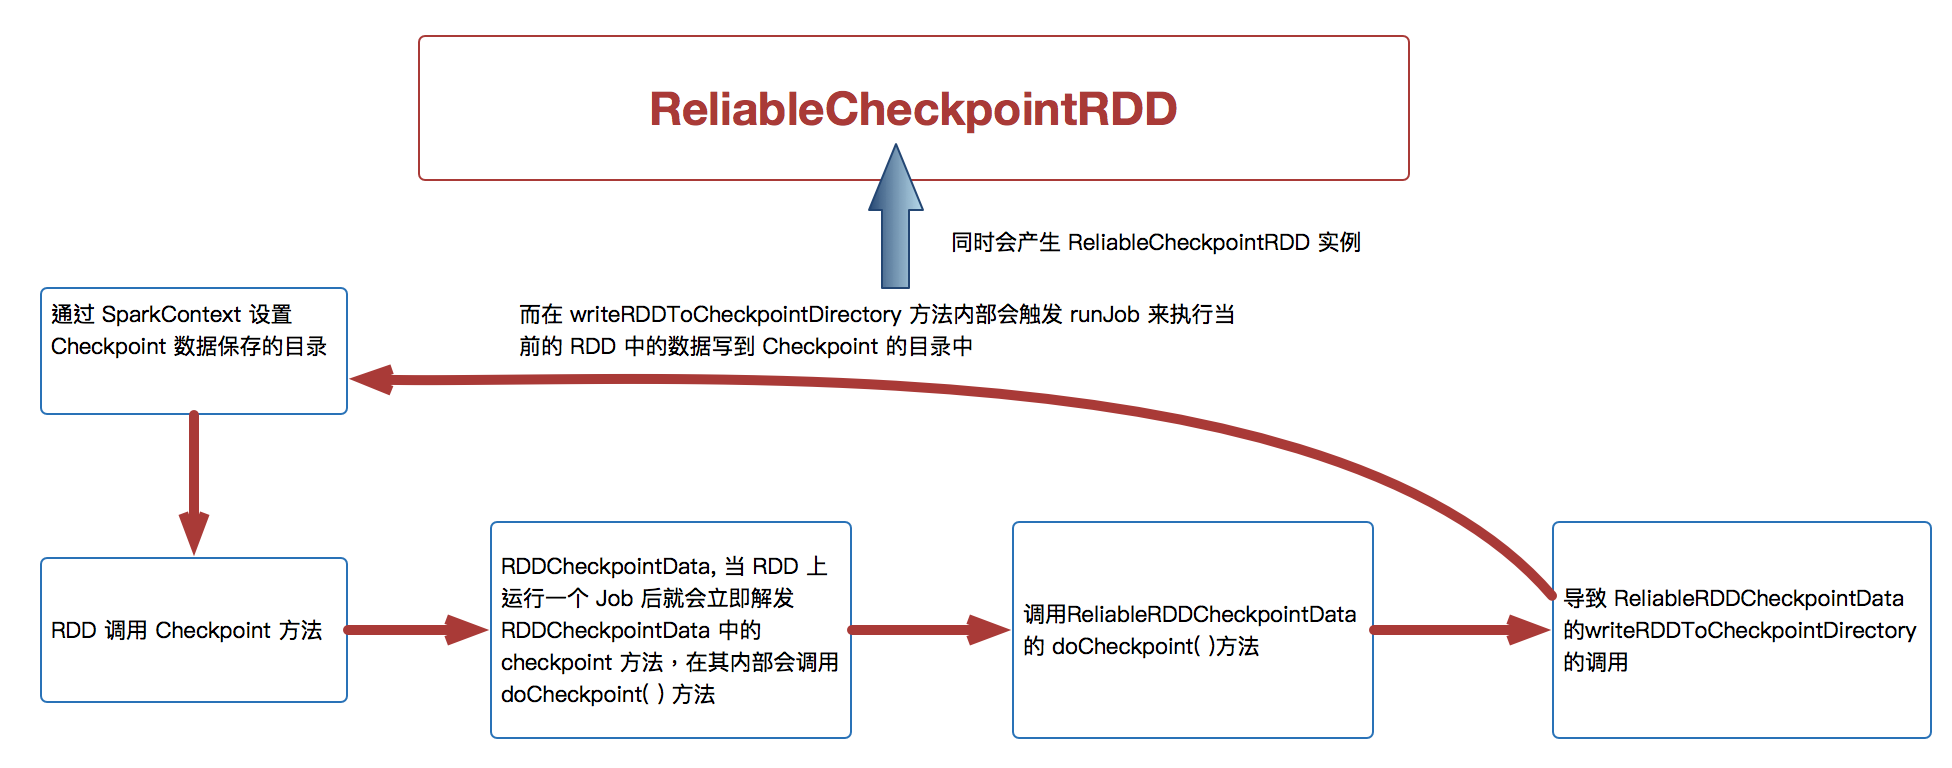
Checkpoint 源码解析
1、RDD.iterator 方法,它会先在缓存中查看数据 (内部会查看 Checkpoint 有没有相关数据),然后再从 CheckPoint 中查看数据
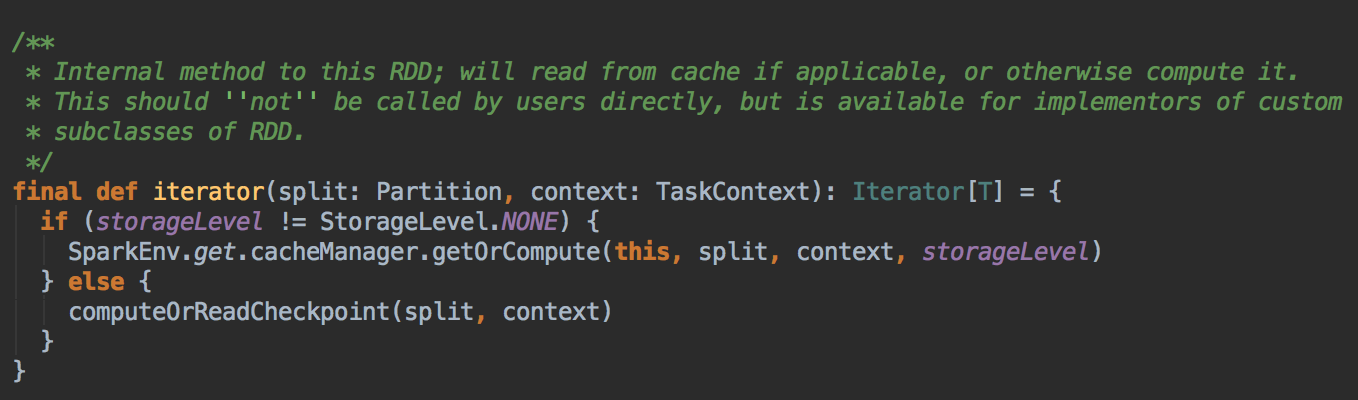
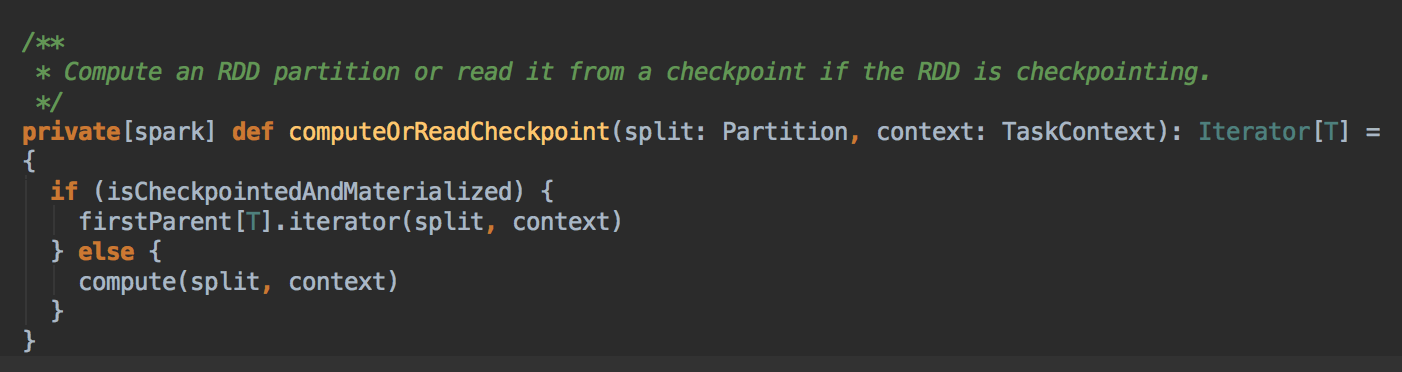
Checkpoint 有两种方法,一种是 reliably 和 一种是 locally
[下图是 RDD.scala 中的 isCheckpointed 变量和 isCheckpointedAndMaterialized 方法]
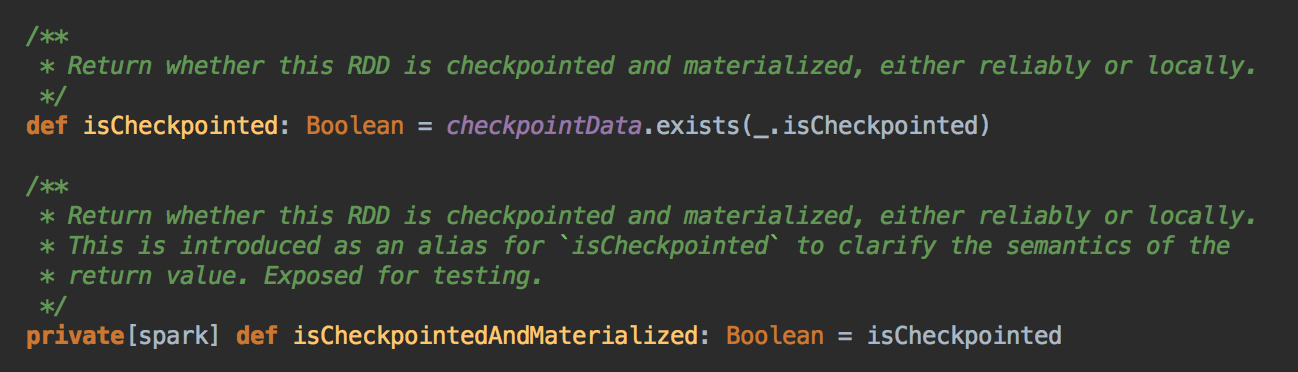
2、通过调用 SparkContext.setCheckpointDir 方法来指定进行 Checkpoint 操作的 RDD 把数据放在那里,在生产集群中是放在 HDFS 上的,同时为了提高效率在进行 Checkpoint 的时候可以指定很多目录
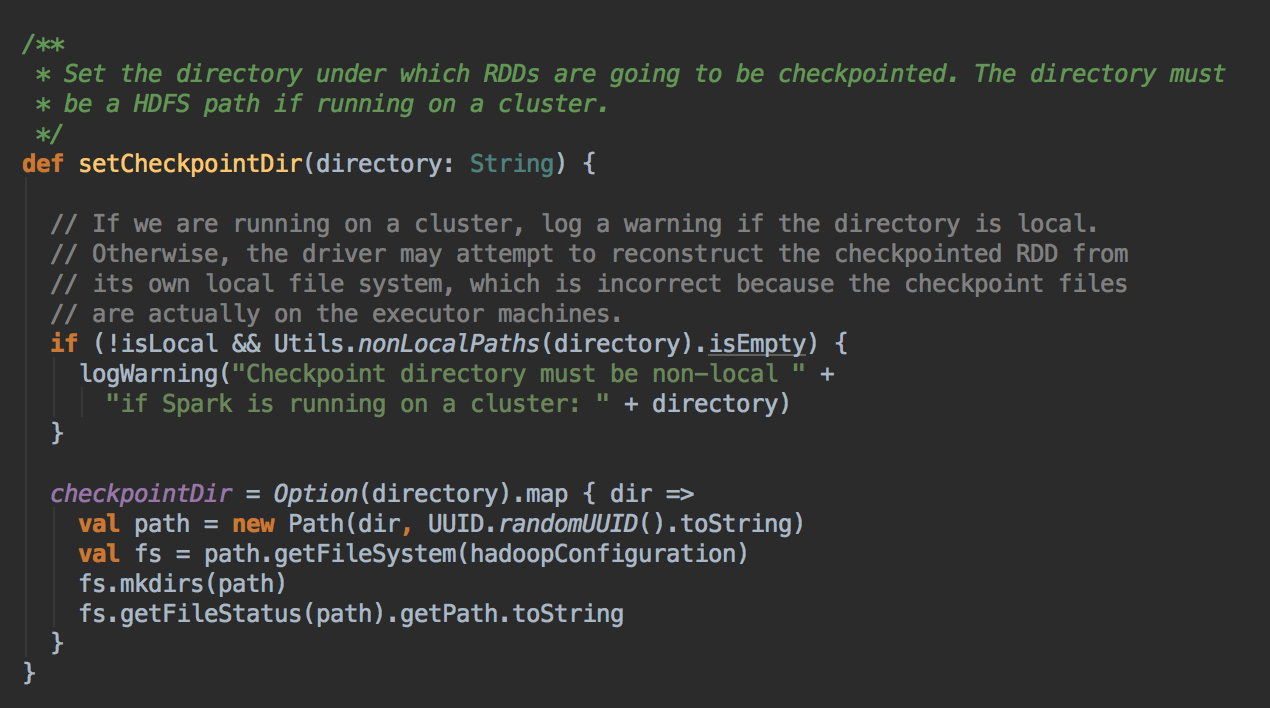
3、在进行 RDD 的 Checkpoint 的时候,其所依赖的所有 RDD 都会清空掉;官方建议如果要进行 checkpoint 时,必需先缓存在内存中。但实际可以考虑缓存在本地磁盘上或者是第三方组件,e.g. Taychon 上。在进行 checkpoint 之前需要通过 SparkConetxt 设置 checkpoint 的文件夹
[下图是 RDD.scala 中的 checkpoint 方法]

4、作为最佳实践,一般在进行 checkpoint 方法调用前都要进行 persists 来把当前 RDD 的数据持久化到内存或者是磁盘上,这是因为 checkpoint 是 lazy 级别,必需有 Job 的执行且在Job 执行完成后才会从后往前回溯哪个 RDD 进行了Checkpoint 标记,然后对该标记了要进行 Checkpoint 的 RDD 新启动一个Job 执行具体 Checkpoint 的过程;
5、Checkpoint 改变了 RDD 的 Lineage
6、当我们调用了checkpoint 方法要对RDD 进行Checkpoint 操作的话,此时框架会自动生成 RDDCheckpointData

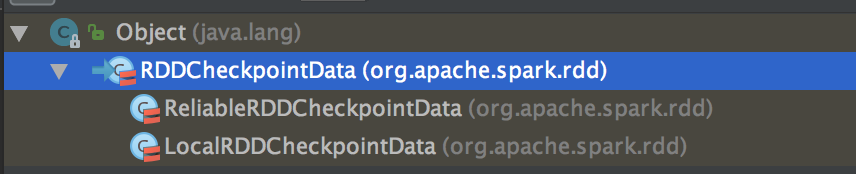
7、当 RDD 上运行一个Job 后就会立即触发 RDDCheckpointData 中的 checkpoint 方法,在其内部会调用 doCheckpoint( )方法,实际上在生产环境上会调用 ReliableRDDCheckpointData 的 doCheckpoint( )方法


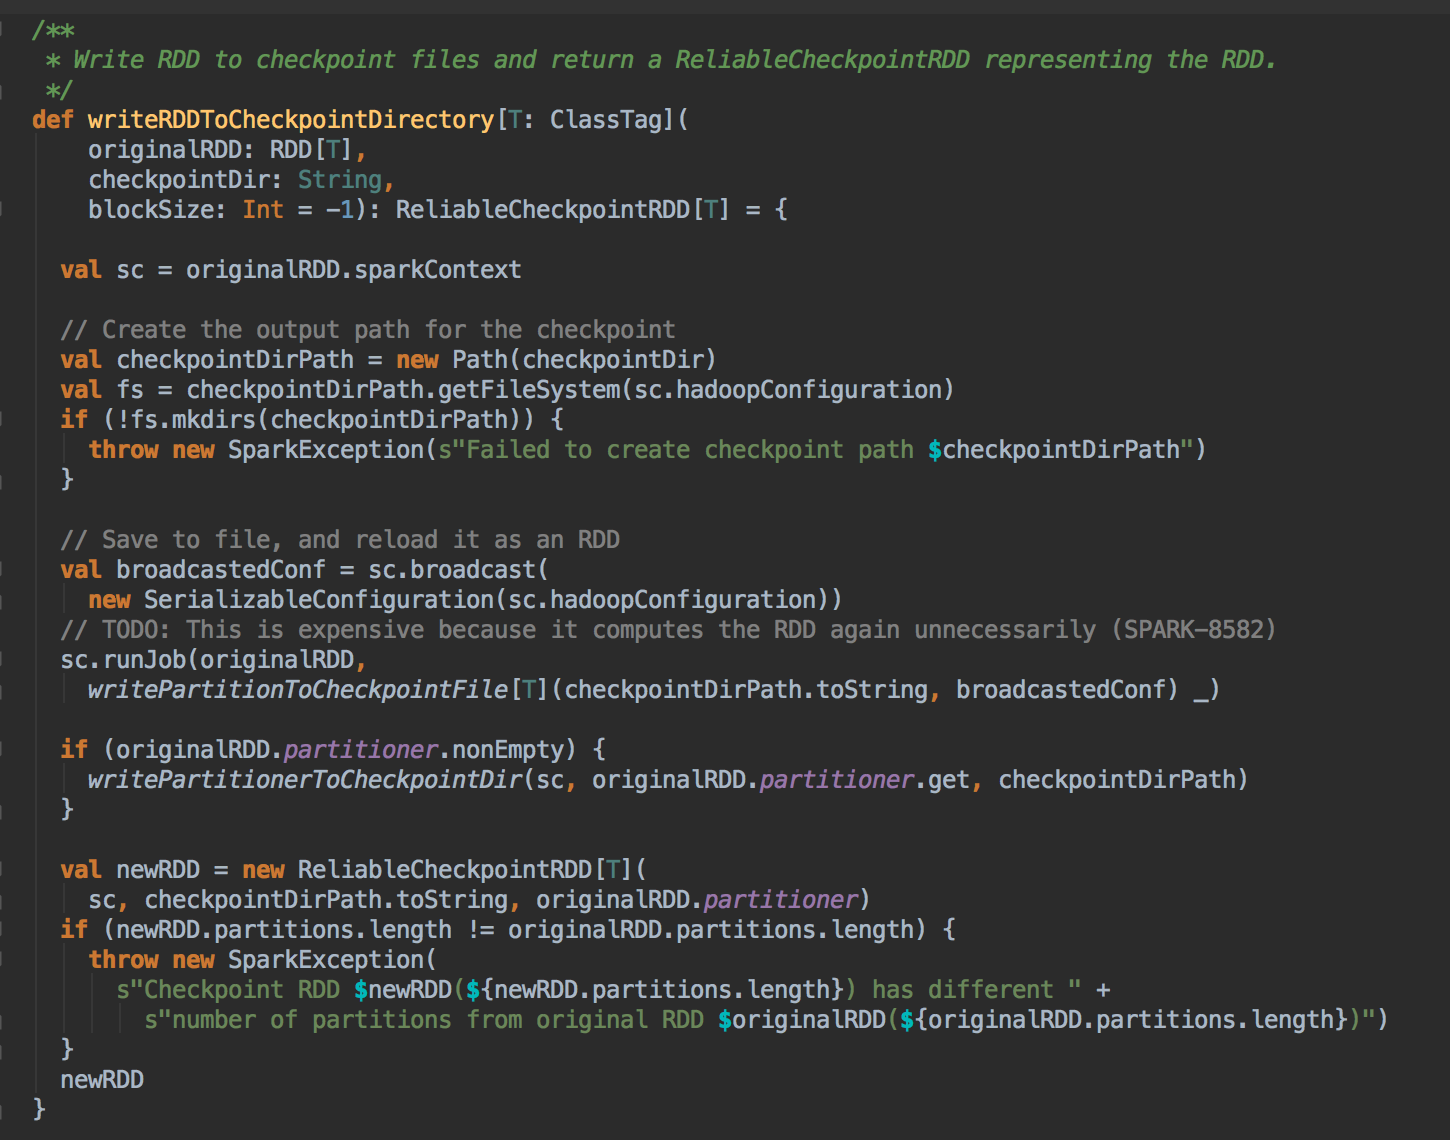
8、在生产环境下会导致 ReliableRDDCheckpointData 的 writeRDDToCheckpointDirectory 的调用,而在 writeRDDToCheckpointDirectory 方法内部会触发runJob 来执行当前的RDD 中的数据写到Checkpoint 的目录中,同时会产生ReliableCheckpointRDD 实例
Checkpoint的运行原理和源码实现的更多相关文章
- [Spark內核] 第41课:Checkpoint彻底解密:Checkpoint的运行原理和源码实现彻底详解
本课主题 Checkpoint 运行原理图 Checkpoint 源码解析 引言 Checkpoint 到底是什么和需要用 Checkpoint 解决什么问题: Spark 在生产环境下经常会面临 T ...
- [Spark内核] 第38课:BlockManager架构原理、运行流程图和源码解密
本课主题 BlockManager 运行實例 BlockManager 原理流程图 BlockManager 源码解析 引言 BlockManager 是管理整个Spark运行时的数据读写的,当然也包 ...
- [Spark内核] 第32课:Spark Worker原理和源码剖析解密:Worker工作流程图、Worker启动Driver源码解密、Worker启动Executor源码解密等
本課主題 Spark Worker 原理 Worker 启动 Driver 源码鉴赏 Worker 启动 Executor 源码鉴赏 Worker 与 Master 的交互关系 [引言部份:你希望读者 ...
- DStream-05 updateStateByKey函数的原理和源码
Demo updateState 可以到达将每次 word count 计算的结果进行累加. object SocketDstream { def main(args: Array[String]): ...
- Kubernetes Job Controller 原理和源码分析(一)
概述什么是 JobJob 入门示例Job 的 specPod Template并发问题其他属性 概述 Job 是主要的 Kubernetes 原生 Workload 资源之一,是在 Kubernete ...
- Kubernetes Job Controller 原理和源码分析(二)
概述程序入口Job controller 的创建Controller 对象NewController()podControlEventHandlerJob AddFunc DeleteFuncJob ...
- Kubernetes Job Controller 原理和源码分析(三)
概述Job controller 的启动processNextWorkItem()核心调谐逻辑入口 - syncJob()Pod 数量管理 - manageJob()小结 概述 源码版本:kubern ...
- Dubbo原理和源码解析之服务引用
一.框架设计 在官方<Dubbo 开发指南>框架设计部分,给出了引用服务时序图: 另外,在官方<Dubbo 用户指南>集群容错部分,给出了服务引用的各功能组件关系图: 本文将根 ...
- Dubbo原理和源码解析之标签解析
一.Dubbo 配置方式 Dubbo 支持多种配置方式: XML 配置:基于 Spring 的 Schema 和 XML 扩展机制实现 属性配置:加载 classpath 根目录下的 dubbo.pr ...
随机推荐
- 配置Java的jdk环境变量
1.classpath E:\Java\jdk1..0_20\jre\lib\rt.jar;.;E:\Tomcat\lib; 2.JAVA_HOME E:\Java\jdk1..0_20; 3.Pat ...
- 交换a、b的值temp = a; a = b; b = temp;比a = a^b;b = a^b;a = a^b;快
先看代码,交换a.b的值十亿次 <span style="font-size:14px;"> int a=222; int b=111; int size = 1000 ...
- python2.0 s12 day3
s12 day3 视频每节的内容 03 python s12 day3 本节内容概要 第三天的主要内容 上节没讲完的: 6.集合 7.collections 1)计数器 2)有序字典 3)默认字典 4 ...
- UITextView和UITextField的placeholder,键盘隐藏,键盘换行变完成字样
本文转载至 http://blog.csdn.net/hengshujiyi/article/details/9086093- (void)initFeedBackViews { //设置页面的背景颜 ...
- JS Date parse
因为JS中的Date转换格式没有“-”这种间隔符,Date.parse会生成NAN,所以只能进行转换. <script type="text/javascript"> ...
- c++11实现l延迟调用(惰性求值)
惰性求值 惰性求值一般用于函数式编程语言中,在使用延迟求值的时候,表达式不在它被绑定到变量之后就立即求值,而是在后面的某个时候求值. 可以利用c++11中的std::function, lam ...
- LeetCode - Nth Highest Salary
题目大概意思是要求找出第n高的Salary,直接写一个Function.作为一个SQL新手我学到了1.SQL中Function的写法和变量的定义,取值.2.limit查询分 页的方法. 在这个题 ...
- 数据一致性和io类型
版权声明:本文由高剑林原创文章,转载请注明出处: 文章原文链接:https://www.qcloud.com/community/article/106 来源:腾云阁 https://www.qclo ...
- PHP内存缓存功能memcached
PHP内存缓存功能memcached: http://blog.csdn.net/fangaoxin/article/details/6223383
- centos7上安装iptables
centos7上安装iptables的步骤 注意:CentOS7默认的防火墙不是iptables,而是firewalle. 安装iptable iptable-service #安装iptables ...