
在Ubuntu X64上编译Hadoop
在之前的文章中介绍了如何直接在Ubuntu中安装Hadoop。但是对于64位的Ubuntu来说,官方给出的Hadoop包是32位的,运行时会得到警告:
WARN util.NativeCodeLoader: Unable to load native-hadoop library for your platform... using builtin-java classes where applicable
所以我们最好是自己在Ubuntu中编译Hadoop。先介绍一下我的环境是Ubuntu 16.1 X64 Server版,当前最新的Hadoop是2.7.3。我们可以先下载源代码,在其中有BUILDING.txt,指导我们如何在Ubuntu中编译Hadoop:
Installing required packages for clean install of Ubuntu 14.04 LTS Desktop:
* Oracle JDK 1.7 (preferred)
$ sudo apt-get purge openjdk*
$ sudo apt-get install software-properties-common
$ sudo add-apt-repository ppa:webupd8team/java
$ sudo apt-get update
$ sudo apt-get install oracle-java7-installer
* Maven
$ sudo apt-get -y install maven
* Native libraries
$ sudo apt-get -y install build-essential autoconf automake libtool cmake zlib1g-dev pkg-config libssl-dev
* ProtocolBuffer 2.5.0 (required)
$ sudo apt-get -y install libprotobuf-dev protobuf-compiler
Optional packages:
* Snappy compression
$ sudo apt-get install snappy libsnappy-dev
* Bzip2
$ sudo apt-get install bzip2 libbz2-dev
* Jansson (C Library for JSON)
$ sudo apt-get install libjansson-dev
* Linux FUSE
$ sudo apt-get install fuse libfuse-dev
我用的Linux16.1 X64 Server版本,也是大同小异,接下来是编译Hadoop的过程:
1.更新apt源
首先需要更新我们的apt源,因为如果是国外源的话,接下来安装会很慢。使用命令
sudo vi /etc/apt/sources.list
打开这个apt源列表,如果其中看到是http://us.xxxxxx之类的,那么就是外国的,如果看到是http://cn.xxxxx之类的,那么就不用换的。我的是美国的源,所以需要做一下批量的替换。在命令模式下,输入:
:%s/us./cn./g
就可以把所有的us.改为cn.了。然后输入:wq即可保存退出。
sudo apt-get update
更新一下源。
2.安装必备软件
2.1安装SSH
sudo apt-get install ssh
安装完毕后我们就可以用putty或者SecureCRT连接到Ubuntu了。
2.2安装JDK
sudo apt-get install default-jdk
安装后可以运行java –version看安装的版本
2.3安装Maven
sudo apt-get install maven
这是编译Hadoop的工具,安装完成后,可以运行mvn -–version看安装的版本
2.4安装依赖库
sudo apt-get install g++ autoconf automake libtool cmake zlib1g-dev pkg-config libssl-dev
2.5安装ProtocolBuffer 2.5.0
注意,我要编译的是Hadoop2.7.3,必须安装的ProtocolBuffer是2.5这个版本,如果不是的话,接下来会编译失败:
protoc version is 'libprotoc 3.0.0, expected version is '2.5.0'如果我们运行文档中的:
sudo apt-get -y install libprotobuf-dev protobuf-compiler
protoc –version 会告诉我们安装的是3.0版本,这是不对的。我们需要的是2.5版。怎么办呢?只有去GitHub找到2.5版,然后重新编译安装。过程如下:
wget https://github.com/google/protobuf/releases/download/v2.5.0/protobuf-2.5.0.tar.gz

tar -xzf protobuf-2.5..tar.gz

cd protobuf-2.5./

./autogen.sh

./configure

make

make install
现在我们重新运行protoc –version 会看到版本是2.5了。
2.6更新Maven镜像
由于Maven默认连接的是国外的服务器,会很慢,所以我们需要更新Maven源为国内的服务器。推荐还有阿里云的Maven源:http://maven.aliyun.com/ 。
具体做法是:
cd ~/.m2 (如果没有这个文件夹,那么就在~目录mkdir .m2创建这个文件夹)
vi settings.xml
然后输入以下的内容:
<settings xmlns="http://maven.apache.org/SETTINGS/1.0.0" xmlns:xsi="http://www.w3.org/2001/XMLSchema-instance" xsi:schemaLocation="http://maven.apache.org/SETTINGS/1.0.0 http://maven.apache.org/xsd/settings-1.0.0.xsd">

<mirrors>

<mirror>

<id>nexus-aliyun</id>

<mirrorOf>*</mirrorOf>

<name>Nexus aliyun</name>

<url>http://maven.aliyun.com/nexus/content/groups/public</url>

</mirror>

</mirrors>

</settings>
3.编译Hadoop
首先我们下载最新的Hadoop源代码,访问官网http://hadoop.apache.org/releases.html,可以看到最新的是2.7.3,所以我们点击2.7.3的source,会给我们一个比较快的下载地址。
wget http://mirror.bit.edu.cn/apache/hadoop/common/hadoop-2.7.3/hadoop-2.7.3-src.tar.gz
下载完毕后解压:
tar -zxvf hadoop-2.7.-src.tar.gz

cd hadoop-2.7.-src
最后,就是用Maven编译Hadoop:
mvn package -Pdist,native -DskipTests –Dtar
这是一个比较漫长的过程,可能要等10~20来分钟。如果一切正常,那么运行完毕后,我们会看到成功编译的通知:
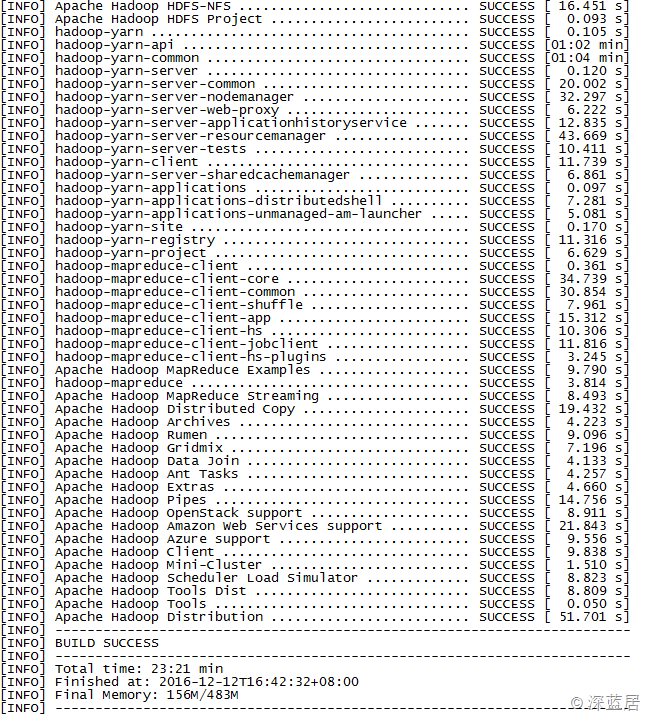
我是在虚拟机中,花了23分钟,我们的Hadoop X64版本就编译出来了。
编译好的Hadoop是在:
hadoop-dist/target/ 目录下,hadoop-2.7.3.tar.gz文件便是。
我们可以把这个包下载到本地,或者传输到其他服务器,接下来就是用这个包安装Hadoop,具体安装配置过程参见我这篇博客。
在Ubuntu X64上编译Hadoop的更多相关文章
- linux(debian) arm-linux-g++ v4.5.1交叉编译 embedded arm 版本的QtWebkit (browser) 使用qt 4.8.6 版本 以及x64上编译qt
最近需要做一个项目 在arm 架构的linux下 没有桌面环境的情况下拉起 有界面的浏览器使用. 考虑用qt 的界面和 qtwebikt 的库去实现这一系列操作. 本文参考: Qt移植到ARM Lin ...
- Windows 10 x64 下编译 Hadoop 源码
Windows 10 x64 下编译 Hadoop 源码 环境准备 Hadoop并没有提供官方的 Windows 10 下的安装包,所以需要自己手动来编译,官方文档中 BUILDING.txt 文件中 ...
- 64位CentOS上编译 Hadoop 2.2.0
下载了Hadoop预编译好的二进制包,hadoop-2.2.0.tar.gz,启动起来后.总是出现这样的警告: WARN util.NativeCodeLoader: Unable to load n ...
- mac OS X Yosemite 上编译hadoop 2.6.0/2.7.0及TEZ 0.5.2/0.7.0 注意事项
1.jdk 1.7问题 hadoop 2.7.0必须要求jdk 1.7.0,而oracle官网已经声明,jdk 1.7 以后不准备再提供更新了,所以趁现在还能下载,赶紧去down一个mac版吧 htt ...
- Windows 10 上编译 Hadoop
下载源码 源码下载地址(Source download):https://hadoop.apache.org/releases.html 这里以 2.9.2 为例,查看源码中的编译说明文件 BUILD ...
- 在Ubuntu系统上搭建Hadoop 2.x(2.6.2)
官方的中文版的Hadoop快速入门教程已经是很老的版本了,新版的Hadoop目录结构发生了变化,因此一些配置文件的位置也略微调整了,例如新版的hadoop中找不到快速入门中提到的conf目录,另外,网 ...
- ubuntu 环境下编译 hadoop 2.6.0的简单方法
由于服务器一般都64位系统, hadoop网站的release版本32位native库不能运行,所以需要自己在编译一下.以下是我采用的一个编译的过程,比较简单,不用下载各种版本及环境配置,通过命令就能 ...
- 在ubuntu server上搭建Hadoop
1. Java安装: Because everything work with java. $ sudo apt-get install openjdk-7-jdk 安装之后,可以查看java的版本信 ...
- CentOS 64位上编译 Hadoop 2.6.0
Hadoop不提供64位编译好的版本号,仅仅能用源代码自行编译64位版本号. 学习一项技术从安装開始.学习hadoop要从编译開始. 1.操作系统编译环境 yum install cmake lzo- ...
随机推荐
- 【WCF】终结点的监听地址
终结点主要作用是向客户端公开一些信息入口,通过这个入口,可以找到要调用的服务操作.通常,终结点会使用三个要素来表述,我记得老蒋(网名:Artech,在园子里可以找到他)在他有关WCF的书里,把这三要素 ...
- JavaScript权威设计--事件冒泡,捕获,事件句柄,事件源,事件对象(简要学习笔记十八)
1.事件冒泡与事件捕获 2.事件与事件句柄 3.事件委托:利用事件的冒泡技术.子元素的事件最终会冒泡到父元素直到跟节点.事件监听会分析从子元素冒泡上来的事件. 事件委托的好处: 1.每个函 ...
- Python标准模块--asyncio
1 模块简介 asyncio模块作为一个临时的库,在Python 3.4版本中加入.这意味着,asyncio模块可能做不到向后兼容甚至在后续的Python版本中被删除.根据Python官方文档,asy ...
- Node.js:console模块
console模块提供了一个简单的调试功能,类似与web浏览器的javscript console. 下面简单介绍下该模块的使用以及用途,我使用了ES6的模版字符串(使用反引号标识),有兴趣的可以去了 ...
- 集成学习之Adaboost算法原理小结
在集成学习原理小结中,我们讲到了集成学习按照个体学习器之间是否存在依赖关系可以分为两类,第一个是个体学习器之间存在强依赖关系,另一类是个体学习器之间不存在强依赖关系.前者的代表算法就是是boostin ...
- ASP.NET 5 - $.ajax post JSON.stringify(para) is null
JavaScript 代码: var para = {}; para.id = $("#ad-text-id").val(); para.title = $("#ad-t ...
- js的OOP继承实现
以下视频截图均来自慕课网javascript深入浅出: 这里Student.prototype之所以使用create方法来创建,而不是直接赋Person.prototype的值,是因为如果使用赋值的话 ...
- 版本控制工具Git的学习笔记
在网上看到一个很不错的Git教程,学习后果断要做一下总结. 教程地址:http://www.liaoxuefeng.com/ 总结要点: 安装Git因为我个人的开发主要是基于windows环境下,所以 ...
- RabbitMQ原理与相关操作(一)
小编是菜鸟一枚,最近想试试MQ相关的技术,所以自己看了下RabbitMQ官网,试着写下自己的理解与操作的过程. 刚开始的第一篇,原理只介绍 生产者.消费者.队列,至于其他的内容,会在后续中陆续补齐. ...
- 【转载】iOS屏幕适配设计
移动app开发中多种设备尺寸适配问题,过去只属于Android阵营的头疼事儿,只是很多设计师选择性地忽视android适配问题,只出一套iOS平台设计稿.随着苹果发布两种新尺寸的大屏iPhone 6, ...