
spark&dataframe
1.今天,我们来介绍spark以及dataframe的相关的知识点,但是在此之前先说一下对以前的hadoop的一些理解
当我启动hadoop的时候,上面有hdfs的存储结构,由于这个是分布式存储,所以当一个节点挂了之后,此后由于
还有别的机器上存储这些block块(这里面你肯定要问了,我们怎么知道它挂了,其实我前面关于akaka的时候rpc
通信的机制,心跳机制),所以这个是我们选择它的理由之一,还有一个原因我们可以进行无限扩容,是因为当我们
使用zookeeper进行管理这些datanode的时候,所以当我们的存储的容量不够的时候,这个时候我们只需要往里
面加机器就可以了,至于存储到哪里,怎么存储,这个就不需要我们管理,这个时候,我们完全可以依赖zookeeper
进行管理即可,在我们启动这个hadoop的环境的时候,分为namenode以及datanode,这个时候我们知道namenode
上面记录着一些block存放入datanode的路径,(其实datanode完全就相当于记录这些block这些的载体),这个时候
我们看到里面有一个yarn启动了,此时这个yarn的流程就是根据namenode判断这些datanode的总资源情况,消耗资源,
还剩资源情况,来决定把当前的这个任务分配到那个datanode上面执行,总的来说,namenode管的是物理地址上面的分配,
以及查找,而yarn则负责的是以何种方式进行分配,从而达到整个资源的最优处理性
其实,一般公司(我司也一样),就是通过日志文件落盘到hdfs上面,我们通过spark来获取这些数据,然后在work上面处理
,然后在把处理后的数据数据放到hdfs的这样的一个流程,好了,大体不详细说明,下面介绍spark的dataframe的相关知识
2.dataframe
1.加载数据,使其变为dataframe
val df = sqlContext.load("hdfs://192.168.109.136/person/output",json)
这个样子读出来就直接变成了DataFrame了(如果上面的命令出错,极大的情况可能是内存不足)

df.select("id","name").save("hdfs://192.168.109.136:9000/output1")此时这个df是
dataframes,把查询到的数据保存到hdfs上面,那么当我们读出来的时候,就是乱码,因为我们明确
的指定要保存的格式
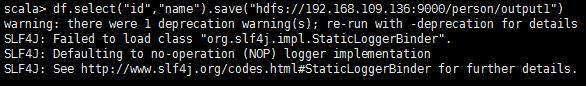

此时这个文件被压缩
则我们如果写成
df.select("id","name").save("192.168.109.136:9000/person/output1","json"),这个里面
存储的就是json格式
3.Parquet File
Apache Parquet最初的设计动机是存储嵌套式的数据,比如Protocolbuffer,thrift,json等,将这类
数据存储成为列式格式,以方便对其高效压缩和编码,这也是Parquet相比于ORC(优化的)优势,他能
够透明的将Protobuf和thrif类型的数据进行列式存储(其中,ORC(OptimizedRC File))存储源自于
RC(RecordColumnar File)这种存储格式,RC是一种列式存储引擎)
spark&dataframe的更多相关文章
- spark dataframe unionall
今天本来想写一个spark dataframe unionall的demo,由于粗心报下面错误: Exception in thread "main" org.apache.spa ...
- spark dataframe操作集锦(提取前几行,合并,入库等)
https://blog.csdn.net/sparkexpert/article/details/51042970 spark dataframe派生于RDD类,但是提供了非常强大的数据操作功能.当 ...
- spark DataFrame 常见操作
spark dataframe派生于RDD类,但是提供了非常强大的数据操作功能.当然主要对类SQL的支持. 在实际工作中会遇到这样的情况,主要是会进行两个数据集的筛选.合并,重新入库. 首先加载数据集 ...
- Spark DataFrame中的join使用说明
spark sql 中join的类型 Spark DataFrame中join与SQL很像,都有inner join, left join, right join, full join; 类型 说明 ...
- spark dataframe 类型转换
读一张表,对其进行二值化特征转换.可以二值化要求输入类型必须double类型,类型怎么转换呢? 直接利用spark column 就可以进行转换: DataFrame dataset = hive.s ...
- 转】Spark DataFrame小试牛刀
原博文出自于: https://segmentfault.com/a/1190000002614456 感谢! 三月中旬,Spark发布了最新的1.3.0版本,其中最重要的变化,便是DataFrame ...
- Spark DataFrame写入HBase的常用方式
Spark是目前最流行的分布式计算框架,而HBase则是在HDFS之上的列式分布式存储引擎,基于Spark做离线或者实时计算,数据结果保存在HBase中是目前很流行的做法.例如用户画像.单品画像.推荐 ...
- spark DataFrame 读写和保存数据
一.读写Parquet(DataFrame) Spark SQL可以支持Parquet.JSON.Hive等数据源,并且可以通过JDBC连接外部数据源.前面的介绍中,我们已经涉及到了JSON.文本格式 ...
- spark DataFrame的创建几种方式和存储
一. 从Spark2.0以上版本开始,Spark使用全新的SparkSession接口替代Spark1.6中的SQLContext及HiveContext接口来实现其对数据加载.转换.处理等功能.Sp ...
- spark DataFrame
DataFrame的推出,让Spark具备了处理大规模结构化数据的能力,不仅比原有的RDD转化方式更加简单易用,而且获得了更高的计算性能.Spark能够轻松实现从MySQL到DataFrame的转化, ...
随机推荐
- Android设置TextView的行间距,EditText下划线
textView用于显示文本,大量文字显示在一起显得过于紧凑.可通过在布局中更改TextView属性设置行间距. 1.android:lineSpacingMultiplier="1.5&q ...
- MyEclipse内存溢出问题
今天碰到的问题,先记录下来 Console报错: Java.lang.OutOfMemoryError: PermGen space 跟着步骤: 在这里加入:-Xms800m -Xmx800m -XX ...
- JavaScript 面向对象编程(三):非构造函数对象的继承
JavaScript 面向对象编程(三):非构造函数对象的继承 一.什么是"非构造函数"的继承? 比如,现在有一个对象,叫做"中国人". var Chinese ...
- 实现pdf word在线浏览和下载
这篇实现的是在线展示pdf和word并且不能显示下载和打印按钮 一 下载功能: 因为html5给a标签新添加了一个属性download,这个属性可以直接实现下载文件的功能:<a href=&qu ...
- TCP的可靠连接是如何产生的?
http://bbs.csdn.net/topics/190011812 看过TCP/IP的源代码没?tcp中所谓的连接只是在tcp的tcb中存储了对端的地址信息,并且记录连接的状态,通过重发之类的来 ...
- 2017.10.18 微机原理与接口----汇编语言语法和DOS功能调用
4.1 汇编语言中的基本数据 ·标识符 ·常数 ·变量具有三个属性: (1)段地址(SEG):变量所在段的段地址 (2)偏移地址(OFFSET):变量所在段内的偏移地址 (3)类型(TYPE):每个变 ...
- ipython notebook的使用
刚开始使用python,用的是ipython notebook,感觉很好用. 写的程序主要是处理文件的,读写txt文件,生成xml文件,其中参考http://www.cnblogs.com/wangs ...
- 前端面试整理(HTML&CSS)
1.行内元素和块级元素?img算什么?行内元素怎么转化为块级元素? 行内元素:和有他元素都在一行上,高度.行高及外边距和内边距都不可改变,文字图片的宽度不可改变,只能容纳文本或者其他行内元素:其中im ...
- 第8条:覆盖equals时请遵守通用约定
第8条:覆盖equals时请遵守通用约定 引言:尽管Object是一个具体类,但是设计它主要是为了拓展.它所有的非final方法(equals.hashCode.toString.clone和fina ...
- 在Linux上部署Kettle环境
首先我们有一个正常安装的,桌面版的Linux. Kettle的应用程序是Linux版本与Windows版本在同一个文件夹下共存的,所以可以直接把本机上的Kettle解压,通过FTP工具上传到Linux ...