
MapReduce Input Split(输入分/切片)具体解释
看了非常多博客。感觉没有一个说的非常清楚,所以我来整理一下。
先看一下这个图
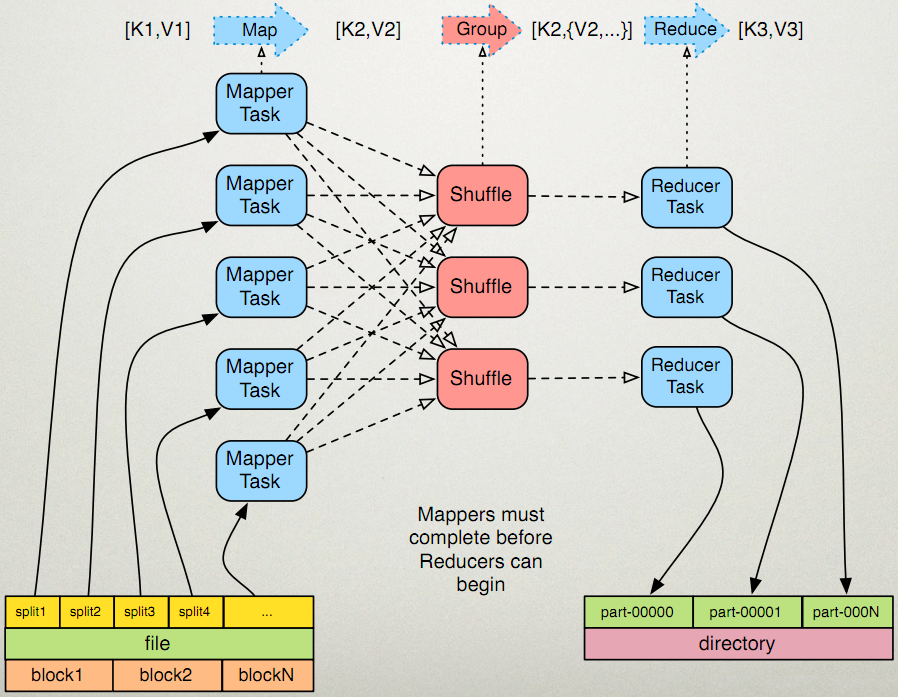
输入分片(Input Split):在进行map计算之前,mapreduce会依据输入文件计算输入分片(input split),每一个输入分片(input split)针对一个map任务。输入分片(input split)存储的并不是数据本身,而是一个分片长度和一个记录数据的位置的数组。
Hadoop 2.x默认的block大小是128MB,Hadoop 1.x默认的block大小是64MB,能够在hdfs-site.xml中设置dfs.block.size。注意单位是byte。
分片大小范围能够在mapred-site.xml中设置。mapred.min.split.size mapred.max.split.size。minSplitSize大小默觉得1B,maxSplitSize大小默觉得Long.MAX_VALUE
= 9223372036854775807
那么分片究竟是多大呢?
minSize=max{minSplitSize,mapred.min.split.size}
maxSize=mapred.max.split.size
splitSize=max{minSize,min{maxSize,blockSize}}
我们再来看一下源代码

所以在我们没有设置分片的范围的时候,分片大小是由block块大小决定的。和它的大小一样。比方把一个258MB的文件上传到HDFS上,如果block块大小是128MB。那么它就会被分成三个block块。与之相应产生三个split,所以终于会产生三个map task。我又发现了还有一个问题,第三个block块里存的文件大小仅仅有2MB,而它的block块大小是128MB,那它实际占用Linux
file system的多大空间?
答案是实际的文件大小,而非一个块的大小。
有大神已经验证这个答案了:http://blog.csdn.net/samhacker/article/details/23089157
1、往hdfs里面加入新文件前,hadoop在linux上面所占的空间为 464 MB:
watermark/2/text/aHR0cDovL2Jsb2cuY3Nkbi5uZXQvc2FtaGFja2Vy/font/5a6L5L2T/fontsize/400/fill/I0JBQkFCMA==/dissolve/70/gravity/Center">
2、往hdfs里面加入大小为2673375 byte(大概2.5 MB)的文件:
2673375 derby.jar
3、此时,hadoop在linux上面所占的空间为 467 MB——添加了一个实际文件大小(2.5 MB)的空间,而非一个block size(128 MB):

4、使用hadoop dfs -stat查看文件信息:
watermark/2/text/aHR0cDovL2Jsb2cuY3Nkbi5uZXQvc2FtaGFja2Vy/font/5a6L5L2T/fontsize/400/fill/I0JBQkFCMA==/dissolve/70/gravity/Center">
这里就非常清楚地反映出: 文件的实际大小(file size)是2673375 byte, 但它的block size是128 MB。
5、通过NameNode的web console来查看文件信息:
watermark/2/text/aHR0cDovL2Jsb2cuY3Nkbi5uZXQvc2FtaGFja2Vy/font/5a6L5L2T/fontsize/400/fill/I0JBQkFCMA==/dissolve/70/gravity/Center">
结果是一样的: 文件的实际大小(file size)是2673375 byte。 但它的block size是128 MB。
6、只是使用‘hadoop fsck’查看文件信息,看出了一些不一样的内容—— ‘1(avg.block size 2673375 B)’:

值得注意的是。结果中有一个 ‘1(avg.block size 2673375 B)’的字样。这里的 'block size' 并非指寻常说的文件块大小(Block Size)—— 后者是一个元数据的概念,相反它反映的是文件的实际大小(file size)。下面是Hadoop Community的专家给我的回复:
“The fsck is showing you an "average blocksize", not the block size metadata attribute of the file like stat shows. In this specific case, the average is just the length of your file, which is lesser than one whole block.”
最后一个问题是: 假设hdfs占用Linux file system的磁盘空间按实际文件大小算。那么这个”块大小“有必要存在吗?
事实上块大小还是必要的,一个显而易见的作用就是当文件通过append操作不断增长的过程中。能够通过来block size决定何时split文件。下面是Hadoop Community的专家给我的回复:
“The block size is a meta attribute. If you append tothe file later, it still needs to know when to split further - so it keeps that value as a mere metadata it can use to advise itself on write boundaries.”
补充:我还查到这样一段话
原文地址:http://blog.csdn.net/lylcore/article/details/9136555
一个split的大小是由goalSize, minSize, blockSize这三个值决定的。computeSplitSize的逻辑是,先从goalSize和blockSize两个值中选出最小的那个(比方一般不设置map数,这时blockSize为当前文件的块size。而goalSize是文件大小除以用户设置的map数得到的,假设没设置的话,默认是1)。
mapreduce的每个map处理的数据是不能跨越文件的,也就是说min_map_num >= input_file_num。
所以,终于的map个数应该为:
MapReduce Input Split(输入分/切片)具体解释的更多相关文章
- MapReduce Input Split 输入分/切片
MapReduce Input Split(输入分/切片)详解 public static long getMaxSplitSize(JobContext context) { return cont ...
- python使用input().split()接收多个用户输入
1.input() 接收多个用户输入需要与split()结合使用 host, port, username, passwd, dbname = input("请输入服务器地址,端口号,用户名 ...
- MapReduce深入理解输入和输出格式(2)-输入和输出完全总结
MapReduce太高深,性能也值得考虑,大家感兴趣的还是看看spark比较好. FileInputFormat类 FileInputFormat是所有使用文件为数据源的InputFormat实现的基 ...
- 【Python笔记】2020年7月30日练习【python用input函数输入一个列表】
练习课题链接:廖雪峰-Python教程-高级特性-迭代 学习记录: 1.Python当中类似于 三目运算符 的应用 2.Python用input函数输入一个列表 代码实例:对用户输入的一组数字转化成l ...
- MapReduce优化一(改变切片大小和Shuffle过程Reduce占用堆大小)
/*为防止处理超大作业时超时,将io时间设为1小时 * <property> <name>dfs.datanode.soc ...
- input框输入金额显示千分位
比如输入:1000000,则显示为1,000,000(或者是保留3位小数:1,000,000.000) 知识点: 1)JavaScript parseFloat() 函数: 定义:parseFloat ...
- JS实现input中输入数字,控制每四位加一个空格(银行卡号格式)
前言 今天来讲讲js中实现input中输入数字,控制每四位加一个空格的方法!这个主要是应用于我们在填写表单的时候,填写银行卡信息,要求我们输入的数字是四位一个空格!今天主要介绍两种方式来实现这个方法! ...
- 项目小结:手机邮箱正则,URL各种判断返回页面,input输入框输入符合却获取不到问题
1.手机邮箱正则 近两年出来很多新号码,听说199什么的都有了- -导致以前的正则不能用了....这就很难过,总是过一段时间出一种新号码.因此,我决定使用返朴归真的手机正则. 手机正则:var reg ...
- 编辑表格输入内容、根据input输入框输入数字动态生成表格行数、编辑表格内容提交传给后台数据处理
编辑表格输入内容.根据input输入框输入数字动态生成表格行数.编辑表格内容提交传给后台数据处理 记录自己学习做的东西,写的小demo,希望对大家也有帮助! 代码如下: <!DOCTYPE ht ...
随机推荐
- 【Linux】linux下查看目录所在分区
命令如下: df -h 目录名 具体使用例子如下:查看/home/sxd/文档处于哪个分区 ------------------------------------------------------ ...
- mysql的三大范式
关系数据库的几种设计范式介绍: 第一范式:确保每列的原子性(强调的是列的原子性,即列不能够再分成其他几列). 如果每列(或者每个属性)都是不可再分的最小数据单元(也称为最小的原子单元),则满足第一范式 ...
- 【Hadoop】HDFS冗余数据块的自动删除
HDFS冗余数据块的自动删除 在日常维护hadoop集群的过程中发现这样一种情况: 某个节点由于网络故障或者DataNode进程死亡,被NameNode判定为死亡, HDFS马上自动开始数据块的容错拷 ...
- 常见的Linux系统监控命令
1.free 显示当前系统未使用的和已使用的内存数目,还可以显示被内核使用的内存缓冲区 -b:以Byte为单位显示内存使用情况: -k:以KB为单位显示内存使用情况: -m:以MB为单位显示内存使 ...
- 如何让mysql的自动递增的字段重新从1开始呢?(
数据库表自动递增字段在用过一段时间后清空,还是继续从清空后的自动编号开始.如何才能让这个字段自动从1开始自动递增呢? 下面两个方法偶都试过,很好用: 1 清空所有数据,将自增去掉,存盘,在加上自增,存 ...
- Android中IntentService详解
简单说,IntentService是继承于Service并处理异步请求的一个类,在IntentService内有一个工作线程来处理耗时操作,启动IntentService的方式和启动传统Service ...
- 排查 “Detected Tx Unit Hang”问题
实现功能: 使用自己已经分配的内存让skb->data指向,而不是使用alloc_malloc(). 部分代码如下: /* * build a new sk_buff */ //struct s ...
- 【转载】LR - 细节解析,为什么LR脚本会去访问“脚本中不存在的“资源?
问题描述 同事遇到的一个问题,LR执行性能测试脚本时,总报出错误,无法访问一个图片的地址,但脚本中明明没有对该资源的请求. Action4.c(12): Warning -27796: Failed ...
- 在PreferenceAcitity中使用Fragement时避免额外的Left和RightPadding
On Android 4.4 遇到过这种问题: 注意到.上面的ActionBar部分的左右各有48像素的padding. 要了解该问题的成因,要首先了解其结构: 该页面的Activity是一个Pref ...
- MySQL性能优化的最佳20+条经验(转)
今天,数据库的操作越来越成为整个应用的性能瓶颈了,这点对于Web应用尤其明显.关于数据库的性能,这并不只是DBA才需要担心的事,而这更是我们程序 员需要去关注的事情.当我们去设计数据库表结构,对操作数 ...