
Hadoop计数器
1. MapReduce计数器是什么
计数器是用来记录Job的执行进度和状态的,其作用类似于日志。我们可以在程序的某个位置插入计数器,记录数据或进度的变化情况。
2. MapReduce计数器能做什么
计数器为我们提供了一个窗口,用于观察Job运行期间的各种细节数据,对MapReduce的性能调优很有帮助,MapReduce性能优化的评估大部分都是基于这些计数器Counter的数值来表现的。
3. MapReduce都有哪些内置计数器
MapReduce中自带了许多默认的Counter计数器,要了解这些内置计数器,必须知道计数组名称(groupName)和计数器名称(counterName)。
(1)任务计数器
在任务技术过程中,它负责采集任务的主要信息,每个作业的所有任务的结果都会被聚集起来。下面以MapReduce人事物计数器为例:
groupName:org.apache.hadoop.mapreduce.TaskCounter
counterName:
1)MAP_INPUT_RECORDS
2)REDUICE_INPUT_RECORDS
3)CPU_MILLISECONDS
(2)作业计数器
作业计数器由JobTracker或者YARN维护维护,因此无需在网络间传输数据。这些计数器都是作业级别的通缉量,其值不会随着任务运行而改变。
groupName:org.apache.hadoop.mapreduce.JobCounter
counterName:
1)TOTAL_LAUNCHED_MAPS
2)TOTAL_LAUNCHED_REDUCES
4. 计数器该如何使用
(1)定义计数器
1)枚举声明计数器
Contex contex…
//自定义枚举变量
Counter counter = contex.getCounter(Enum eum)
2)自定义计数器
Contex contex…
//自己命名groupName和counterName
Counter counter = contex.getCounter(String groupName, String counterName)
(2)为计数器赋值
1) 初始化计数器
counter.setValue(long value);//设置初始值
2) 计数器自增
counter.increment(long incr);//增加计数
(3) 获取计数器的值
1) 获取枚举计数器的值
Job job…
job.waitForCompletion(true);
Counters counters = job.getCounters();
Counter counter = counters.findCounter(BAD_RECORDS);
//查找枚举计数器,假如Enum的变量为BAD_RECORDS
long value = counter.getValue();//获取计数值
2) 获取自定义计数器的值
Job job...
job.waitForCompletion(true);
Counters counters=job.getCounters();
Counter counter=counters.findCounter("ErrorCounter","toolong");//假如groupName为ErrorCounter,counterName为toolong
long value=counter.getValue();//获取计数值
3)获取内置计数器的值
Job job...
job.waitForCompletion(true);
Counters counters=job.getCounters();
Counter counter=counters.findCounter("org.apache.hadoop.mapreduce.JobCounter", "TOTAL_LAUNCHED_REDUCES");
//假如groupName为org.apache.hadoop.mapreduce.JobCounter,counterName为TOTAL_LAUNCHED_REDUCES
long value=counter.getValue();//获取计数值
4)获取所有计数器的值
Counters counters = job.getCounters();
for (CounterGroup group : counters) {
for (Counter counter : group) {
System.out.println(counter.getDisplayName() + ": " + counter.getName() + ": "+ counter.getValue());
}
}
5. 自定义计数器
自定义计数器用的比较广泛,特别是统计无效数据条数的时候,我们就会用到计数器来记录错误日志的条数。下面我们自定义计数器,统计输入的无效数据。
数据集
假如一个文件,规范的格式是3个字段,“\t”作为分隔符,其中有2条异常数据,一条数据是只有2个字段,一条数据是有4个字段。其内容如下所示:
jim 1 28
kate 0 26
tom 1
kaka 1 22
lily 0 29 22
启动Hadoop集群,然后在HDFS中新建目录存放测试数据。
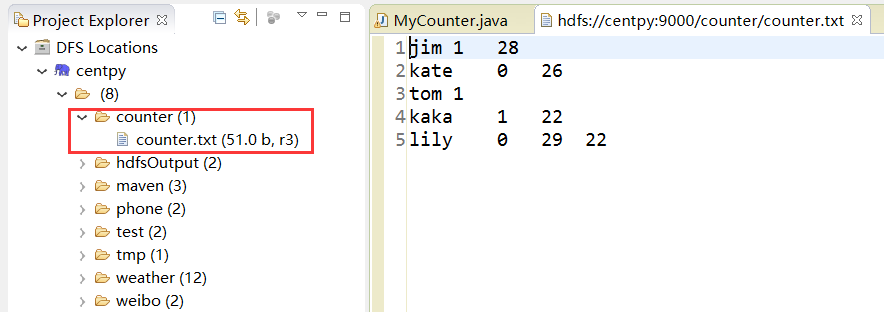
在Hadoop项目下新建MyCounter.java类
package com.hadoop.Counter;

import java.io.IOException;

import org.apache.hadoop.conf.Configuration;

import org.apache.hadoop.conf.Configured;

import org.apache.hadoop.fs.FileSystem;

import org.apache.hadoop.fs.Path;

import org.apache.hadoop.io.LongWritable;

import org.apache.hadoop.io.Text;

import org.apache.hadoop.mapreduce.Job;

import org.apache.hadoop.mapreduce.Mapper;

import org.apache.hadoop.mapreduce.lib.input.FileInputFormat;

import org.apache.hadoop.mapreduce.lib.output.FileOutputFormat;

import org.apache.hadoop.util.Tool;

import org.apache.hadoop.util.ToolRunner;

/**

 * @author Zimo

 * MapReduce计数器

 */

public class MyCounter extends Configured implements Tool {

    /**

     * @param args

     */

    public static class MyCounterMap extends Mapper<LongWritable, Text, Text, Text> {

        //定义枚举对象

        public static enum LOG_PROCESSOR_COUNTER {

            //枚举对象BAD_RECORDS_LONG来统计长数据,枚举对象BAD_RECORDS_SHORT来统计短数据

            BAD_RECORDS_LONG, BAD_RECORDS_SHORT

        };

        protected void map(LongWritable key, Text value, Context context) throws IOException, InterruptedException {

            String arr_values[] = value.toString().split("/t");

            if (arr_values.length > ) {

                //动态自定义计数器

                context.getCounter("ErrorCounter", "toolong").increment();

                //枚举声明计数器

                context.getCounter(LOG_PROCESSOR_COUNTER.BAD_RECORDS_LONG).increment();

            } else if(arr_values.length < ) {

                // 动态自定义计数器

                context.getCounter("ErrorCounter", "tooshort").increment();

                // 枚举声明计数器

                context.getCounter(LOG_PROCESSOR_COUNTER.BAD_RECORDS_SHORT).increment();

            } else {

                context.write(value, new Text(""));

            }

        }

    }

    public int run(String[] args) throws IOException, ClassNotFoundException, InterruptedException {

        Configuration conf = new Configuration();

        Path myPath = new Path(args[]);

        FileSystem hdfs = myPath.getFileSystem(conf);

        if (hdfs.isDirectory(myPath)) {

            hdfs.delete(myPath);

        }

        Job job = new Job(conf, "MyCounter");

        job.setJarByClass(MyCounter.class);

        job.setMapperClass(MyCounterMap.class);

        job.setOutputKeyClass(Text.class);

        job.setOutputValueClass(Text.class);

        FileInputFormat.addInputPath(job, new Path(args[]));

        FileOutputFormat.setOutputPath(job, new Path(args[]));

        job.waitForCompletion(true);

        return ;

    }

    public static void main(String[] args) throws Exception {

        // TODO Auto-generated method stub

        String[] arg0 = {

                "hdfs://centpy:9000/counter/counter.txt", "hdfs://centpy:9000/counter/out"

        };

        int ec = ToolRunner.run(new Configuration(), new MyCounter(), arg0);

        System.exit(ec);

    }

}
运行程序之后,日志如下所示。
-- ::, INFO [org.apache.hadoop.mapreduce.Job] - Counters:

    File System Counters

        FILE: Number of bytes read=

        FILE: Number of bytes written=

        FILE: Number of read operations=

        FILE: Number of large read operations=

        FILE: Number of write operations=

        HDFS: Number of bytes read=

        HDFS: Number of bytes written=

        HDFS: Number of read operations=

        HDFS: Number of large read operations=

        HDFS: Number of write operations=

    Map-Reduce Framework

        Map input records=

        Map output records=

        Map output bytes=

        Map output materialized bytes=

        Input split bytes=

        Combine input records=

        Combine output records=

        Reduce input groups=

        Reduce shuffle bytes=

        Reduce input records=

        Reduce output records=

        Spilled Records=

        Shuffled Maps =

        Failed Shuffles=

        Merged Map outputs=

        GC time elapsed (ms)=

        CPU time spent (ms)=

        Physical memory (bytes) snapshot=

        Virtual memory (bytes) snapshot=

        Total committed heap usage (bytes)=

    ErrorCounter

        tooshort=

    com.hadoop.Counter.MyCounter$MyCounterMap$LOG_PROCESSOR_COUNTER

        BAD_RECORDS_SHORT=

    File Input Format Counters

        Bytes Read=

    File Output Format Counters

        Bytes Written=0
从日志中可以看出,通过枚举声明和自定义计数器两种方式,统计出的不规范数据是一样的。
以上就是博主为大家介绍的这一板块的主要内容,这都是博主自己的学习过程,希望能给大家带来一定的指导作用,有用的还望大家点个支持,如果对你没用也望包涵,有错误烦请指出。如有期待可关注博主以第一时间获取更新哦,谢谢!
版权声明:本文为博主原创文章,未经博主允许不得转载。
Hadoop计数器的更多相关文章
- hadoop 计数器
一.hadoop有非常多自带的计数器,相信看过执行log的都会看到各种数据 二.用户自己定义计数器 在开发中常常须要记录错误的数据条数,就能够用计数器来解决. 1.定义:用一个枚举来定义一组计数器,枚 ...
- Hadoop日记Day17---计数器、map规约、分区学习
一.Hadoop计数器 1.1 什么是Hadoop计数器 Haoop是处理大数据的,不适合处理小数据,有些大数据问题是小数据程序是处理不了的,他是一个高延迟的任务,有时处理一个大数据需要花费好几个小时 ...
- MapReducer Counter计数器的使用,Combiner ,Partitioner,Sort,Grop的使用,
一:Counter计数器的使用 hadoop计数器:可以让开发人员以全局的视角来审查程序的运行情况以及各项指标,及时做出错误诊断并进行相应处理. 内置计数器(MapReduce相关.文件系统相关和作业 ...
- Hadoop学习记录(4)|MapReduce原理|API操作使用
MapReduce概念 MapReduce是一种分布式计算模型,由谷歌提出,主要用于搜索领域,解决海量数据计算问题. MR由两个阶段组成:Map和Reduce,用户只需要实现map()和reduce( ...
- MapReduce的计数器
第一部分.Hadoop计数器简述 hadoop计数器: 可以让开发人员以全局的视角来审查程序的运行情况以及各项指标,及时做出错误诊断并进行相应处理. 内置计数器(MapReduce相关.文件系统相关 ...
- HIVE编程指南之HiveQL的学习笔记1
// HiveQLa) 数据定义语言1 数据库表的一个目录或命名空间,如果用户没有指定数据库的话,那么将会使用默认的数据库default-----创建数据库CREATE DATABASE guoyon ...
- HQL之动态分区调整
动态分区插入可以基于查询语句分出出要插入的分区名称.比如,下面向分区表插入数据的SQL: insert into table chavin.emp_pat partition(dname,loc) s ...
- hive从查询中获取数据插入到表或动态分区
Hive的insert语句能够从查询语句中获取数据,并同时将数据Load到目标表中.现在假定有一个已有数据的表staged_employees(雇员信息全量表),所属国家cnty和所属州st是该表的两 ...
- Hive Tutorial 阅读记录
Hive Tutorial 目录 Hive Tutorial 1.Concepts 1.1.What Is Hive 1.2.What Hive Is NOT 1.3.Getting Started ...
随机推荐
- MongoDB之二基础入门(window/linux安装启动)
mongodb中有三元素:数据库,集合,文档,其中“集合”就是对应关系数据库中的“表”,“文档”对应“行”. 一window安装与启动 一. 下载 上MongoDB官网 ,下载页面:https://w ...
- oracle--存储过程2--bk
oracle存储过程demo1---无返回值的存储过程: /* 写一个过程,可以向book表添加书 */ create table book( id number(4), book_name varc ...
- 关于ArcGis for javascrept之Map类
ArcGis for javascrept_ESRI_Map类: 1. 构造方法:esri.Map(); 参数: extent 如果设置了该选项,一旦这个选项的投影被设置,那么所有的图层都在定义的投 ...
- koa1创建项目
1.一定要全局安装(koa1.2和koa2都己经支持)npm install koa-generator -g 2.koa1.2 生成一个test项目,切到test目录并下载依赖 koa testcd ...
- mysql修改查询出来的时间格式
var d = new Date(rss.createtime); let youWant = d.getFullYear() + ) + '-' + d.getDate() + ' ' + d.ge ...
- 大富翁开发日记:一、使用巨型lua协程
一个大胆的尝试:使用巨型lua协程来表示整个“一局”流程. lua协程是一个很另类的功能,有并发的影子但又不是真的并发,所以真正拿它来做大功能框架的范例不多,通常用于一些小型trick式设计.但这次我 ...
- 数据库 连接(join)
转自http://www.cnblogs.com/caozengling/p/5318696.html 数据库中飞内连接,自然连接,外连接 数据库中的连接join氛围内连接,自然连接,外连接,外连接又 ...
- [转]关于CLOB存储Base64图片编码,直接在前台显示解决方案
转至:http://ouapi.com/tool/imgtob 两种方案: Base64在CSS中的使用 .yanshishuxing{ background-image: url("dat ...
- Java中编写线程安全代码的原理(Java concurrent in practice的快速要点)
Java concurrent in practice是一本好书,不过太繁冗.本文主要简述第一部分的内容. 多线程 优势 与单线程相比,可以利用多核的能力; 可以方便的建模成一个线程处理一种任务; 与 ...
- 第三章 Goroutine调度策略(16)
本文是<Go语言调度器源代码情景分析>系列的第16篇,也是第三章<Goroutine调度策略>的第1小节. 在调度器概述一节我们提到过,所谓的goroutine调度,是指程序代 ...