
使用pandas的部分问题汇总
pandas(我所用版本0.17)是一个强大数据处理库,在开发金融类系统中我应用到了pandas.Dataframe数据类型,它的数据结构类似一张图表(如下图所示),左边一列为index既行的索引:
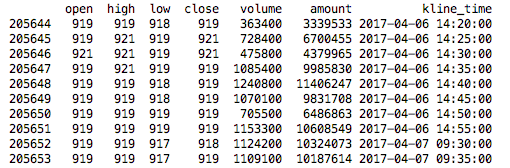
图1
下面主要介绍在开发中使用方法:
1,DataFrame将1分钟K线数据合成5分钟数据
pd_1m = pd.DataFrame() #已有1分钟K线数据

#合成新K线的前提是df的数据的index必须是时间

pd_1m = pd_1m.set_index('kline_time') #将时间戳设置为index

#设置df数据中每列的规则

ohlc_rule = {

    'open': 'first',#open列:序列中第一个的值

    'high': 'max',#high列:序列中最大的值

    'low': 'min',#low列:序列中最小的值

    'close': 'last',#close列:序列中最后一个的值

    'volume': 'sum',#volume列:将所有序列里的volume值作和

    'amount': 'sum'#amount列:将所有序列里的amount值作和

}

#合成5分钟K线并删除为空的行 参数 closed:left类似向上取值既 09:30的k线数据是包含09:30-09:35之间的数据

pd_5m = pd_1m.resample('5min', how=ohlc_rule, closed='left', label='left').dropna(axis=0, how='any')

#dropna(axis=0, how='any') axis参数0:针对行进行操作 1:针对列进行操作  how参数any:只要包含就删除 all:全是为NaN才删除
2,DataFrame的行遍历及过滤
import pandas as pd

import numpy as np

dates = pd.date_range('2020-01-01',periods=6)

df = pd.DataFrame(np.random.rand(6,4),index=dates,columns=['a','b','c','d'])

# iloc根据行号来取值

print(df.iloc[3]) # 第三行

print(df.iloc[1:4]) # 左闭右开

# loc根据行头来取值 此数据行头是日期

print(df.loc["2020-01"]) # 行头包含2020-01字符串的所有行

print(df.loc["2020-01-02": "2020-01-04",["b","c"]]) # 行头再这个范围内 可指定显示某几列

# 根据列来筛选

print(df["a"]) # 获取单列

print(df[["a","b"]]) # 获取多列

# 以下根据条件筛选也可用于loc函数中

print(df[df['a']>0]) # a列数据大于0的行筛选出来

print(df[~df['a'].isin([2,3,5])]) # ~表示不满足该条件的其他数据 isin表示在某个list中

print(df[(df['a'].isin([2, 3])) & (df['b'] != 0)]) # &与;|表示或 ;运算符:!=不等于 == > < 以此类推等等

# df行遍历

for index,row in enumerate(df.iterrows()):

    # row既每行,包含行头及行数据

    print(index,row[0],row[1])
3,pandas中转化数据及变更类型
import pandas as pd

import numpy as np

# 整理,格式化数据

dates = pd.date_range('2020-01-01',periods=6)

df = pd.DataFrame(np.random.rand(6,4),index=dates,columns=['a','b','c','d'])

df["e"] = pd.Series([1,1,3,4,4,2],index=dates)

# apply根据用户执行axis来计算得到新行/列数据 1=列 默认行0

f_col = df.apply(lambda k: k['a']*k['b'] if k['c'] >0.5 else k['a']*k['c'], axis=1)

# map是Series的函数通过mapping来生成新的数据行/列 可以使用dict,也可函数

print(df["e"].map({1: 9}))

print(df["e"].map(lambda x: 0 if x > 3 else 1))

# applymap 处理全部的行业数据

def cal_custom(data):

    return float("%.2f" % data)

print(df.applymap(cal_custom))

# 在统计分析中会用到变量类型装换 需要转为分类型变量

z = pd.Series([3,4,6,6,4])

z = z.astype("category") # 分类型变量(分类型变量本身可以是数字格式)

# 转换为数字类型

pd.to_numeric(z, errors='coerce') # ignore

# 指定分类型变量为指定顺序的有序分类型变量

print(z.cat.reorder_categories([4,6,3]))
# pandas中pandas.tslib.Timestamp的计算及转换
dtime = pandas.tslib.Timestamp()

dtime = dtime + np.timedelta64(8, 'h')#给时间加上8小时 np为numpy 参数 h 小时 m 分钟

dtime = dtime.strftime('%Y-%m-%d %H:%M:%S')#转换为字符格式
4,其他
print(df.cov()) # 协方差矩阵
print(df.corr()) # 相关系数矩阵
print(df.corrwith(df["a"])) #  某列与其他列的相关系数结果
print(df.groupby(["a","b"]).agg(['mean','std','count','max','sum'])) # std标准差
以上主要为开发问题中遇到的场景,有局限性,希望大家能用上~
使用pandas的部分问题汇总的更多相关文章
- pandas知识点脑图汇总
参考文献: [1]Pandas知识点脑图汇总
- pandas(三)汇总和计算描述统计
pandas对象有一些常用的数学和统计的方法,大部分都属于约简或汇总统计. SUM方法 DataFrame对象的sum方法,返回一个含有列小计的Series >>> df = Dat ...
- 用Python的pandas框架操作Excel文件中的数据教程
用Python的pandas框架操作Excel文件中的数据教程 本文的目的,是向您展示如何使用pandas 来执行一些常见的Excel任务.有些例子比较琐碎,但我觉得展示这些简单的东西与那些你可以在其 ...
- Python_科学计算平台__pypi体系的numpy、scipy、pandas、matplotlib库简介
1.numpy--基础,以矩阵为基础的数学计算模块,纯数学 存储和处理大型矩阵. 这个是很基础的扩展,其余的扩展都是以此为基础. 快速学习入口 https://docs.scipy.org/doc/n ...
- 利用Python进行数据分析(9) pandas基础: 汇总统计和计算
pandas 对象拥有一些常用的数学和统计方法. 例如,sum() 方法,进行列小计: sum() 方法传入 axis=1 指定为横向汇总,即行小计: idxmax() 获取最大值对应的索 ...
- 【学习】数据处理基础知识(汇总和计算描述统计)【pandas】
pd对象拥有一组常用的数学和统计方法.大部分都属于约简和汇总统计,用于从Series中单个值,如sum 和 mean 或从DF的行或列中提取一个Series. 1. 描述和汇总统计方法 #汇总和计算描 ...
- Pandas基本功能之层次化索引及层次化汇总
层次化索引 层次化也就是在一个轴上拥有多个索引级别 Series的层次化索引 data=Series(np.random.randn(10),index=[ ['a','a','a','b','b', ...
- Pandas汇总和处理缺失数据
汇总的函数 方法 说明 count 非NA的值数量 describe 针对Series和DataFrame列计算汇总统计 min.max 计算最小值和最大值 argmin.argmax 计算能够获取到 ...
- pandas汇总和计算描述统计
pandas 对象拥有一组常用的数学和统计方法. 他们大部分都属于简约和汇总统计, 用于从Series中提取单个值(如sum或mean) 或从DataFrame的行或列中提取一个Series.跟对应的 ...
随机推荐
- [No0000195]NoSQL还是SQL?这一篇讲清楚
随着大数据时代的到来,越来越多的网站.应用系统需要支撑海量数据存储,高并发.高可用.高可扩展性等特性要求. 传统的关系型数据库在应付这些已经显得力不从心,并暴露了许多难以克服的问题. 由此,各种各样的 ...
- Spring Boot 你所不知道的超级知识学习路线清单
因而 Spring Boot 应用本质上就是一个基于 Spring 框架的应用,它是 Spring 对“约定优先于配置”理念的最佳实践产物,它能够帮助开发者更快速高效地构建基于 Spring 生态圈的 ...
- sale.order
# 初始化一个变量用来记录产品类型line_type = ''# 循环明细行for product in self.options: # 拿到该明细行的产品类型 product_type = prod ...
- spark-sql中的DataFrame文件格式转储示例
SparkConf sparkConf = new SparkConf() // .setMaster("local") .setAppName("DataFrameTe ...
- bugfree3.0.1-导入excel测试用例
大多数项目里只用BugFree做缺陷管理工具,其实还可以通过该工具导入测试用例,记录测试结果,最后获得统计结果. 难点 1.导入文件要求XML格式: 2.一般我们的测试用例都是用excle文件存取,很 ...
- PHP Echarts Ajax Json柱形图示例
<?php $server = '127.0.0.1'; $user = 'root'; $password = ''; $database = 'yiibaidb'; $conn = new ...
- 用git如何把单个文件回退到某一版本
暂定此文件为a.jsp 1.首先到a.jsp所在目录: 通过 git log a.jsp 查看a.jsp的更改记录 2.找到想要回退的版本号:例如 fcd2093 通过 git reset fcd ...
- git 如何删除已经add的文件
git rm --cached "文件" 参考: https://blog.csdn.net/kiss_the_sky/article/details/77921206
- 小程序canvas生成海报保存至手机相册
小程序canvas画图保存至手机相册 (1)可直接展示生成的海报 .因手机分辨率不同可能导致生成的海报会有细微差别,这里隐藏canvas海报,页面正常设置海报样式保存时保存隐藏的canvas海报 (2 ...
- 单端测序(Single-read)和双端测序(Paired-end和Mate-pair)的关系
https://blog.csdn.net/hanli1992/article/details/82982434