
大数据学习环境搭建(CentOS6.9+Hadoop2.7.3+Hive1.2.1+Hbase1.3.1+Spark2.1.1)
|
node1 192.168.1.11 |
node2 192.168.1.12 |
node3 192.168.1.13 |
备注 | ||
|
NameNode |
Hadoop |
Y |
Y |
高可用 | |
|
DateNode |
Y |
Y |
Y |
||
|
ResourceManager |
Y |
Y |
高可用 | ||
| NodeManager |
Y |
Y |
Y |
||
|
JournalNodes |
Y |
Y |
Y |
奇数个,至少3个节点 | |
| ZKFC(DFSZKFailoverController) |
Y |
Y |
有namenode的地方就有ZKFC | ||
|
QuorumPeerMain |
Zookeeper |
Y |
Y |
Y |
|
|
MySQL |
HIVE |
Y |
Hive元数据库 | ||
|
Metastore(RunJar) |
Y |
||||
|
HIVE(RunJar) |
Y |
||||
| HMaster | HBase | Y | Y | 高可用 | |
| HRegionServer | Y | Y | Y | ||
|
Spark(Master) |
Spark |
Y |
Y |
高可用 | |
|
Spark(Worker) |
Y |
Y |
Y |
以前搭建过一套,带Federation,至少需4台机器,过于复杂,笔记本也吃不消。现为了学习Spark2.0版本,决定去掉Federation,简化学习环境,不过还是完全分布式
apache-ant-1.9.9-bin.tar.gzapache-hive-1.2.1-bin.tar.gzapache-maven-3.3.9-bin.tar.gzapache-tomcat-6.0.44.tar.gzCentOS-6.9-x86_64-minimal.isofindbugs-3.0.1.tar.gzhadoop-2.7.3-src.tar.gzhadoop-2.7.3.tar.gzhadoop-2.7.3(自已编译的centOS6.9版本).tar.gzhbase-1.3.1-bin(自己编译).tar.gzhbase-1.3.1-src.tar.gzjdk-8u121-linux-x64.tar.gzmysql-connector-java-5.6-bin.jarprotobuf-2.5.0.tar.gzscala-2.11.11.tgzsnappy-1.1.3.tar.gzspark-2.1.1-bin-hadoop2.7.tgz
关闭防火墙
zookeeper
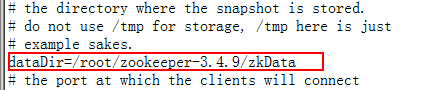
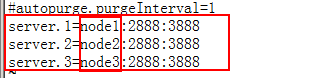

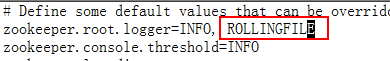
环境变量
export JAVA_HOME=/root/jdk1.8.0_121export SCALA_HOME=/root/scala-2.11.11export HADOOP_HOME=/root/hadoop-2.7.3export HIVE_HOME=/root/apache-hive-1.2.1-binexport HBASE_HOME=/root/hbase-1.3.1export SPARK_HOME=/root/spark-2.1.1-bin-hadoop2.7export PATH=.:$PATH:$JAVA_HOME/bin:$SCALA_HOME/bin:$HADOOP_HOME/bin:$HADOOP_HOME/sbin:/root:$HIVE_HOME/bin:$HBASE_HOME/bin:$SPARK_HOMEexport CLASSPATH=.:$JAVA_HOME/jre/lib/rt.jar:$JAVA_HOME/lib/dt.jar:$JAVA_HOME/lib/tools.jar
Hadoop

<property><name>dfs.replication</name><value>2</value></property><property><name>dfs.blocksize</name><value>64m</value></property><property><name>dfs.permissions.enabled</name><value>false</value></property><property><name>dfs.nameservices</name><value>mycluster</value></property><property><name>dfs.ha.namenodes.mycluster</name><value>nn1,nn2</value></property><property><name>dfs.namenode.rpc-address.mycluster.nn1</name><value>node1:8020</value></property><property><name>dfs.namenode.rpc-address.mycluster.nn2</name><value>node2:8020</value></property><property><name>dfs.namenode.http-address.mycluster.nn1</name><value>node1:50070</value></property><property><name>dfs.namenode.http-address.mycluster.nn2</name><value>node2:50070</value></property><property><name>dfs.namenode.shared.edits.dir</name><value>qjournal://node1:8485;node2:8485;node3:8485/mycluster</value></property><property><name>dfs.journalnode.edits.dir</name><value>/root/hadoop-2.7.3/tmp/journal</value></property><property><name>dfs.ha.automatic-failover.enabled.mycluster</name><value>true</value></property><property><name>dfs.client.failover.proxy.provider.mycluster</name><value>org.apache.hadoop.hdfs.server.namenode.ha.ConfiguredFailoverProxyProvider</value></property><property><name>dfs.ha.fencing.methods</name><value>sshfence</value></property><property><name>dfs.ha.fencing.ssh.private-key-files</name><value>/root/.ssh/id_rsa</value></property>
<property><name>fs.defaultFS</name><value>hdfs://mycluster</value></property><property><name>hadoop.tmp.dir</name><value>/root/hadoop-2.7.3/tmp</value></property><property><name>ha.zookeeper.quorum</name><value>node1:2181,node2:2181,node3:2181</value></property>
node1node2node3
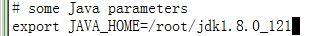
<configuration><property><name>mapreduce.framework.name</name><value>yarn</value></property><property><name>mapreduce.jobhistory.address</name><value>node1:10020</value></property><property><name>mapreduce.jobhistory.webapp.address</name><value>node1:19888</value></property><property><name>mapreduce.jobhistory.max-age-ms</name><value>6048000000</value></property></configuration>
<property><name>yarn.nodemanager.aux-services</name><value>mapreduce_shuffle</value></property><property><name>yarn.nodemanager.aux-services.mapreduce_shuffle.class</name><value>org.apache.hadoop.mapred.ShuffleHandler</value></property><property><name>yarn.resourcemanager.ha.enabled</name><value>true</value></property><property><name>yarn.resourcemanager.cluster-id</name><value>yarn-cluster</value></property><property><name>yarn.resourcemanager.ha.rm-ids</name><value>rm1,rm2</value></property><property><name>yarn.resourcemanager.hostname.rm1</name><value>node1</value></property><property><name>yarn.resourcemanager.hostname.rm2</name><value>node2</value></property><property><name>yarn.resourcemanager.webapp.address.rm1</name><value>node1:8088</value></property><property><name>yarn.resourcemanager.webapp.address.rm2</name><value>node2:8088</value></property><property><name>yarn.resourcemanager.zk-address</name><value>node1:2181,node2:2181,node3:2181</value></property><property><name>yarn.resourcemanager.recovery.enabled</name><value>true</value></property><property><name>yarn.resourcemanager.store.class</name><value>org.apache.hadoop.yarn.server.resourcemanager.recovery.ZKRMStateStore</value></property><property><name>yarn.log-aggregation-enable</name><value>true</value></property><property><name>yarn.log.server.url</name><value>http://node1:19888/jobhistory/logs</value></property>
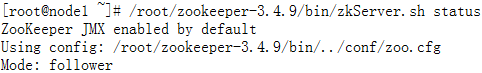
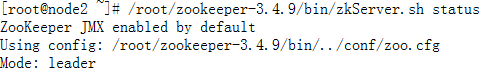
启动ZK

格式化zkfc

启动journalnode
Namenode格式化和启动
启动zkfc
启动datanode
启动yarn
安装MySQL
[root@node1 ~]# mysql -h localhost -u root -p
[client]default-character-set=utf8[mysql]default-character-set=utf8[mysqld]character-set-server=utf8lower_case_table_names = 1
HIVE安装
Hbase编译安装
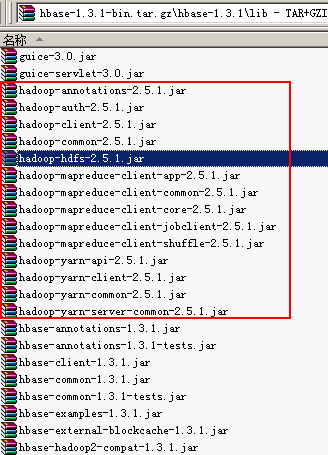
<property><name>hbase.rootdir</name><value>hdfs://mycluster:8020/hbase</value></property><property><name>hbase.cluster.distributed</name><value>true</value></property><property><name>hbase.zookeeper.quorum</name><value>node1:2181,node2:2181,node3:2181</value></property><property><name>hbase.master.port</name><value>60000</value></property><property><name>hbase.master.info.port</name><value>60010</value></property>
node1node2node3
# Configure PermSize. Only needed in JDK7. You can safely remove it for JDK8+
#export HBASE_MASTER_OPTS="$HBASE_MASTER_OPTS -XX:PermSize=128m -XX:MaxPermSize=128m"#export HBASE_REGIONSERVER_OPTS="$HBASE_REGIONSERVER_OPTS -XX:PermSize=128m -XX:MaxPermSize=128m"
spark
export SCALA_HOME=/root/scala-2.11.11export JAVA_HOME=/root/jdk1.8.0_121export HADOOP_HOME=/root/hadoop-2.7.3export HADOOP_CONF_DIR=/root/hadoop-2.7.3/etc/hadoopexport SPARK_DAEMON_JAVA_OPTS="-Dspark.deploy.recoveryMode=ZOOKEEPER -Dspark.deploy.zookeeper.url=node1:2181,node2:2181,node3:2181 -Dspark.deploy.zookeeper.dir=/spark"
node1node2node3
./start.sh
./stop.sh
./shutdown.sh
./reboot.sh
大数据学习环境搭建(CentOS6.9+Hadoop2.7.3+Hive1.2.1+Hbase1.3.1+Spark2.1.1)的更多相关文章
- 虚拟机CentOs的安装及大数据的环境搭建
大数据问题汇总 1.安装问题 1.安装步骤,详见文档<centos虚拟机安装指南> 2.vi编辑器使用问题,详见文档<linux常用命令.pd ...
- windows下大数据开发环境搭建(2)——Hadoop环境搭建
一.所需环境 ·Java 8 二.Hadoop下载 http://hadoop.apache.org/releases.html 三.配置环境变量 HADOOP_HOME: C:\hadoop- Pa ...
- windows下大数据开发环境搭建(1)——Java环境搭建
一.Java 8下载 https://www.oracle.com/technetwork/java/javase/downloads/jdk8-downloads-2133151.html 下载之后 ...
- windows下大数据开发环境搭建(4)——Spark环境搭建
一.所需环境 · Java 8 · Python 2.6+ · Scala · Hadoop 2.7+ 二.Spark下载与解压 http://spark.apache.org/downloads.h ...
- windows下大数据开发环境搭建(3)——Scala环境搭建
一.所需环境 ·Java 8 二.下载Scala https://www.scala-lang.org/download/ 三.配置环境变量 SCALA_HOME: C:\scala Path: ...
- windows下大数据开发环境搭建(1)——Hadoop环境搭建
所需环境 jdk 8 Hadoop下载 http://hadoop.apache.org/releases.html 配置环境变量 HADOOP_HOME: C:\hadoop-2.7.7 Path: ...
- 大数据_zookeeper环境搭建中的几个坑
文章目录 [] Zookeeper简介 关于zk的介绍, zk的paxos算法, 网上已经有各位大神在写了, 本文主要写我在搭建过程中的几个极有可能遇到的坑. Zookeeper部署中的坑 坑之一 E ...
- 大数据学习之路-Centos6安装python3.5
Centos 6.8安装python3.5.2 因为学习所需,需要用到python3.x的环境,目前Linux系统默认的版本都是python2.x的,还有一些自带的工具需要用到python2.6版本, ...
- 大数据学习系列之四 ----- Hadoop+Hive环境搭建图文详解(单机)
引言 在大数据学习系列之一 ----- Hadoop环境搭建(单机) 成功的搭建了Hadoop的环境,在大数据学习系列之二 ----- HBase环境搭建(单机)成功搭建了HBase的环境以及相关使用 ...
随机推荐
- Python学习(三) —— 基本数据类型
基本数据类型 一.整数类型(int) 32位机器,整数的位数为32位,取值范围为-2**31~2**31-1,即-2147483648~2147483647 64位机器,整数的位数是64位,取值范围位 ...
- BZOJ4409 [Usaco2016 Feb]Circular barn 动态规划 斜率优化
原文链接http://www.cnblogs.com/zhouzhendong/p/8724739.html 题目传送门 - BZOJ4409 题意 有一个N个点的环,相邻两个点距离是1.点顺时针标号 ...
- HDU1814 Peaceful Commission 2-sat
原文链接http://www.cnblogs.com/zhouzhendong/p/8099115.html 题目传送门 - HDU1814 题面 Description 根据宪法,Byteland民 ...
- springmvc+ajax——第二讲(页面缓存)
springmvc+ajax+页面缓存(参考:https://www.cnblogs.com/liuling/archive/2013/07/25/2013-7-25-01.html) 必须设置响应头 ...
- 启动 ServiceFabric Windows服务报1053
Remote Procedure Call (RPC) Locator和 Windows Firewall是否启动. 以管理员身份运行PowerShell,输入Unregister-Scheduled ...
- kmp基础 ekmp
+]; int lenp,lens; +];//可以是char 也可以是string +]; void getnext() { nex[]=-; ,j=; ) { ||p[j]==p[k]) nex[ ...
- NP:建立可视化输入的二次函数数据点集np.linspace+np.random.shuffle+np.random.normal
import numpy as np import matplotlib.pyplot as plt def fix_seed(seed=1): #重复观看一样东西 # reproducible np ...
- Lua + win 10 + vs2017的运行环境和创建cocos2dx 3.17的lua项目(亲测)
转:https://blog.csdn.net/maoye198602102339/article/details/82047920 不管用什么引擎写游戏,脚本语言是少不了要接触的! 首先,我说的 ...
- 从小白到区块链工程师:第一阶段:Go语言的HelloWorld初始(2)
四.写下第一段Go语言代码“Hello World” 小建议:就是文件夹路径或者文件名称不要出现中文,可能会导致一些不必要的麻烦(编译失败) 在sublime中,我们在src文件夹上面,单击右键“Ne ...
- 大数据技术 - 分布式文件系统 HDFS 的设计
本章内容介绍下 Hadoop 自带的分布式文件系统,HDFS 即 Hadoop Distributed Filesystem.HDFS 能够存储超大文件,可以部署在廉价的服务器上,适合一次写入多次读取 ...