
146. LRU缓存机制
题目描述
运用你所掌握的数据结构,设计和实现一个LRU (最近最少使用) 缓存机制。它应该支持以下操作: 获取数据 get 和 写入数据 put 。
- 获取数据
get(key)- 如果密钥 (key) 存在于缓存中,则获取密钥的值(总是正数),否则返回 -1。 - 写入数据
put(key, value)- 如果密钥不存在,则写入其数据值。当缓存容量达到上限时,它应该在写入新数据之前删除最近最少使用的数据值,从而为新的数据值留出空间。
进阶:
你是否可以在 O(1) 时间复杂度内完成这两种操作?
示例:
LRUCache cache = new LRUCache( 2 /* 缓存容量 */ );

cache.put(1, 1);

cache.put(2, 2);

cache.get(1);       // 返回  1

cache.put(3, 3);    // 该操作会使得密钥 2 作废

cache.get(2);       // 返回 -1 (未找到)

cache.put(4, 4);    // 该操作会使得密钥 1 作废

cache.get(1);       // 返回 -1 (未找到)

cache.get(3);       // 返回  3

cache.get(4);       // 返回  4
算法
这题的时间复杂度的好坏比较依赖于所选择的数据结构。
LRU是操作系统中提出的一种应用于页置换的算法,这里不过多介绍,举个实际例子即可知道本题要求实现的功能需要什么步骤:
想象有一个队列的最大允许空间为3,

依次入队的顺序为 2,3,2,1,2,4;求LRU算法下队列的演变过程。

---------------------------------------------------

- 队列初始为空,2进入后队列情况为:2

- 队列还有2个剩余位置,3进入后队列情况为:2 3

- 队列还有1个剩余位置,这次入队的数据为2,它本来就已在队列中,根据LRU算法,需要将2调到队列末尾,因此队列情况为:3 2

- 队列还有1个剩余位置,这次入队数据为1,入队后队列情况为:2 3 1

- 队列已经没有剩余位置,但是入队数据为2,它本来就在队列中,根据LRU算法,需要将2调到队列末尾,因此队列情况为:3 1 2

- 队列已经没有剩余位置,新进入的数据为4,根据LRU需要淘汰最近最少被使用的数据,即队首的数据3,更新后队列情况为:1 2 4

---------------------------------------------------

上面即为LRU算法的一个例子
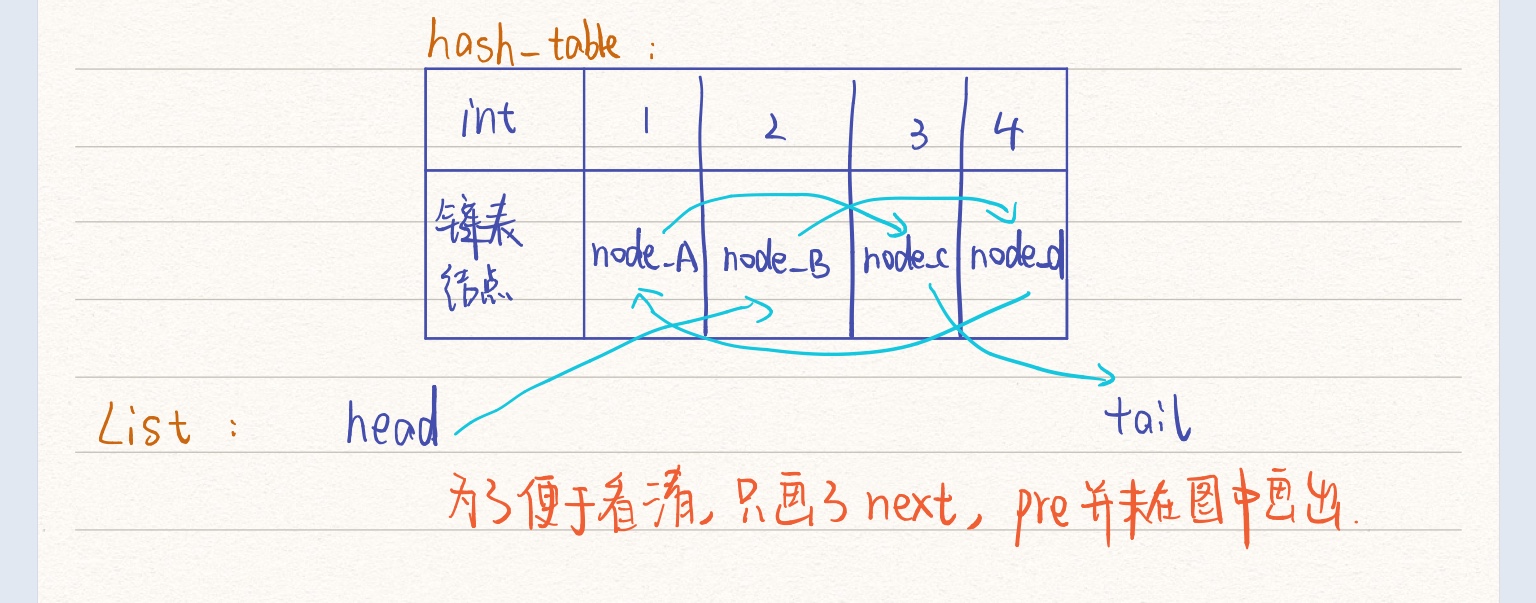
选择hash表与双向链表作为实现主体功能的两个数据结构,主要是因为双向链表便于插入删除,而hash表可以较快查找到需要返回的value。具体一点,整个LRUCache可能长下面这样:
代码
#include <iostream>

#include <list>

#include <unordered_map>

using namespace std;

struct listNode{

    int key, value;

    listNode *pre, *next;

    listNode(int _key, int _value): key(_key), value(_value)

    {

        pre = next = NULL;

    }

};

class LRUCache {

public:

    // hash_table末端保存最近刚被使用的节点,前端保存最近最少被使用节点

    unordered_map<int, listNode*> hash_table;

    listNode *head, *tail;

    int cap, size;

    LRUCache(int capacity) {

        cap = capacity;

        size = 0;

        head = new listNode(-1, -1);

        tail = new listNode(-1, -1);

        head->next = tail;

        tail->pre = head;

    }

    int get(int key) {

        if (hash_table.find(key) == hash_table.end())

            return -1;

        else

        {

            // 记录该ID指向节点的指针

            listNode *tmp = hash_table[key];

            /*** 更改节点在表中的顺序 ***/

            // 1. 删除hash_table[key]

            delNode(tmp);

            // 2. 将hash_table[key]插入末尾

            pushNodeBack(tmp);

            return tmp->value;

        }

    }

    void put(int key, int value) {

        // 这个key本身保存在表中

        if (hash_table.find(key) != hash_table.end())

        {

            listNode *tmp = hash_table[key];

            // 从链表头部去掉这个点

            delNode(tmp);

            // 更新表中key对应链表节点的value

            tmp->value = value;

            // 从链表尾部插入这个点

            pushNodeBack(tmp);

            return;

        }

        // 链表的空间已满

        if (cap == size)

        {

            // 空间不够,踢出队列最前端的ID

            listNode *tmp = head->next;

            // 在表中删除这个点

            hash_table.erase(tmp->key);

            // 从链表头部去掉这个点

            delNode(tmp);

            // 释放被删除的点的空间

            delete tmp;

        }

        else

            size++;

        listNode *node = new listNode(key, value);

        hash_table[key] = node;

        pushNodeBack(node);

    }

    void delNode(listNode *node)

    {

        node->pre->next = node->next;

        node->next->pre = node->pre;

    }

    void pushNodeBack(listNode *node)

    {

        tail->pre->next = node;

        node->pre = tail->pre;

        node->next = tail;

        tail->pre = node;

    }

};

int main()

{

    LRUCache *cache = new LRUCache(2);

    cache->put(1, 1);

    cache->put(2, 2);

    cout << cache->get(1) << endl;       // 返回  1

    cache->put(3, 3);                    // 该操作会使得密钥 2 作废

    cout << cache->get(2) << endl;       // 返回 -1 (未找到)

    cache->put(4, 4);                    // 该操作会使得密钥 1 作废

    cout << cache->get(1) << endl;       // 返回 -1

    cout << cache->get(3) << endl;       // 返回  3

    cout << cache->get(4) << endl;       // 返回  4

}
146. LRU缓存机制的更多相关文章
- Java实现 LeetCode 146 LRU缓存机制
146. LRU缓存机制 运用你所掌握的数据结构,设计和实现一个 LRU (最近最少使用) 缓存机制.它应该支持以下操作: 获取数据 get 和 写入数据 put . 获取数据 get(key) - ...
- 力扣 - 146. LRU缓存机制
目录 题目 思路 代码 复杂度分析 题目 146. LRU缓存机制 思路 利用双链表和HashMap来解题 看到链表题目,我们可以使用头尾结点可以更好进行链表操作和边界判断等 还需要使用size变量来 ...
- 146. LRU 缓存机制 + 哈希表 + 自定义双向链表
146. LRU 缓存机制 LeetCode-146 题目描述 题解分析 java代码 package com.walegarrett.interview; /** * @Author WaleGar ...
- 【golang必备算法】 Letecode 146. LRU 缓存机制
力扣链接:146. LRU 缓存机制 思路:哈希表 + 双向链表 为什么必须要用双向链表? 因为我们需要删除操作.删除一个节点不光要得到该节点本身的指针,也需要操作其前驱节点的指针,而双向链表才能支持 ...
- [Leetcode]146.LRU缓存机制
Leetcode难题,题目为: 运用你所掌握的数据结构,设计和实现一个 LRU (最近最少使用) 缓存机制.它应该支持以下操作: 获取数据 get 和 写入数据 put . 获取数据 get(key ...
- 【力扣】146. LRU缓存机制
运用你所掌握的数据结构,设计和实现一个 LRU (最近最少使用) 缓存机制.它应该支持以下操作: 获取数据 get 和 写入数据 put . 获取数据 get(key) - 如果关键字 (key) ...
- leetcode:146. LRU缓存机制
题目描述: 运用你所掌握的数据结构,设计和实现一个 LRU (最近最少使用) 缓存机制.它应该支持以下操作: 获取数据 get 和 写入数据 put . 获取数据 get(key) - 如果密钥 ( ...
- LeetCode 146. LRU缓存机制(LRU Cache)
题目描述 运用你所掌握的数据结构,设计和实现一个 LRU (最近最少使用) 缓存机制.它应该支持以下操作: 获取数据 get 和 写入数据 put . 获取数据 get(key) - 如果密钥 (k ...
- Leetcode 146. LRU 缓存机制
前言 缓存是一种提高数据读取性能的技术,在计算机中cpu和主内存之间读取数据存在差异,CPU和主内存之间有CPU缓存,而且在内存和硬盘有内存缓存.当主存容量远大于CPU缓存,或磁盘容量远大于主存时,哪 ...
随机推荐
- java多线程系列13 设计模式 Future 模式
Future 模式 类似于ajax请求 页面异步的进行后台请求 用户无需等待请求的结果 就可以继续浏览或者操作 核心就是:去除了主函数的等待时间,并使得原本需要等待的时间段可以用于处理其他业务逻辑 ...
- json字符转对象之new Function('return ' + str)
var jsonStr = '{"id":1,"name":"linda","hobbies":[{"id&q ...
- foreach退出循环(新人请多多关照~)
今天做一个关于人员信息修改的页面时,我用foreach获取数据库数据时发现,用if else判断输入的内容时,会一个一个的做对比,导致错误提醒时会弹出与数据库内容行数相同条的提醒,最后发现将数据直接命 ...
- GDB基础学习
GDB基础学习 要调试C/C++程序,首先在编译时,我们必须要把调试信息加到可执行文件中.使用编译器(cc/gcc/g++)的-g参数可以做到这一点,比如: gcc -g test.c -o test ...
- js-运动函数包
function move(obj, attr, dir, target, endFn) { clearInterval(obj.timer) // 避免全局变量,所以要用oBox.timer di ...
- git dev 分支merge到master
code reviewer之后,需要把dev分支的代码merge到master分支.通过在azkaban的服务器上git pull,最终将代码上线. git dev 分支merge到master # ...
- 有关C++模板inline的高性能在lambda与function的体现
前两天在群里跟人讨论到写库时对于lambda和function的取舍,跑了写测试查了些资料后基本得出结论: 如果没有自由变量的情况下,一般不要用function. 如果有自由变量的话,C++中的lam ...
- Hessian 使用例子
一.协议包(数据对象需要实现序列化接口,可以用于服务端接口.客户端调用服务之用) /** * */ package com.junge.demo.protocol.model; import java ...
- 学习在dos下使用gcc来编译
这两年里,断断续续的学习和使用c,平时都是在CodeBlocks里写代码,编译程序,点一下按钮就行了.对整个编译过程是一点儿都不了解.相比当年学习java,真的是选择了两个不同的路,当年学习java的 ...
- Flask 中的路由系统
基本用法 Django的路由系统url集中在一起,而Flask的路由系统以装饰器的形式装饰在视图上如: @app.route("/",methods=["GET" ...