
azkaban 执行hive语句
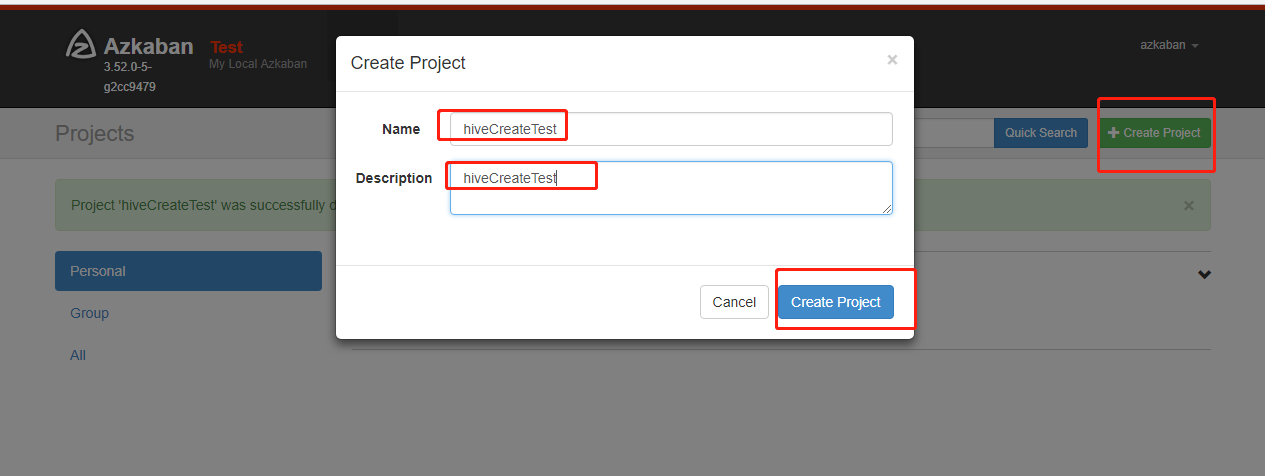
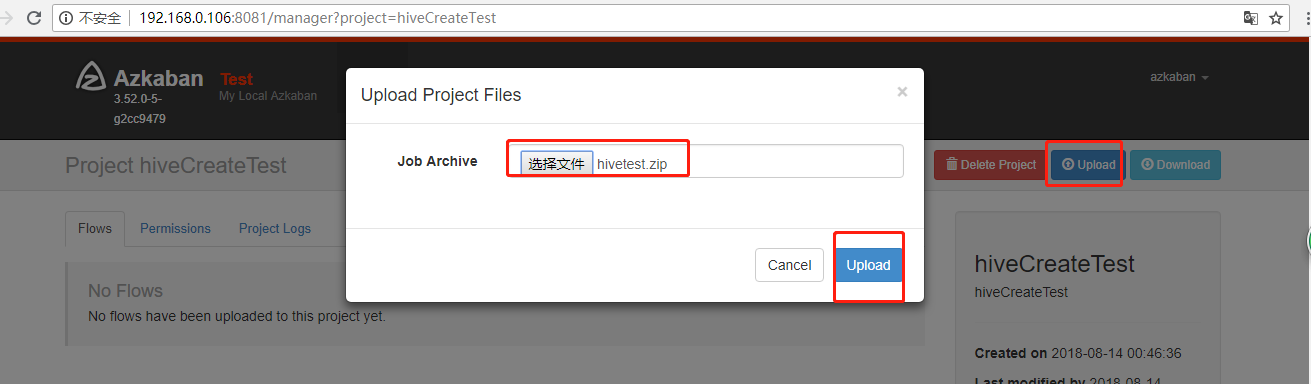
#hivef.job
type=command
command=hive -f test.sql
#test.sql
use default;
drop table aztest;
create table aztest(id int,name string) row format delimited fields terminated by ",";
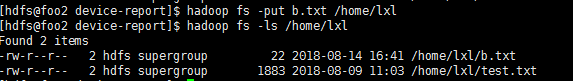
load data inpath '/home/lxl/b.txt' into table aztest;
create table azres as select * from aztest;







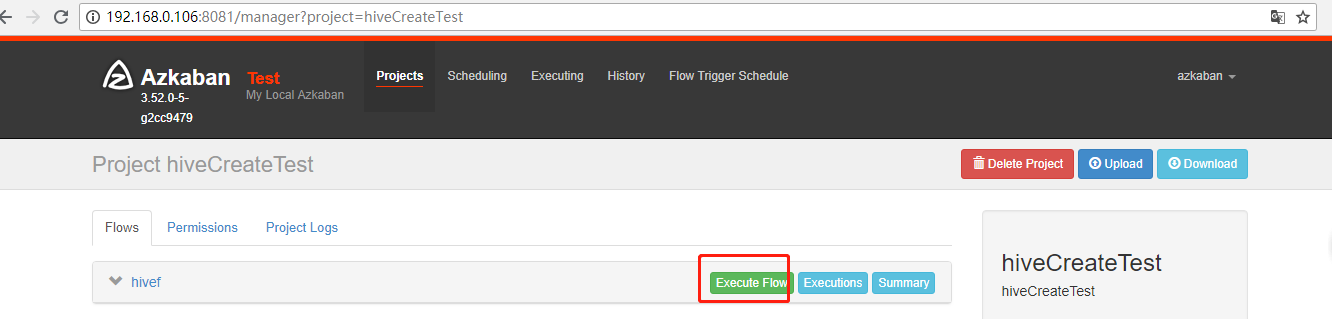

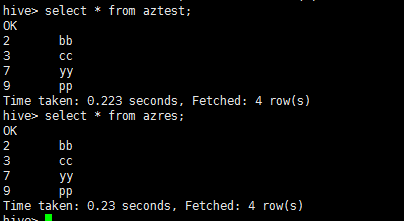
11.执行后显示如下:



#hivef.job
type=command
command=sudo -u hdfs hive -f test.sql
#test.sql
use default;
drop table aztest;
create table aztest(id int,name string) row format delimited fields terminated by ",";
load data inpath '/home/lxl/b.txt' into table aztest;
create table azres as select * from aztest;
azkaban 执行hive语句的更多相关文章
- 使用java连接hive,并执行hive语句详解
安装hadoop 和 hive我就不多说了,网上太多文章 自己看去 首先,在机器上打开hiveservice hive --service hiveserver -p 50000 & 打开50 ...
- 使用Hive或Impala执行SQL语句,对存储在HBase中的数据操作
CSSDesk body { background-color: #2574b0; } /*! zybuluo */ article,aside,details,figcaption,figure,f ...
- 使用Hive或Impala执行SQL语句,对存储在Elasticsearch中的数据操作(二)
CSSDesk body { background-color: #2574b0; } /*! zybuluo */ article,aside,details,figcaption,figure,f ...
- 使用Hive或Impala执行SQL语句,对存储在Elasticsearch中的数据操作
http://www.cnblogs.com/wgp13x/p/4934521.html 内容一样,样式好的版本. 使用Hive或Impala执行SQL语句,对存储在Elasticsearch中的数据 ...
- hive高阶1--sql和hive语句执行顺序、explain查看执行计划、group by生成MR
hive语句执行顺序 msyql语句执行顺序 代码写的顺序: select ... from... where.... group by... having... order by.. 或者 from ...
- Hadoop生态圈-Azkaban实现hive脚本执行
Hadoop生态圈-Azkaban实现hive脚本执行 作者:尹正杰 版权声明:原创作品,谢绝转载!否则将追究法律责任. 本篇博客中在HDFS分布式系统取的数据,而这个数据的是有之前我通过MapRed ...
- shell中执行hive命令错误:delimited by end-of-file (wanted `EOF')
错误信息: warning: here-document at line 58 delimited by end-of-file (wanted `EOF') 业务场景,使用hive对数据进行批量清洗 ...
- 通过学生-课程关系表,熟悉hive语句
通过学生-课程关系表,熟悉hive语句 1.在hive中创建以下三个表. create table student(Sno int,Sname string,Sex string,Sage int, ...
- 工作中常见的hive语句总结
hive的启动: 1.启动hadoop2.开启 metastore 在开启 hiveserver2服务nohup hive --service metastore >> log.out 2 ...
随机推荐
- opencv读取摄像头实时流代码
opencv读取摄像头实时流代码: #include <opencv2/opencv.hpp> #include <iostream> using namespace cv; ...
- SQL Analytic Functions 分析函数
应用场景 主要使用在需要分组计算的场景中,根据所需的计算值可以分为两类: 1,排序类:如排序号,相邻记录等 2,聚合类:如平均值,累加求和,最大值,最末值等 语法 分析函数的语法在各大数据库中基本类似 ...
- Restful架构学习
Restful规范的架构是一种简洁并且面向资源的规范方式,其概念和起源大家google一下就好. 以下记录认识和搭建Restful规范的技术架构过程(入门级别),在网上发现了一张技术架构图很接近最初想 ...
- Okhttp、Volley和Gson的简单介绍和配合使用
转载自:http://www.apkbus.com/home.php?mod=space&uid=784586&do=blog&id=61255 1.okhttp是一个高效的. ...
- 软件测试_Linux
# Linux## 基础知识### 操作系统* 作为中间人,连接软件和硬件### Linux * 特点 * 免费+安全### 查看日志,定位bug,修改文件,搭建环境## 安装### 装虚拟机 vmw ...
- SQL-视图-004
什么是视图? 优点:视图是保存在数据库中的SELECT查询,可以简化查询操作,视图可以从多个表中提取数据,并以单个表的形式显示结果,这样就可以针对多个表的查询转化为对一个表的查询. 映射:视图可以理解 ...
- Java BigInterger类
BigInteger概述 可以让超过Integer范围内的数据进行运算 构造方法 public BigInteger(String val) 成员方法 public BigInteger add(Bi ...
- redux进一步优化
1. 将原来的 mapStateToDispatch 中的函数提取出来,放在组件中, 如原来的: function mapStateToProps(state, ownProps) { retur ...
- 如何在myeclipse中实现jquery的自动提示功能
在web开发过程中,myeclipse中jsp可以实现自动提示功能,但是jquery代码却无法实现自动提示,需要自己一个个手动去输入,效率过低,怎么办? 工具/原料 jquery 1.8.3.js ...
- msvcp140.dll丢失解决方案
[首先给出99%情况下都能解决这个问题的最简单办法]: 下载并安装微软VC++2015版运行库 (英文全称:Microsoft Visual C++ 2015 Redistributable Pa ...