
elasticsearch(lucene)索引数据过程
倒排索引存储-分段存储(lucene的功能)
在lucene中:lucene index包含了若干个segment
在elasticsearch中:index包含了若干主从shard,shard包干了若干segment
segment是elasticsearch中存储的最小文件单元,也就是分段存储,segment被设计为不可变的
新增:新创建索引时,新建一个segment存储新的数据
删除:由于segment是只读的,所以在索引文件中新增了.del文件,专门存储被删除的数据id,当查询时被删除的数据仍能被查询,进行查询结果合并时才会过滤掉,merge segment时会真正删除
更新:新增和删除的组合
segment的不可变性的优点
- 不需要锁(没有直接修改已经存在段的情况)
- 可以利用内存,由于segment不可变,所以segment被加载到内存后无需改变,只要内存足够,segment就可以长期驻村,大大提升查询性能
- 更新、新增的增量的方式很轻,性能好
segment的不可变性的缺点
- 删除操作不会马上删除有一定的空间浪费
- 频繁更新涉及到大量的删除动作,会有大量的空间浪费
- segment的数量可能非常多,对服务器的文件句柄消耗很大,查询性能会随着segment的数量增加而增加
新增数据的过程
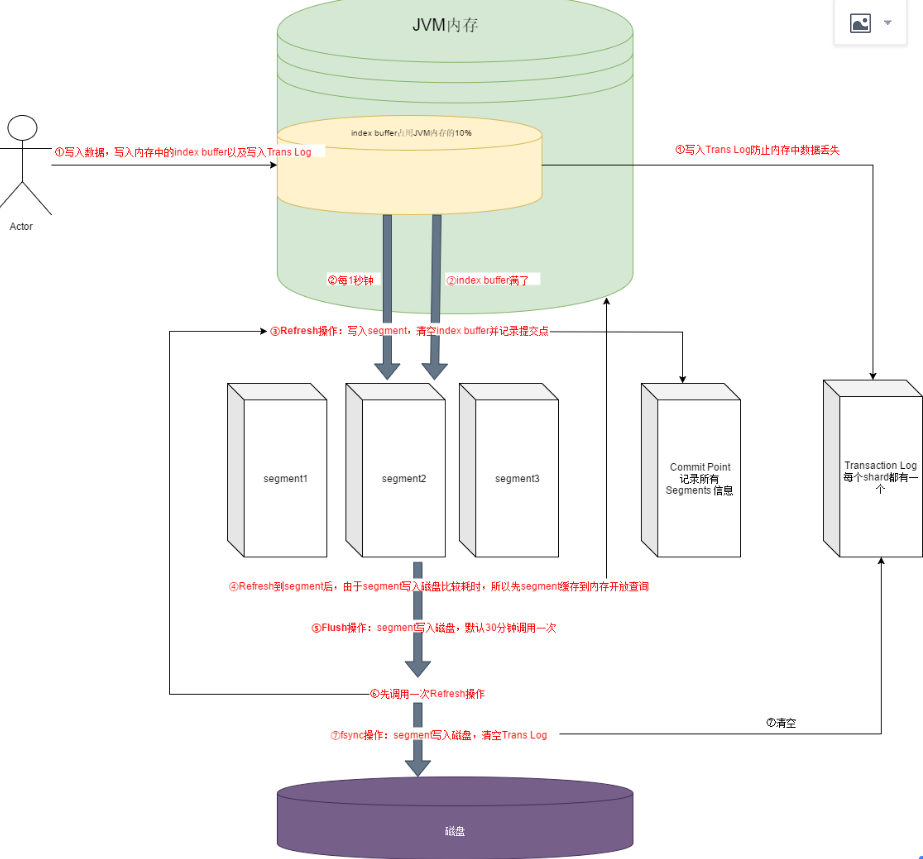
这个流程的目的是:提升写入性能(异步落盘)
1、保存到index buffer中,同时写入Transaction log(防止内存的数据丢失,有点想redo log)
2、当index buffer空间满了(默认占用jvm10%)或每1秒(通过index.refresh_interval 配置)执行Refresh操作,写入segment并清空index buffer(这里的1秒内是查不到刚保存的数据的,所以es也被成为近实时的搜索引擎)
3、于此同时将segment刷入内存,开放查询
4、flush操作将segment写入磁盘(默认30分钟执行一次)
flash操作包含:
- 调用一次refresh
- fsync:将segment写入磁盘
- 清空对应的trans log

elasticsearch(lucene)索引数据过程的更多相关文章
- ES 18 - (底层原理) Elasticsearch写入索引数据的过程 以及优化写入过程
目录 1 Lucene操作document的流程 1.1 添加document的流程 1.2 删除document的流程 2 优化写入流程 - 实现近实时搜索 2.1 流程的改进思路 2.2 设置re ...
- Heka–>Elasticsearch 索引数据过程的优化
Heka 的参数配置跟Elasticsearch的参数没有关系,Heka只负责按照配置发送数据,所以索引的优化主要在 Elaticsearch端来完成. 下面是Elasticsearch的一些相关概念 ...
- elasticsearch批量索引数据示例
示例数据文件document.json(index表示在索引中增加或替换现有文档,create表示如果文档不存在则添加文档,delete表示删除文档): { "index": { ...
- 使用Flink实现索引数据到Elasticsearch
使用Flink实现索引数据到Elasticsearch 2018-07-28 23:16:36 Yanjun 使用Flink处理数据时,可以基于Flink提供的批式处理(Batch Proce ...
- Lucene学习总结之四:Lucene索引过程分析
对于Lucene的索引过程,除了将词(Term)写入倒排表并最终写入Lucene的索引文件外,还包括分词(Analyzer)和合并段(merge segments)的过程,本次不包括这两部分,将在以后 ...
- Lucene学习总结之四:Lucene索引过程分析 2014-06-25 14:18 884人阅读 评论(0) 收藏
对于Lucene的索引过程,除了将词(Term)写入倒排表并最终写入Lucene的索引文件外,还包括分词(Analyzer)和合并段(merge segments)的过程,本次不包括这两部分,将在以后 ...
- Lucene学习笔记: 四,Lucene索引过程分析
对于Lucene的索引过程,除了将词(Term)写入倒排表并最终写入Lucene的索引文件外,还包括分词(Analyzer)和合并段(merge segments)的过程,本次不包括这两部分,将在以后 ...
- Elasticsearch Lucene 数据写入原理 | ES 核心篇
前言 最近 TL 分享了下 <Elasticsearch基础整理>https://www.jianshu.com/p/e8226138485d ,蹭着这个机会.写个小文巩固下,本文主要讲 ...
- 使用Lucene索引和检索POI数据
1.简介 关于空间数据搜索,以前写过<使用Solr进行空间搜索>这篇文章,是基于Solr的GIS数据的索引和检索. Solr和ElasticSearch这两者都是基于Lucene实现的,两 ...
随机推荐
- 【t098】符文之语
Time Limit: 1 second Memory Limit: 128 MB [问题描述] 当小FF来到神庙时,神庙已经破败不堪了.但神庙的中央有一个光亮如新的石台.小FF走进石台, 发现石台上 ...
- dotnet 方法名 To 和 As 有什么不同
在看到 dotnet 框架里面有很多方法里面用了 ToXx 和 AsXx 好像都是从某个类转换为另一个类,那么这两个方法命名有什么不同 在约定的方法命名里面,用 To 的方法表示从类 A 转为类 B ...
- 2019-5-31-SharpDx-进入全屏模式
title author date CreateTime categories SharpDx 进入全屏模式 lindexi 2019-5-31 9:5:36 +0800 2019-5-30 20:1 ...
- selenium经过WebDriverWait实现ajax测试
当前位置:我的异常网» Web前端 » selenium经过WebDriverWait实现ajax测试 selenium经过WebDriverWait实现ajax测试 www.MyException. ...
- sed工具
SED是一个非交互式文本编辑器,它可对文本文件和标准输入进行编辑,标准输入可以来自键盘输入.文本重定向.字符串.变量,甚至来自于管道的文本,与VIM编辑器类似,它一次处理一行内容,Sed可以编辑一个或 ...
- Android多媒体框架
Android系统的多媒体架构图 OpenMax做编解码作用(codec),从上到下依次是AL(应用层,在多媒体中间件和应用程序之间提供一个标准化接口).IL(集成层,解码编码器).DL(开发层,供应 ...
- slim中的参数获取
官方文档中对于get和post的参数有以下获取方式 $app->get('/', function (Request $req, Response $res, $args = []) { $my ...
- hadoop fs、hadoop dfs与hdfs dfs命令的区别
Hadoop fs:使用面最广,可以操作任何文件系统. hadoop dfs与hdfs dfs:只能操作HDFS文件系统相关(包括与Local FS间的操作),前者已经Deprecated,一般使用后 ...
- 使用原生JDBC方式对数据库进行操作
使用原生JDBC方式对数据库进行操作,包括六个步骤: 1.加载JDBC驱动程序 在连接数据库之前,首先要加载想要连接的数据库的驱动到JVM.可以通过java.lang.Class类的静态方法forNa ...
- 别怕,"卷积"其实很简单(下)
文章来自我的CSDN同名博客,欢迎文末扫码关注~ 定义 基于上一篇文章的通俗化例子,我们从基本概念上了解了卷积,那么更严格的定义是怎样的呢? 从数学上讲,卷积只不过是一种运算,对于很多没有 ...