
b 解题报告
本题已收录至2019/9/15 本周总结
题目
【问题描述】
Hja有一棵\(n\)个点的树,树上每个点有点权,每条边有颜色.一条路径的权值是这条路径上所有点的点权和,一条合法的路径需要满足该路径上任意相邻的两条边颜色都不相同.问这棵树上所有合法路径的权值和是多少.
【输入格式】
第一行一个数\(n\).
接下来一行\(n\)个数代表每个点的权值.
接下来\(n-1\)行每行三个整数\(u\ v\ c\),代表\(u\)到\(v\)之间有一条颜色为\(c\)的边。
【输出格式】
一行一个整数代表答案.
【样例输入】
6

6 2 3 7 1 4

1 2 1

1 3 2

1 4 3

2 5 1

2 6 2
【样例输出】
134
【数据范围与规定】
\(1\le n \le 3\times 10^5,1\le c \le 10^9\)
保证答案小于\(2^{63}-1\).
思路1 \(O(n^2)\)暴力
从每个点DFS一次,计算出以该点为端点的所有合法路径的权值和.每条链被计算了两次,因此答案要\(/2\).
时间复杂度\(O(n^2)\)
#include<bits/stdc++.h>

#define LL long long

const int SIZE=300005;

int n,head[SIZE],nex[SIZE*2],to[SIZE*2],edge[SIZE*2],Tot;

LL weight[SIZE],Ans;

void Link(int u,int v,int e)

{

	nex[++Tot]=head[u];head[u]=Tot;to[Tot]=v;edge[Tot]=e;

	nex[++Tot]=head[v];head[v]=Tot;to[Tot]=u;edge[Tot]=e;

}

void DFS(int u,int F,LL sum,int Las)

{

	Ans+=sum;

	for(int i=head[u];i;i=nex[i])

	{

		int v=to[i];

		if(v==F||edge[i]==Las)continue;//不能出现连续两条颜色相同的边

		DFS(v,u,sum+weight[v],edge[i]);

	}

}

int main()

{

	int u,v,e;

	scanf("%d",&n);

	for(int i=1;i<=n;i++)

	{

		scanf("%lld",&weight[i]);

		Ans-=weight[i];

	}

	for(int i=1;i<n;i++)

	{

		scanf("%d%d%d",&u,&v,&e);

		Link(u,v,e);

	}

	for(int i=1;i<=n;i++)DFS(i,0,weight[i],0);

	printf("%lld",Ans/2);

	return 0;

}
思路2 \(O(n^2)\)记忆化搜索
容易发现,思路1的搜索有大量的重复状态.
举个例子,

现在我们从涂黑的点开始搜索,在粉框里搜出来了4种状态,列举在了右边.
需要注意的是,有一种状态(粉框左下角的连续两条蓝边)是不合法的,我们没有保留这种状态.
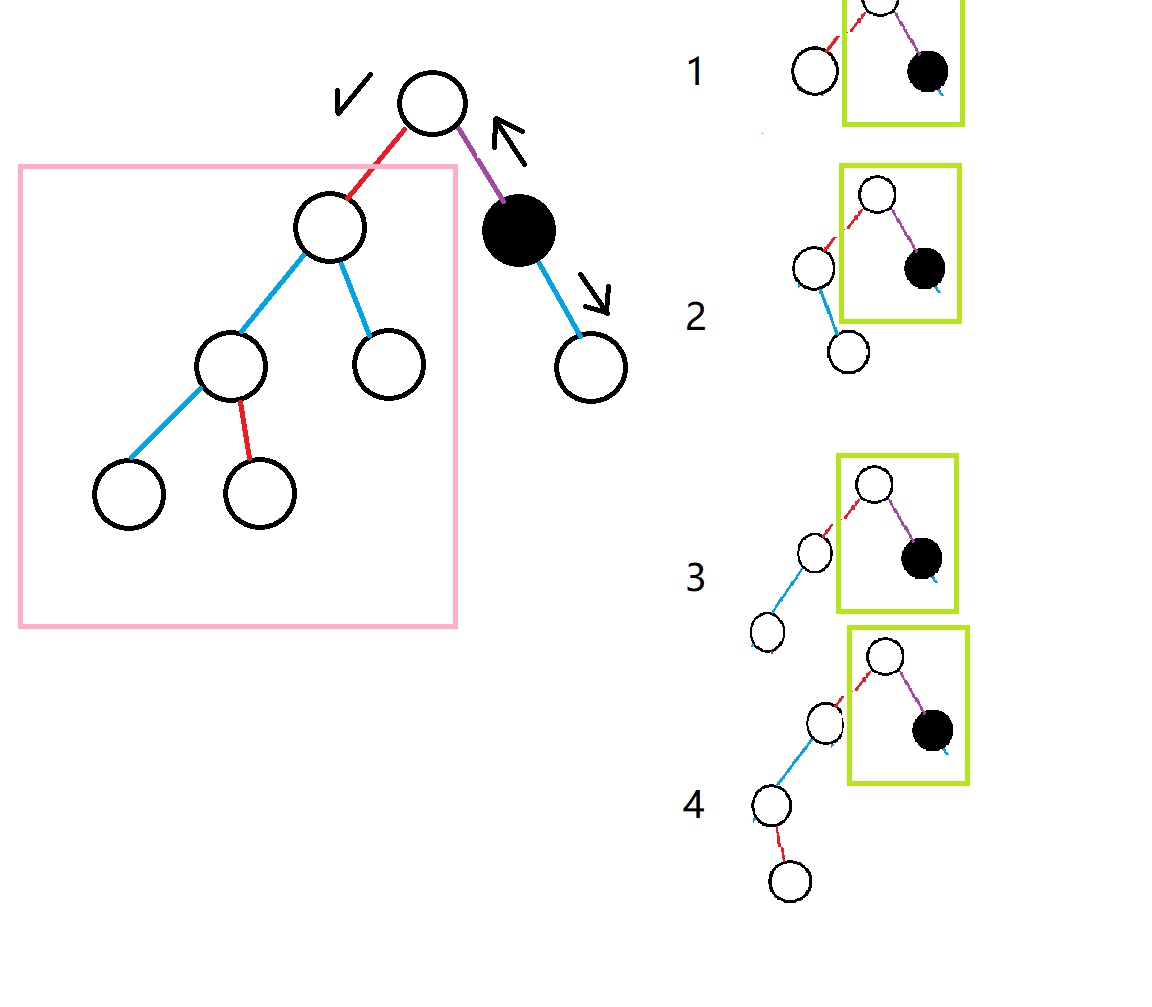
现在我们换第二个点进行DFS,就拿上图中涂黑的点来举例吧.
从这个点开始搜索,依然会进入粉框,在粉框中依然会搜出这4种状态,列举在了右边.
容易发现,这4种状态和上一个点的状态基本一样,只有绿框中的不一样.
换句话说,这4种状态在粉框中的部分是一样的.
这启示我们把粉框里搜出来的状态存起来,下次直接调用,不再在粉框内部进行DFS.
也就是这样:
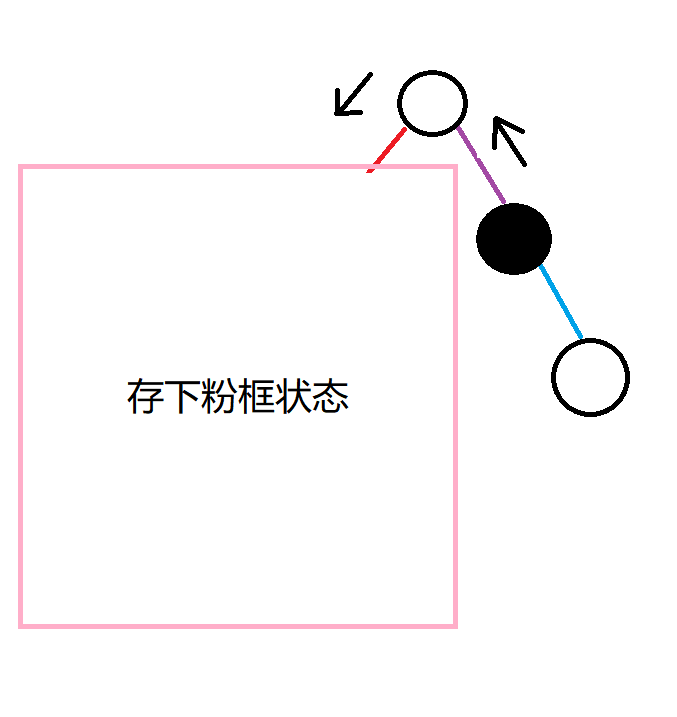
当我们在搜涂黑的点时,不用进入粉框搜索了,直接取出粉框的状态,加入答案.
容易发现,状态应该存储在(有向)边上,而且这样的记忆化可以推广到所有边.
于是我们就得到了记忆化搜索的代码.
#include<bits/stdc++.h>

#define LL long long

const int SIZE=600005;

int n,head[SIZE],nex[SIZE],to[SIZE],edge[SIZE],Tot;

LL weight[SIZE],Ans;

void Link(int u,int v,int e)

{

	nex[++Tot]=head[u];head[u]=Tot;to[Tot]=v;edge[Tot]=e;

	nex[++Tot]=head[v];head[v]=Tot;to[Tot]=u;edge[Tot]=e;

}

struct Re

{

	LL Res;

	int w;

	Re operator +(const Re &o)const

	{

		return (Re){Res+o.Res,w+o.w};

	}

}x[SIZE];

Re DFS(int u,int F,LL sum,int Las)

{

	Re R=(Re){sum,1};

	for(int i=head[u];i;i=nex[i])

	{

		int v=to[i];

		if(v==F||edge[i]==Las)continue;

		if(x[i].w)R=(Re){R.Res+x[i].w*sum+x[i].Res,R.w+x[i].w};

		else

		{

			Re Tem=DFS(v,u,sum+weight[v],edge[i]);

			R=R+Tem;

			x[i]=(Re){Tem.Res-sum*Tem.w,Tem.w};

		}

	}

	return R;

}

int main()

{

	int u,v,e;

	scanf("%d",&n);

	for(int i=1;i<=n;i++)

	{

		scanf("%lld",&weight[i]);

		Ans-=weight[i];

	}

	for(int i=1;i<n;i++)

	{

		scanf("%d%d%d",&u,&v,&e);

		Link(u,v,e);

	}

	for(int i=1;i<=n;i++)

		Ans+=DFS(i,0,weight[i],0).Res;

	printf("%lld",Ans/2);

	return 0;

}
容易证明:
一条链的情况时间复杂度\(O(n)\).
随机数据时间复杂度近似\(O(n)\).
菊花图时间复杂度\(O(n^2)\)
证明略.
思路3 记忆化搜索的优化
刚刚睡觉的时候想到可以对点也记忆化,但是这样要用map,时间复杂度\(O(nlogn)\).
#include<bits/stdc++.h>

#define LL long long

const int SIZE=600005;

int n,head[SIZE],nex[SIZE],to[SIZE],edge[SIZE],Tot;

LL weight[SIZE],Ans;

void Link(int u,int v,int e)

{

    nex[++Tot]=head[u];head[u]=Tot;to[Tot]=v;edge[Tot]=e;

    nex[++Tot]=head[v];head[v]=Tot;to[Tot]=u;edge[Tot]=e;

}

struct Re

{

    LL Res;int w;

    Re operator +(const Re &o)const{return (Re){Res+o.Res,w+o.w};}

    Re operator -(const Re &o)const{return (Re){Res-o.Res,w-o.w};}

}x[SIZE],mk[SIZE];

std::map<std::pair<int,int>,Re>mp;

bool Finished[SIZE];

Re DFS(int u,int F,LL sum,int Las)

{

    Re R=(Re){sum,1};

    if(Finished[u])

    {

    	Re Tem=mk[u]-mp[std::make_pair(u,Las)];

		R=(Re){R.Res+Tem.w*sum+Tem.Res,R.w+Tem.w};

		return R;

	}

    for(int i=head[u];i;i=nex[i])

    {

        int v=to[i];

        if(v==F){if(x[i].w)Finished[u]=1;continue;}

        if(x[i].w)

		{

			if(edge[i]!=Las)R=(Re){R.Res+x[i].w*sum+x[i].Res,R.w+x[i].w};

			continue;

		}

        Re Tem=DFS(v,u,sum+weight[v],edge[i]);

        if(edge[i]!=Las)R=R+Tem;

        x[i]=(Re){Tem.Res-sum*Tem.w,Tem.w};

        mp[std::make_pair(u,edge[i])]=mp[std::make_pair(u,edge[i])]+x[i];

        mk[u]=mk[u]+x[i];

    }

    return R;

}

int main()

{

    int u,v,e;

    scanf("%d",&n);

    for(int i=1;i<=n;++i){scanf("%lld",&weight[i]);Ans-=weight[i];}

    for(int i=1;i<n;++i){scanf("%d%d%d",&u,&v,&e);Link(u,v,e);}

    for(int i=1;i<=n;++i)Ans+=DFS(i,0,weight[i],0).Res;

    printf("%lld",Ans/2);

    return 0;

}
b 解题报告的更多相关文章
- CH Round #56 - 国庆节欢乐赛解题报告
最近CH上的比赛很多,在此会全部写出解题报告,与大家交流一下解题方法与技巧. T1 魔幻森林 描述 Cortana来到了一片魔幻森林,这片森林可以被视作一个N*M的矩阵,矩阵中的每个位置上都长着一棵树 ...
- 二模13day1解题报告
二模13day1解题报告 T1.发射站(station) N个发射站,每个发射站有高度hi,发射信号强度vi,每个发射站的信号只会被左和右第一个比他高的收到.现在求收到信号最强的发射站. 我用了时间复 ...
- BZOJ 1051 最受欢迎的牛 解题报告
题目直接摆在这里! 1051: [HAOI2006]受欢迎的牛 Time Limit: 10 Sec Memory Limit: 162 MBSubmit: 4438 Solved: 2353[S ...
- 习题:codevs 2822 爱在心中 解题报告
这次的解题报告是有关tarjan算法的一道思维量比较大的题目(真的是原创文章,希望管理员不要再把文章移出首页). 这道题蒟蒻以前做过,但是今天由于要复习tarjan算法,于是就看到codevs分类强联 ...
- 习题:codevs 1035 火车停留解题报告
本蒟蒻又来写解题报告了.这次的题目是codevs 1035 火车停留. 题目大意就是给m个火车的到达时间.停留时间和车载货物的价值,车站有n个车道,而火车停留一次车站就会从车载货物价值中获得1%的利润 ...
- 习题: codevs 2492 上帝造题的七分钟2 解题报告
这道题是受到大犇MagHSK的启发我才得以想出来的,蒟蒻觉得自己的代码跟MagHSK大犇的代码完全比不上,所以这里蒟蒻就套用了MagHSK大犇的代码(大家可以关注下我的博客,友情链接就是大犇MagHS ...
- 习题:codevs 1519 过路费 解题报告
今天拿了这道题目练练手,感觉自己代码能力又增强了不少: 我的思路跟别人可能不一样. 首先我们很容易就能看出,我们需要的边就是最小生成树算法kruskal算法求出来的边,其余的边都可以删掉,于是就有了这 ...
- NOIP2016提高组解题报告
NOIP2016提高组解题报告 更正:NOIP day1 T2天天爱跑步 解题思路见代码. NOIP2016代码整合
- LeetCode 解题报告索引
最近在准备找工作的算法题,刷刷LeetCode,以下是我的解题报告索引,每一题几乎都有详细的说明,供各位码农参考.根据我自己做的进度持续更新中...... ...
- ACM: Just a Hook 解题报告 -线段树
E - Just a Hook Time Limit:2000MS Memory Limit:32768KB 64bit IO Format:%I64d & %I64u D ...
随机推荐
- processing data
获取有效数据 Scikit-learn will not accept categorical features by default API里面不知使用默认的特征变量名,因此需要编码 这里我还是有疑 ...
- uva1428树状数组
用树状数组统计每个点i,左边与右边与多少个点小于a[i],然后用乘法原理和加法原理得出答案 #pragma GCC optimize(2) #include <bits/stdc++.h> ...
- WeUI基础样式库——写一个移动端界面
WeUI是一套基础样式库,同微信原生视觉体验一致,由微信官方设计团队为微信内网页和微信小程序量身设计的.我们来看看这个基础库样式到底长什么样. 这些密密麻麻的就是压缩后的样式库.密密麻麻地看起来简直要 ...
- idea 2018.1.2激活方法,有效期至2099年
1. 下载破解补丁文件JetbrainsCrack-2.7-release-str.jar 链接: https://pan.baidu.com/s/1inWaS067RPte3ZkD6uDxOQ 密码 ...
- 自主开发编程语言被指Python套壳,中科院开发者道歉
中科院计算所团队“完全自主设计.开发和实现”的“木兰”编程语言是Python语言的套壳产品?针对近日这一网络质疑,1月17日,项目负责人.中科院计算所编译实验室员工刘雷在科学网上发表回应称,木兰语言在 ...
- 【vue 权威指南】 学习笔记 二
1.指令 1.1内部指令 基础指令:v-show , v-else , v-model , v-repeat , v-for , v-text , v-el , v-html , v-on , v-b ...
- 图灵,咕泡,鲁班学院--Java高级架构师-互联网企业级实战VIP课程(价值6380)
课程介绍: 讲课内容涉及Java互联网技术工程框架.应用框架. 性能调优 (Tomcat Nginx JVM) 分布式框架(并发编程 Zookeeper N ...
- Codeforces Round #350 (Div. 2)(670C)
今天对着算法进阶指南,学了一下离散化.大概对桶排这样的算法优化比较好吧. 离散化:就是把无穷大的集合中若干个元素映射为有限集合以便于统计的方法.例如在很多时候,问题范围定义为整数集合Z,但涉及的元素只 ...
- shell-快速抽样
有时我们需要对文件进行抽样,这时候只需要一个shell命令就可以抽取固定行数的样本:shuf shuf -n $m $file 参数有2: -n: 抽样行数 -r: 是否重复
- go-web 获取get/post请求中的请求头和表单数据
package main import ( "fmt" "net/http" ) func handler(w http.ResponseWriter, r * ...