
Spark调优(二) 数据本地化
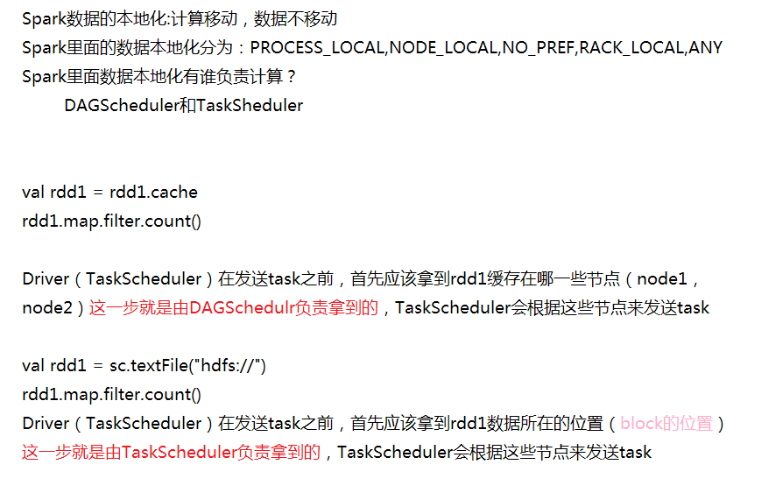
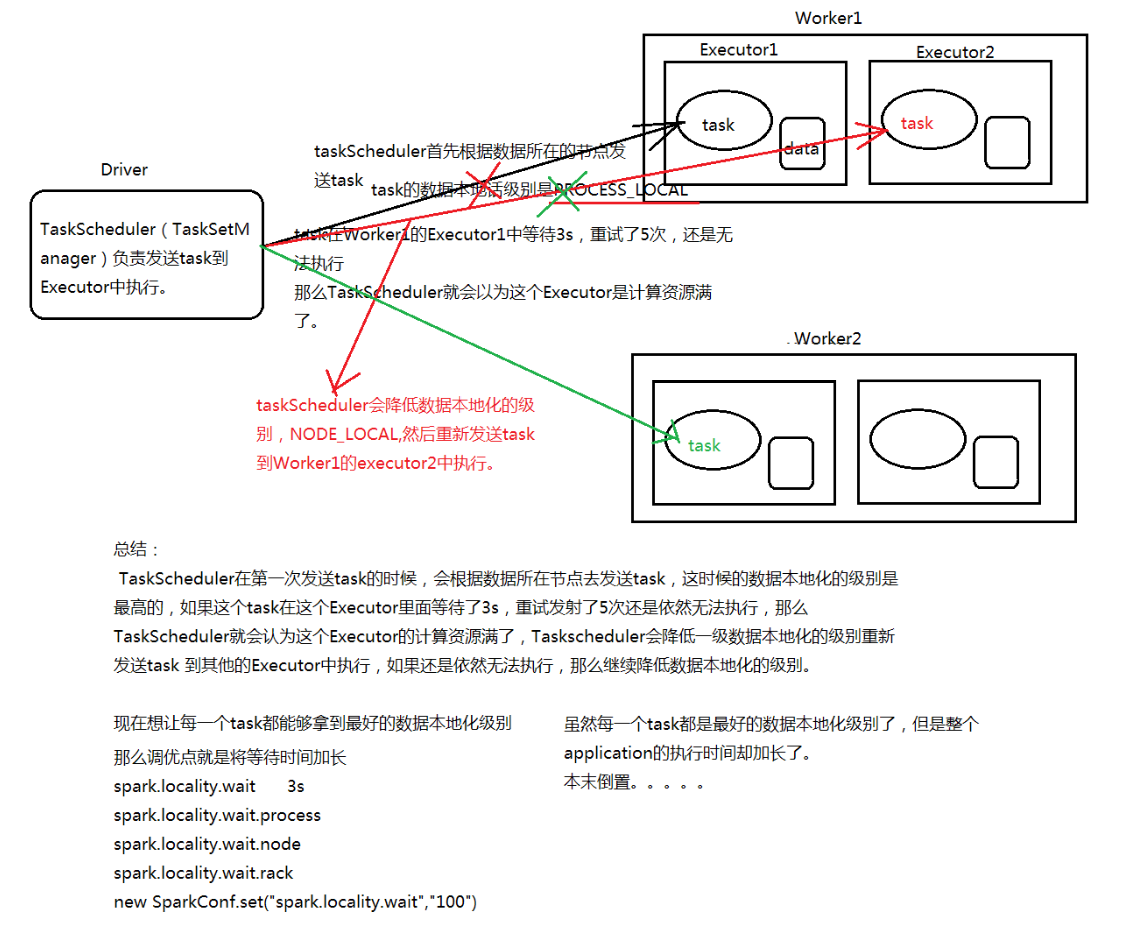
Application任务执行流程: 在Spark Application提交后,Driver会根据action算子划分成一个个的job,然后对每一 个job划分成一个个的stage,stage内部实际上是由一系列并行计算的task组成的,然后 以TaskSet的形式提交给你TaskScheduler,TaskScheduler在进行分配之前都会计算出 每一个task最优计算位置。Spark的task的分配算法优先将task发布到数据所在的节点上 ,从而达到数据最优计算位置。
一、数据本地化级别:
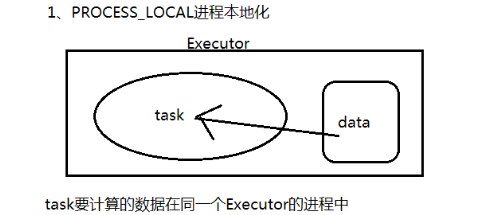
PROCESS_LOCAL 进程本地化
NODE_LOCA 节点本地化

NO_PREF 没有最佳位置这个说法 比如用到SparkSQl读取mysql数据库里的数据
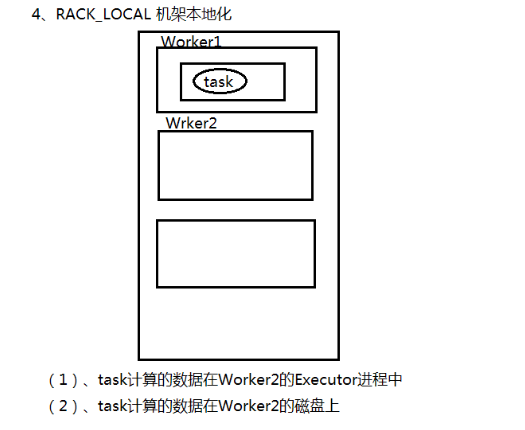
RACK_LOCAL 机架本地化
ANY 随机安排 跨机架
二、实际场景:
三、总结:
Spark调优(二) 数据本地化的更多相关文章
- 【Spark调优】数据本地化与参数调优
数据本地化对于Spark Job性能有着巨大的影响,如果数据以及要计算它的代码是在一起的,那么性能当然会非常高.但是,如果数据和计算它的代码是分开的,那么其中之一必须到另外一方的机器上.移动代码到其匹 ...
- 【Spark篇】---Spark调优之代码调优,数据本地化调优,内存调优,SparkShuffle调优,Executor的堆外内存调优
一.前述 Spark中调优大致分为以下几种 ,代码调优,数据本地化,内存调优,SparkShuffle调优,调节Executor的堆外内存. 二.具体 1.代码调优 1.避免创建重复的RDD,尽 ...
- 【Spark调优】数据倾斜及排查
[数据倾斜及调优概述] 大数据分布式计算中一个常见的棘手问题——数据倾斜: 在进行shuffle的时候,必须将各个节点上相同的key拉取到某个节点上的一个task来进行处理,比如按照key进行聚合或j ...
- spark调优篇-数据倾斜(汇总)
数据倾斜 为什么会数据倾斜 spark 中的数据倾斜并不是说原始数据存在倾斜,原始数据都是一个一个的 block,大小都一样,不存在数据倾斜: 而是指 shuffle 过程中产生的数据倾斜,由于不同的 ...
- Spark 调优之数据倾斜
什么是数据倾斜? Spark 的计算抽象如下 数据倾斜指的是:并行处理的数据集中,某一部分(如 Spark 或 Kafka 的一个 Partition)的数据显著多于其它部分,从而使得该部分的处理速度 ...
- 【Spark调优】Broadcast广播变量
[业务场景] 在Spark的统计开发过程中,肯定会遇到类似小维表join大业务表的场景,或者需要在算子函数中使用外部变量的场景(尤其是大变量,比如100M以上的大集合),那么此时应该使用Spark的广 ...
- 【Spark调优】大表join大表,少数key导致数据倾斜解决方案
[使用场景] 两个RDD进行join的时候,如果数据量都比较大,那么此时可以sample看下两个RDD中的key分布情况.如果出现数据倾斜,是因为其中某一个RDD中的少数几个key的数据量过大,而另一 ...
- 【Spark调优】小表join大表数据倾斜解决方案
[使用场景] 对RDD使用join类操作,或者是在Spark SQL中使用join语句时,而且join操作中的一个RDD或表的数据量比较小(例如几百MB或者1~2GB),比较适用此方案. [解决方案] ...
- Spark调优_性能调优(一)
总结一下spark的调优方案--性能调优: 一.调节并行度 1.性能上的调优主要注重一下几点: Excutor的数量 每个Excutor所分配的CPU的数量 每个Excutor所能分配的内存量 Dri ...
- 【Spark学习】Apache Spark调优
Spark版本:1.1.0 本文系以开源中国社区的译文为基础,结合官方文档翻译修订而来,转载请注明以下链接: http://www.cnblogs.com/zhangningbo/p/4117981. ...
随机推荐
- JSON 解析中遇到的坑😭
最近做加解密遇到一个很“奇葩的问题”,解析服务端加密后的字符串 序列化 时一直报错 "json解析失败:Error Domain=NSCocoaErrorDomain Code=3840 & ...
- python3 linux
记录了Linux 安装python3.7.0的详细过程,供大家参考,具体内容如下 我这里使用的时centos7-mini,centos系统本身默认安装有python2.x,版本x根据不同版本系统有所不 ...
- 同一台服务器lnmpa环境下配置ip或域名访问不同站点
1.配置域名访问 (1)添加虚拟主机 (2)nginx配置 cd /usr/local/nginx/conf/vhost vim zkadmin.zouke.com.conf (3)apache配置 ...
- selenium webdriver 常用方法
/** * 判断元素是否存在 * * @param driver * @param by * @return */ public static boolean isElementPresent(Web ...
- 吴裕雄 Bootstrap 前端框架开发——Bootstrap 排版:设定文本居中对齐
<!DOCTYPE html> <html> <head> <title>菜鸟教程(runoob.com)</title> <meta ...
- 外部IC寄存器的位定义
宏定义法:直接就是常量操作 方法1:用#define来定义,方便省事,缺点:系统不做检查 方法2:用enum来定义,可以像#define一样定义常量,同时系统做检查.既可以定义某个位也可以定义几个位的 ...
- Educational Codeforces Round 73 (Rated for Div. 2)D(DP,思维)
#define HAVE_STRUCT_TIMESPEC#include<bits/stdc++.h>using namespace std;long long a[300007],b[3 ...
- 【PAT甲级】1034 Head of a Gang (30 分)
题意: 输入两个正整数N和K(<=1000),接下来输入N行数据,每行包括两个人由三个大写字母组成的ID,以及两人通话的时间.输出团伙的个数(相互间通过电话的人数>=3),以及按照字典序输 ...
- 敏捷团队协作:Confluence简易教程
0.Confluence简介 Confluence是一个企业级的Wiki软件,可用于在企业.部门.团队内部进行信息共享和协同编辑. 1.基础概念 Confluence的使用并不复杂,只需掌握如下几 ...
- Hexo引入Mermaid流程图和MathJax数学公式
近来用Markdown写文章,越来越不喜欢插入图片了,一切能用语法解决的问题坚决不放图,原因有二: 如果把流程图和数学公式都以图片方式放到文章内,当部署到Github上后,访问博客时图片加载实在太慢, ...