
spark集群使用hanlp进行分布式分词操作说明
本篇分享一个使用hanlp分词的操作小案例,即在spark集群中使用hanlp完成分布式分词的操作,文章整理自【qq_33872191】的博客,感谢分享!以下为全文:
分两步:
第一步:实现hankcs.hanlp/corpus.io.IIOAdapter
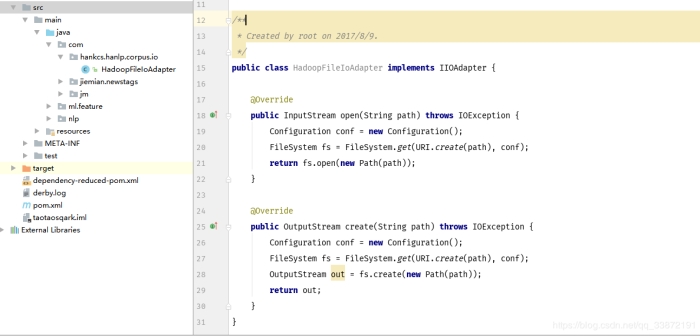
1.public class HadoopFileIoAdapter implements IIOAdapter {
2.
3. @Override
4. public InputStream open(String path) throws IOException {
5. Configuration conf = new Configuration();
6. FileSystem fs = FileSystem.get(URI.create(path), conf);
7. return fs.open(new Path(path));
8. }
9.
10. @Override
11. public OutputStream create(String path) throws IOException {
12. Configuration conf = new Configuration();
13. FileSystem fs = FileSystem.get(URI.create(path), conf);
14. OutputStream out = fs.create(new Path(path));
15. return out;
16. }
17. }
第二步:修改配置文件。root为hdfs上的数据包,把IOAdapter改为咱们上面实现的类

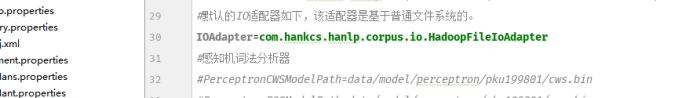
ok,这样你就能在分布式集群上使用hanlp进行分词了。
整个步骤比较简单,欢迎各位大神交流探讨!
spark集群使用hanlp进行分布式分词操作说明的更多相关文章
- 大数据学习day18----第三阶段spark01--------0.前言(分布式运算框架的核心思想,MR与Spark的比较,spark可以怎么运行,spark提交到spark集群的方式)1. spark(standalone模式)的安装 2. Spark各个角色的功能 3.SparkShell的使用,spark编程入门(wordcount案例)
0.前言 0.1 分布式运算框架的核心思想(此处以MR运行在yarn上为例) 提交job时,resourcemanager(图中写成了master)会根据数据的量以及工作的复杂度,解析工作量,从而 ...
- zhihu spark集群,书籍,论文
spark集群中的节点可以只处理自身独立数据库里的数据,然后汇总吗? 修改 我将spark搭建在两台机器上,其中一台既是master又是slave,另一台是slave,两台机器上均装有独立的mongo ...
- Spark集群 + Akka + Kafka + Scala 开发(3) : 开发一个Akka + Spark的应用
前言 在Spark集群 + Akka + Kafka + Scala 开发(1) : 配置开发环境中,我们已经部署好了一个Spark的开发环境. 在Spark集群 + Akka + Kafka + S ...
- 实验室中搭建Spark集群和PyCUDA开发环境
1.安装CUDA 1.1安装前工作 1.1.1选取实验器材 实验中的每台计算机均装有双系统.选择其中一台计算机作为master节点,配置有GeForce GTX 650显卡,拥有384个CUDA核心. ...
- 如果Apache Spark集群中没有分布式系统,则会?
若当连接到Spark的master之后,若集群中没有分布式文件系统,Spark会在集群中每一台机器上加载数据,所以要确保Spark集群中每个节点上都有完整数据. 通常可以选择把数据放到HDFS.S3或 ...
- 使用docker安装部署Spark集群来训练CNN(含Python实例)
使用docker安装部署Spark集群来训练CNN(含Python实例) http://blog.csdn.net/cyh_24/article/details/49683221 实验室有4台神服务器 ...
- Spark集群搭建简配+它到底有多快?【单挑纯C/CPP/HADOOP】
最近耳闻Spark风生水起,这两天利用休息时间研究了一下,果然还是给人不少惊喜.可惜,笔者不善JAVA,只有PYTHON和SCALA接口.花了不少时间从零开始认识PYTHON和SCALA,不少时间答了 ...
- spark集群搭建整理之解决亿级人群标签问题
最近在做一个人群标签的项目,也就是根据客户的一些交易行为自动给客户打标签,而这些标签更有利于我们做商品推荐,目前打上标签的数据已达5亿+, 用户量大概1亿+,项目需求就是根据各种组合条件寻找标签和人群 ...
- 大数据技术之_19_Spark学习_01_Spark 基础解析 + Spark 概述 + Spark 集群安装 + 执行 Spark 程序
第1章 Spark 概述1.1 什么是 Spark1.2 Spark 特点1.3 Spark 的用户和用途第2章 Spark 集群安装2.1 集群角色2.2 机器准备2.3 下载 Spark 安装包2 ...
随机推荐
- Python 实例变量
class Person: def __init__(self, name, id, gender, birth): self.name = name # 实例变量 对象里的变量 self.id = ...
- 在SELECT的时候,加入一列固定值
SELECT * FROM (select id id, si_code code, si_sharetype sharetype, si_name name, si_organid organid, ...
- lintcode 刷题 by python 部分链表题总结(2)
本篇博客对最近做的链表的算法题做个简单的小结,主要描述题目和提供解题思路,具体代码见我的 github:https://github.com/MUSK1881/lintcode-by-python 3 ...
- python 和 matlab的caffe读数据细节
(1).prototxt中的输入表示一样,如 dim: 10 dim: 3 dim: 227 dim: 227 (2)代码喂入数据不一样: python: input_blob = np.ze ...
- [LeetCode&Python] Problem 485. Max Consecutive Ones
Given a binary array, find the maximum number of consecutive 1s in this array. Example 1: Input: [1, ...
- [LeetCode&Python] Problem 292. Nim Game
You are playing the following Nim Game with your friend: There is a heap of stones on the table, eac ...
- HBase使用压缩存储(snappy)
在将mysql数据导入到hbase数据的过程中,发现hbase的数据容量增加很快, 原本在mysql存储30G容量的数据导入到hbase一直增加到快150G(还未完全导入,手动结束), 而采用默认3个 ...
- 对于vs出现“This function or variable may be unsafe”
1.项目上右击选择“属性” 2.选择C/C++ ->预处理器 ->预处理器定义 3.添加一行 _CRT_SECURE_NO_WARNINGS 4.点击确定,重新编译成功.
- hello1 web项目中web.xml作用分析
该web.xml文件包含Facelets应用程序所需的几个元素.使用NetBeans IDE创建应用程序时,将自动创建以下所有内容. 指定项目阶段的上下文参数: <context-param&g ...
- PAT-1084(外观数列 ) && PAT-1085 (PAT单位排行)
1084 利用字符串string的可加性 #include <bits/stdc++.h> using namespace std; int main () { int x,n; cin ...