
用 HAproxy 搭建 RabbitMQ 集群
构建参考: [ Rabbitmq cluster setup with HAproxy ] [ python demo ]
RabbitMQ Cluster 遇到的问题
python pika 作为consumer 连接 rabbitmq cluster 的时候, 事实上连接的是 cluster 的一个 node, 当连接数过多的时候, 这个节点的处理性能会成为一个瓶颈, 可能会遇到这样的报错 [ connection reset by peer ].
对于 [ connection reset by peer ] 这个问题的处理, [ 这里 ] 提供了一个方案:
Client --> Load Balancer --> RabbitMQ Cluster Instances
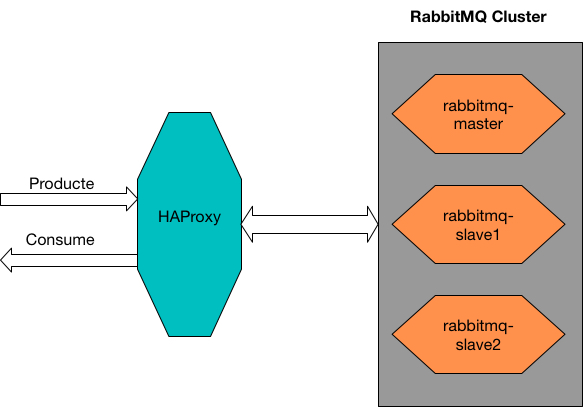
RabbitMQ 集群构建
集群环境
系统: CentOS 7.x x64
haproxy-server : 172.16.0.100
rabbitmq-master : 172.16.0.10
rabbitmq-slave1 : 172.16.0.11
rabbitmq-slave2 : 172.16.0.12
配置 /etc/hosts
172.16.0.10 rabbitmq-master
172.16.0.11 rabbitmq-slave1
172.16.0.12 rabbitmq-slave2
安装 RabbitMQ
在三台 rabbitmq 服务器上面分别执行:
yum install rabbitmq-server
配置 Cookie
RabbitMQ 集群通过 /var/lib/rabbitmq/.erlang.cookie 内的 cookie 值来确认各节点是否在同一个集群.
在 rabbitmq-master:
rabbitmq-server -detached
在 rabbitmq-master上查看 /var/lib/rabbitmq/.erlang.cookie 值:
cat /var/lib/rabbitmq/.erlang.cookie
比如获取的值为: GBNXRROLXDWMMIFZQWHD
在 rabbitmq-slave1 & rabbitmq-slave2 :
echo GBNXRROLXDWMMIFZQWHD > /var/lib/rabbitmq/.erlang.cookie
添加 Slave 节点到 master
在 rabbitmq-slave1 & rabbitmq-slave2 上面启动服务:
rabbitmq-server -detached
在rabbitmq-slave1 & rabbitmq-slave2 上分别执行:
rabbitmqctl stop_app

rabbitmqctl reset

rabbitmqctl join_cluster rabbitmq@rabbitmq-master

rabbitmqctl start_app
查看集群状态
在 RabbitMQ Cluster 任意一个节点:
rabbitmctl cluster_status
启用集群高可用
在 RabbitMQ Cluster 每个节点执行:
rabbitmqctl set_policy ha-all "" '{"ha-mode":"all","ha-sync-mode":"automatic"}'
启用 RabbitMQ 组件
在 RabbitMQ Cluster 每个节点执行:
rabbitmq-plugins enable rabbitmq_management
添加用户
在 RabbitMQ Cluster 每个节点:
rabbitmqctl add_user <username> <password>

rabbitmqctl set_user_tags <username> <tag>

rabbitmqctl set_permissions -p / <username> ".*" ".*" ".*"
备注: 在 rabbitmqctl set_user_tags <username> <tag>中, <tag> 可以是任何标记用户的字符, 比如 admin, normal, guest, developer 等标记用户身份的 tag.
这样, RabbitMQ 集群配置完成.
Web 访问
web 访问的前提是我们启用了 RabbitMQ 的组件: rabbitmq-plugins enable rabbitmq_management
可以在浏览器访问: http://ip_address:15672
登录用户和密码是 : rabbitmqctl add_user username password 设定的.
也可以使用默认添加的用户和密码: guest / guest.
HAProxy
以下所有的配置均在 haproxy-server 上面执行
安装 haproxy
yum install haproxy
配置 haproxy
vim /etc/haproxy/haproxy.cfg
global

daemon

defaults

mode tcp

maxconn 10000

timeout connect 5s

timeout client 100s

timeout server 100s

listen rabbitmq 172.16.0.100:5672

mode tcp

balance roundrobin

server rabbit-master 172.16.0.10:5672 check inter 5s rise 2 fall 3

server rabbit-node1 172.16.0.11:5672 check inter 5s rise 2 fall 3

server rabbit-node2 172.16.0.12:5672 check inter 5s rise 2 fall 3
启动 haproxy
systemctl start haproxy
至此, 用 HAproxy 做RabbitMQ 的 LB 的集群已经配置完成, 在连接 MQ 的时候, 只要将地址配置为 haproxy-server 的 IP 和对应 Port 即可. 接下来会用 python 程序做测试
RabbitMQ Cluster Product & Consume Test
生产者: send.py
#!/usr/bin/env python

import pika

connection = pika.BlockingConnection(pika.ConnectionParameters(host='172.16.0.100',port=5672))

channel = connection.channel()

channel.queue_declare(queue='hello')

channel.basic_publish(exchange='',

                      routing_key='hello',

                      body='Hello World!')

print(" [x] Sent 'Hello World!'")

connection.close()
消费者: receive.py
#!/usr/bin/env python

import pika

connection = pika.BlockingConnection(pika.ConnectionParameters(host='172.16.0.100',port=5672))

channel = connection.channel()

channel.queue_declare(queue='hello')

def callback(ch, method, properties, body):

    print(" [x] Received %r" % body)

channel.basic_consume(callback,

                      queue='hello',

                      no_ack=True)

print(' [*] Waiting for messages. To exit press CTRL+C')

channel.start_consuming()
生产
在同一网络中的机器 CLI 执行:
for i in {1..10};do python send.py;done
这可以写10条数据到 RabbitMQ 的队列中.
在 RabbitMQ Cluster 的任意一个节点执行:
rabbitmqctl list_queues
可以查看到队列以及队列内消息的数量.
消费
在同一网络中的机器 CLI 执行:
python receive.py
即可读取队列中的数据.
btw, 我爱死博客园的 markdown 了!
用 HAproxy 搭建 RabbitMQ 集群的更多相关文章
- 使用Haproxy代理rabbitmq集群,用keepalive保证haproxy高可用
原文地址:https://www.jianshu.com/p/440b8e1d5339 使用Haproxy代理rabbitmq集群 上一篇文章教了rabbitmq集群搭建.但是这样搭建出来的集群是3个 ...
- Docker:搭建RabbitMQ集群
RabbitMQ原理介绍(一) RabbitMQ安装使用(二) RabbitMQ添加新用户并支持远程访问(三) RabbitMQ管理命令rabbitmqctl详解(四) RabbitMQ两种集群模式配 ...
- 搭建RabbitMQ集群(Docker)
前一篇搭建RabbitMQ集群(通用)只是把笔记直接移动过来了,因为我的机器硬盘已经满了,实在是开不了那么虚拟机. 还好,我的Linux中安装了Docker,这篇文章就简单介绍一下Docker中搭建R ...
- Docker搭建RabbitMQ集群
Docker搭建RabbitMQ集群 Docker安装 见官网 RabbitMQ镜像下载及配置 见此博文 集群搭建 首先,我们需要启动运行RabbitMQ docker run -d --hostna ...
- 搭建rabbitmq集群
查看rabbitmq日志文件 开启web管理工具 [root@controller rabbitmq]# rabbitmq-plugins list [root@controller rabbitmq ...
- CentOS7 搭建RabbitMQ集群 后台管理 历史消费记录查看
简介 通过 Erlang 的分布式特性(通过 magic cookie 认证节点)进行 RabbitMQ 集群,各 RabbitMQ 服务为对等节点,即每个节点都提供服务给客户端连接,进行消息发送与接 ...
- docker+phantomjs+haproxy 搭建phantomjs集群
目标: 搭建一个远程的phantomjs服务器,提供高可用服务,支持并发. 原料: 1.docker环境.docker-compose环境 2.phantomjs镜像: docker.io/werni ...
- 搭建RabbitMQ集群(通用)
RabbitMQ在Erlang node(节点)上 Erlang天生具有集群特性,非常好搭建集群,每一个节点(node)上具有一个叫erlang.Cookie的东西,也是一个标识符,可以互认. 1). ...
- Haproxy搭建web集群
目录: 一.常见的web集群调度器 二.Haproxy应用分析 三.Haproxy调度算法原理 四.Haproxy特性 五.Haproxy搭建 Web 群集 一.常见的web集群调度器 目前常见的we ...
随机推荐
- pipelineDB里Combine用法
combine only works on aggregate columns that belong to continuous views. 创建CONTINUOUS CREATE CONTINU ...
- EF(EntityFramework)与mysql使用,乱码问题
1.中文乱码问题 利用ef更新数据到mysql数据库中,中文就会变成乱码"???",就算把mysql的数据库的编码设置为"utf8"也会变成乱码,从网上查询了下 ...
- iOS有关图片处理的总结 (四)------图片的饱和度,亮度,对照度。
在做图片处理的时候.会遇到调节图片的饱和度的问题,这里就要用到Core Image这个框架,Core Image是一个非常强大的框架. 它能够让你简单地应用各种滤镜来处理图像,比方改动鲜艳程度, 色泽 ...
- 中国十大B2C电商站点开发语言调查
中国B2C电商站点市场占有率排名例如以下 watermark/2/text/aHR0cDovL2Jsb2cuY3Nkbi5uZXQv/font/5a6L5L2T/fontsize/400/fill/I ...
- Java加载资源文件的两种方法
处理配置文件对于Java程序员来说再常见不过了,不管是Servlet,Spring,抑或是Structs,都需要与配置文件打交道.Java将配置文件当作一种资源(resource)来处理,并且提供了两 ...
- Springboot的默认定时任务——Scheduled注解
本博客参考博文地址. 1.pom依赖: 引入springboot starter包即可 <dependencies> <dependency> <groupId>o ...
- 自学Zabbix3.5.3-监控项item-key
1. 温习 Zabbix server是Zabbix软件的中心进程. Server执行polling和trapping来采集数据,评估是否触发触发器,发送报警给用户.它是Zabbix agent和pr ...
- url_for()中的坑,url_for操作对象是函数,而不是route里的路径
url_for操作对象是函数,而不是route里的路径. url_for操作对象是函数,而不是route里的路径. url_for操作对象是函数,而不是route里的路径.
- springboot+jpa+thymeleaf增删改查的示例(转)
这篇文章介绍如何使用jpa和thymeleaf做一个增删改查的示例. 先和大家聊聊我为什么喜欢写这种脚手架的项目,在我学习一门新技术的时候,总是想快速的搭建起一个demo来试试它的效果,越简单越容易上 ...
- 微信小程序路过
应该算是入门篇, 从我怎么0基础然后沿着什么方向走,遇到的什么坑,如何方向解决,不过本人接触不是很多,所以也就了解有限. 小程序的前提: 1.小程序大小不允许超过2M.(也就是本地图片,大图精图不要在 ...