
小白PDF阅读器开发-页面元素分割
以前用手机看PDF格式的电子书时,总感觉非常别扭,PDF格式的电子书在手机上缩放严重,字体太小,想看清楚得来回放大拖动,看书的兴致就在来回缩放拖动间被消耗没了!每次用手机看PDF电子书时就想着得做款能自动重排版的阅读器给我自己用。但是第一步就难住了,怎么分割页面元素?后来偶然间看到一篇介绍文字识别方面的技术文章,在传统的文字识别算法中,第一步是分割文字,然后再进行文字识别。这正好跟要做的重排PDF的第一步类似。下面就介绍下所用到的文字分割算法“投影法”。
“投影法”简单来说就是先统计每一行的像素数量,行与行之间会有明显的空白边界,这样就可以将行给分割出来,然后再按照行统计每一列的像素数量,文字之间也会又明显的空白边界,这样就可以将文字分割出来了。这就像用灯照射物体一样,有遮挡的地方是黑色,没有遮挡的地方光就透过去了,所以叫“投影法”。
按行统计
上面这张图按行统计像素数后,画出每行的像素数量,可以很明显的看到行与行之间的空白,如下图所示

分割每行的文字
行分割好后就可以分割每行的文字了,方法是统计文字行上每列的像素数量

通过分割图就可以明显看出来文字的边界了,这样就可以将文字分割开来。最终分割效果图如下:

下面是经过简化的小白PDF阅读器的实现代码
#include<opencv2/core/core.hpp>

#include<opencv.hpp>

#include<opencv2/highgui/highgui.hpp>

#include<iostream>

/*

* @Author 吴立中

* @Date   2023-07-08

*/

class Element {

public:

    int x = -1;

    int y = -1;

    int width = -1;

    int height = 0;

};

class Row {

public:

	int start = -1;//每一行的起始位置

	int end = -1;//每一行的结束位置

    std::vector<Element> elements;//每行的元素

};

/*

* 分割行

*/

std::vector<Row> splitRow(cv::Mat& mat) {

    std::vector<Row> rows;

    if (mat.empty()) {

        return rows;

    }

    std::vector<int> pos(mat.rows);

    //统计每行像素为黑色的数量

    for (int row = 0; row < mat.rows; row++) {

        for (int col = 0; col < mat.cols; col++) {

            if (mat.at<uchar>(row, col) == 0) {

                pos[row] = pos[row] + 1;

            }

        }

    }

    //画出统计结果

    cv::Mat result = mat.clone();

    for (int row = 0; row < result.rows; row++) {

        int size = pos[row];

        if (size > 0) {

            cv::line(result, cv::Point(0, row), cv::Point(size,row), cv::Scalar(0, 0, 0));

        }

    }

    cv::imwrite("D:\\workspace\\opencv\\image\\1_row.jpg", result);

    //根据统计分割每行

    Row row;

    for (int i = 0; i < mat.rows; i++) {

        if (pos.at(i) > 0) {

            if (row.start == -1 && row.end == -1) {

                row.start = i;

            }

        }

        else if (pos.at(i) == 0) {

            if (row.start > -1) {

                row.end = i;

                rows.push_back(row);

                row = Row();

            }

        }

    }

    if (row.start > row.end) {

        row.end = mat.rows - 1;

        if (row.end > row.start) {

            rows.push_back(row);

        }

    }

    return rows;

}

/*

* 分割列

*/

std::vector<Element> splitElement(Row& row,cv::Mat mat, cv::Mat drawMath) {

    std::vector<Element> elements;

    std::vector<int> pos(mat.cols);

    for (int c = 0; c < mat.cols; c++) {

        for (int r = row.start; r < row.end && r < mat.rows; r++) {

            if (mat.at<uchar>(r, c) == 0) {

                pos[c ] = pos[c] + 1;

            }

        }

    }

    //画出统计结果

    for (int c = 0; c < drawMath.cols; c++) {

        int size = pos[c];

        if (size > 0) {

            cv::line(drawMath, cv::Point(c, row.end), cv::Point(c, row.end -size), cv::Scalar(0, 0, 255));

        }

    }

    Element element;

    for (int i = 0; i < mat.cols; i++) {

        if (pos[i] > 0) {

            if (element.x == -1 && element.y == -1) {

                element.x = i;

                element.y = row.start;

                element.height = row.end - row.start;

            }

        }

        else if (pos[i] == 0) {

            if (element.x > -1 && element.width == -1) {

                element.width = i - element.x;

                elements.push_back(element);

                element = Element();

            }

        }

    }

    if (element.x > -1 && element.width == -1) {

        element.width = mat.cols - 1 - element.x;

        elements.push_back(element);

    }

    return elements;

}

int main(){

    //原图

    cv::Mat src = cv::imread("D:\\workspace\\opencv\\image\\1.png");

    //灰度化,变为灰度图

    cv::Mat gray;

    cv::cvtColor(src, gray, cv::COLOR_BGR2GRAY);

    //二值化,也就是变为黑白图片

    cv::Mat binary;

    cv::threshold(gray, binary,200,255, cv::THRESH_BINARY);

    //分割

    std::vector<Row> rows = splitRow(binary);

    cv::Mat temp = src.clone();

    for (int i = 0; i < (int)rows.size(); i++) {

        std::vector<Element> elements = splitElement(rows.at(i), binary, temp);

        //画文字边框

        for (int j = 0; j < (int)elements.size(); j++) {

            cv::Rect rect(elements.at(j).x, elements.at(j).y, elements.at(j).width, elements.at(j).height);

            cv::rectangle(src, rect, cv::Scalar(0, 0, 255));

        }

    }

    cv::imwrite("D:\\workspace\\opencv\\image\\2_col.jpg", temp);

    cv::imwrite("D:\\workspace\\opencv\\image\\2_r.jpg", src);

    return 0;

}
对于比较标准的页面,按照这种方法分割页面元素还是比较简单高效的,但是现实中的PDF页面排版五花八门,各种形态都有,这种方法就不适用了。同时该算法还存在比较明显的缺点就是会把左右结构的汉字如“非、北”等类似的汉字会给分割成两部分,对于英文单词也会全都给分割开。这在重排版时会造成汉字分在两行显示,或者英文单词被分在两行显示等问题。

对于上面这几种类型的页面投影法或者说是单纯的应用投影法分割页面元素也是行不通的,还有像文本倾斜,干扰严重的,投影法分割效果也不尽理想。
小白PDF阅读器在用投影法做出第一版后,后面大部分时间就是在解决这些问题了。好在通过各种方法,元素分割中遇到的大部分问题都给解决了,算法比投影法要复杂的多,限于篇幅有限就不一一详述了,放几张小白PDF阅读器分割算法分割效果图
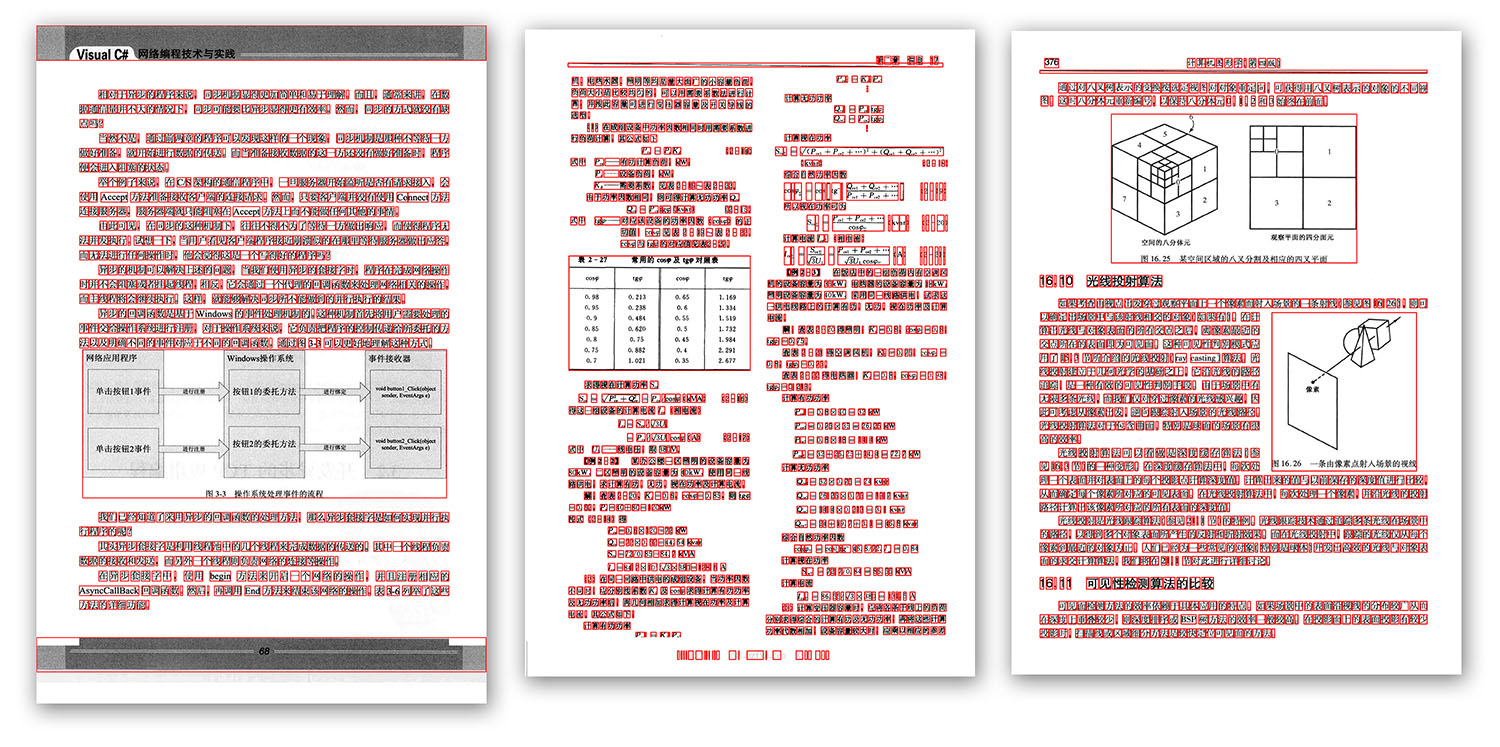
经过一年多的优化修改,现在小白PDF阅读器的分割算法已能正确分割绝大部分PDF页面元素,这也是小白PDF阅读器最终能正确重排版的第一步也是最关键的一步!
小白PDF阅读器开发-页面元素分割的更多相关文章
- pdf阅读器开发
文章基于sumatrapdf的实现(当中mupdf中的内容不会太多涉及).以及自己在此基础上做的 优化,扩展.详细效果能够參考百度阅读器精简版. 最NB的还是得属于foxit.渲染速度一流,展示大图片 ...
- 使用C#开发pdf阅读器初探(基于WPF,没有使用开源库)
前言 pdf是最流行的版式格式文件标准,已成为国际标准.pdf相关的开源软件非常多,也基本能满足日常需要了.相关商业软件更是林林总总,几乎应有尽有!似乎没必要自己再独立自主开发!但,本人基于以下考虑, ...
- Ubuntu 18.10 安装PDF阅读器
======================================== 软件开发转移到了 Linux上,使用Ubuntu 18.10作为桌面开发环境 下面介绍 安装PDF阅读器 1.下载 福 ...
- 一个炒鸡好用的pdf阅读器
下载地址:https://www.sumatrapdfreader.org/free-pdf-reader.html 一个关系很好的同事推荐的pdf阅读器 之前用的感觉不错 每次都记不住 自己收 ...
- Blazor组件自做十二 : Blazor Pdf Reader PDF阅读器 组件 (草稿)
原文链接 [https://www.cnblogs.com/densen2014/p/16954812.html] Blazor Pdf Reader PDF阅读器 组件 应小伙伴要求撸了一个简单的P ...
- Blazor组件自做十二 : Blazor Pdf Reader PDF阅读器 组件 (新版 7.1 移除pdfobject)
Blazor Pdf Reader PDF阅读器 组件 示例: https://www.blazor.zone/PdfReaders https://blazor.app1.es/pdfReaders ...
- Blazor Pdf Reader PDF阅读器 组件 更新
Blazor Pdf Reader PDF阅读器 组件 https://www.nuget.org/packages/BootstrapBlazor.PdfReader#readme-body-tab ...
- Linux下pdf阅读器推荐
由于需要在pdf文件上做标记,所以自带的文档查看器根本满足了需求,之前去网上查了查,Okular评价挺高,就安装了一个,确实能基本满足我的需求,但是 1.界面感觉还是不太友好,书签栏一直在那. 2.而 ...
- Foix_Reader_6.0|PDF阅读器
福晰PDF阅读器,是阅读器中的精品.此版本是优化版本. 00:风格前卫 01:使用简洁 下载地址: http://yunpan.cn/cHvyUfCdMKZz6 访问密码 ead7
- 关于linux上pdf阅读器
今天也是倒腾linux 上pdf阅读器好久. 1.okular是挺好的,但是却太大了,好多功能,我没有细看.我简单的打开了几个pdf文件,发现加载速度还是太慢了.所以基于种种,我给卸载掉了. 安装直接 ...
随机推荐
- webpack笔记-webpack之模块module、路径解析、resolve 配置(三)
module webpack 的初衷是让 js 支持模块化管理,并且将前端中的各种资源都纳入到对应的模块管理中来,所以在 webpack 的设计中,最重要的部分就是管理模块和模块之间的关系. 在 we ...
- 前后端沟通 naming conversion 转换需要知道的事
c# 是 pascal case, js 是 camel case 所以在做 web api 和 odata 的时候经常需要转换. 早年 web api 是依赖 Newtonsoft json (JS ...
- SpringMVC —— REST风格简介
REST风格简介 REST(Representational State Transfer),表现形式转换 传统风格资源描述形式 REST风格描述形式 优点 隐藏资源的访问行为,无法通过地址得知对资源 ...
- JSON——简介
JSON--简介 JSON--基础语法 JSON--json数据与java对象的转换 // 将java对象转为json字符串 User user = new User(1,&q ...
- [namespace hdk] 向量 direct_vector
我忏悔我有罪我心情又不好了不知道干什么所以又不小心封了个东西啊啊啊啊啊啊啊啊 功能 已重载 [] 运算符(左值) 已重载 = 运算符(可使用向量或 std:::vector) 已重载 + += - - ...
- 使用MessagePipe实现进程间通信
1.MessagePipe介绍 可以用于.NET和Unity上面的高性能的内存/分布式消息传递管道.适用于发布/订阅模式.CQRS的中介模式.Prism中的EventAggregator.IPC(进程 ...
- 4.1 数列的概念2 (递推公式、前n项和)
\({\color{Red}{欢迎到学科网下载资料学习 }}\) [ [基础过关系列]高二数学同步精品讲义与分层练习(人教A版2019)] ( https://www.zxxk.com/docpack ...
- excel导出功能的实现流程说⼀下?
导出的话,我们因为到处的数据量不⼤,所以直接采取的时候前端主导的⽅案,参考的现成⽅案实现的 导出 ⼤概得流程就是 1. 调⽤后端接⼝得到要导出的数据 2. 把数据简单处理⼀下转化成导出插件需要的格式 ...
- CEOI2023
Day1 T1 A Light Inconvenience (light) 题意:若干个人排成一个队列,保证任何时刻队列中都有至少一个人.每个人手中有一个火把,火把有点亮和熄灭两种状态. 现在进行 \ ...
- KubeSphere 社区双周报 | KubeKey v3.0.0 发布 | 2022-11-10
KubeSphere 从诞生的第一天起便秉持着开源.开放的理念,并且以社区的方式成长,如今 KubeSphere 已经成为全球最受欢迎的开源容器平台之一.这些都离不开社区小伙伴的共同努力,你们为 Ku ...