
OpenCL memory object 之 Global memory (2)
转载自:http://www.cnblogs.com/mikewolf2002/archive/2011/12/18/2291584.html
当我们用clCreateBuffer, clCreateImage创建OpenCL memory object时候,我们需要输入一个flag参数,这个参数决定memory object的位置。
cl_mem    clCreateBuffer (cl_context context,
                                             cl_mem_flags flags,
                                             size_t size,
                                             void *host_ptr,
                                             cl_int *errcode_ret) ;

 cl_mem    clCreateImage2D (cl_context context,
                            cl_mem_flags flags,
                            const cl_image_format *image_format,
                            size_t image_width,
                            size_t image_height,
                            size_t image_row_pitch,
                            void *host_ptr,
                            cl_int *errcode_ret)
创建memory object后,并没有立即给它分配空间,而是在第一次device2device之间copy数据时候,才会真正的分配空间,所以我们经常会感觉到,第一次使用某个memory object时候会比较慢。
在AMD APP 2.5中,根据flag值,memory object分配位置如下表4.3所示:
注意AMD 扩展flag: CL_MEM_USE_PERSISTENT_MEM_AMD中,把memory object创建在host visible device memory中,这样实现了zero copy操作。
我们能够用函数clEnqueueMapBuffer把device memory object映射到host memory空间,以便cpu进行处理,处理完后,我们要调用clEnqueueUnmapMemObject进行反映射操作,以便device能继续访问memory object,注意:在map期间,device不能访问。
下面我们了解一个重要的概念:zero copy memory ojbect以及copy memory object
memory object位于host memory,或者位于device meory,但是host能够直接访问,这样的memory object称作zero copy memory object,因为数据从来没有在host和device之间进行过实际传输,但host和device都能直接访问它。
如果memory object在device上,需要在host和device之间进行to and from传输操作,这种memory object称作copy memory object。
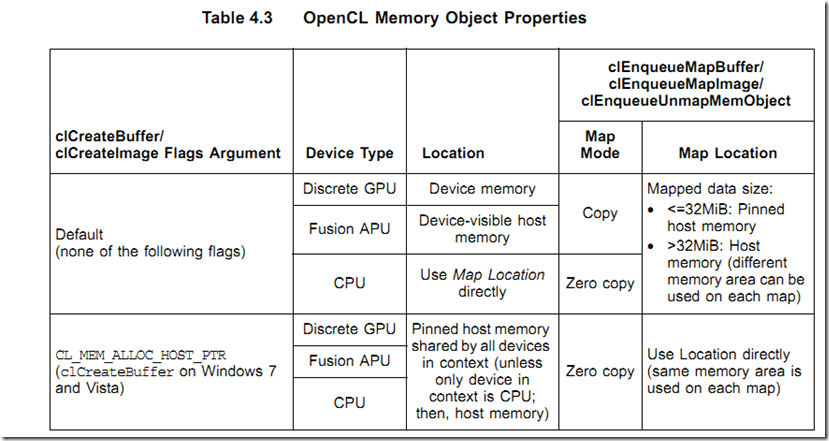
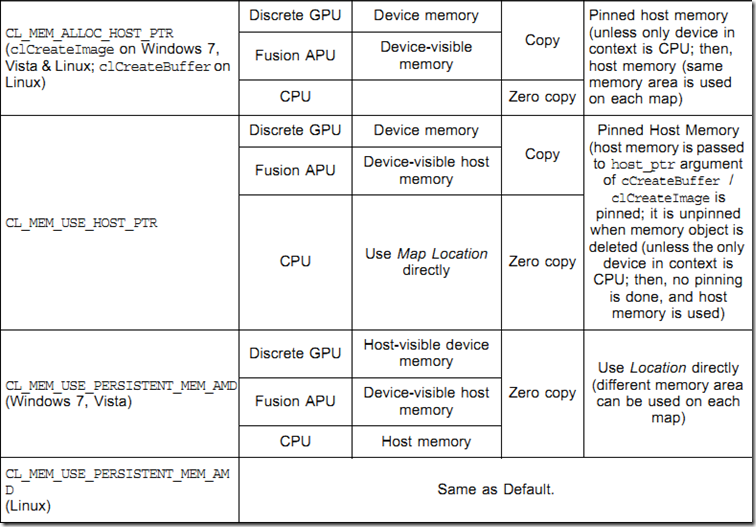
注意CL_MEM_USE_PERSISTENT_MEM_AMD 和CL_MEM_ALLOC_HOST_PTR的不同之处,前者创建device驻留的zero copy memory,后者创建host驻留的zero copy memory。
使用zero copy memory时候,clEnqueueMapBuffer/clEnqueueMapImage/clEnqueueUnmapMemObject 操作并不产生实际的传输操作,所以速度很快,但是对于同一个zero memory object,每次runtime都会返回不同的指针值。
当device以sparse(稀疏)方式访问host memory时,驻留host的zero copy memory object也能提高程序performance,但要注意:此时,传输数据的代价一定大于slower的直接访问代价。
host能够以host<->device数据传输带宽速度对驻留device的zero copy memory进行写操作(combined write),所以当host不需要读memory object的时候,我们可以使用zero copy device memory避免数据传输操作。注意:zero copy device驻留images也是支持的,但zero copy host 驻留images不被支持。linux也不支持zero copy memory object。
对于copy模式的memory object, 一般都位于device momeroy,需要在host和device之间来回传输数据。注意:实际上只传输memory object被request部分数据,这样提高传输性能。
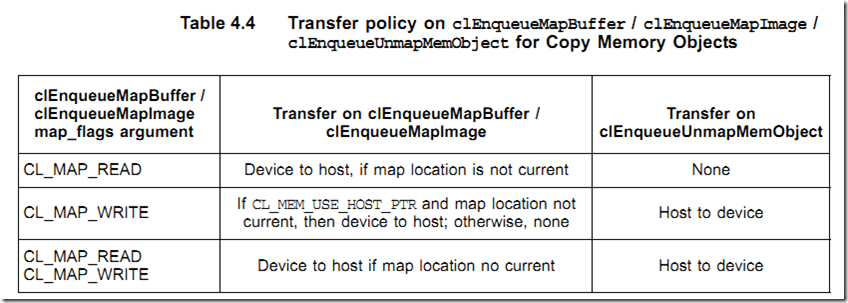
对于使用缺省方式创建的memory object,clEnqueueMapBuffer/clEnqueueMapImage每次返回的指针可能不同,因为runtime每次映射的host memory区域不同,但对于用CL_MEM_USE_HOST_PTR和CL_MEM_ALLOC_HOST_PTR 方式创建的memory object,每次返回的指针是一样的,因为每次都是返回相同的映射位置,而且对于这两种方式创建的memory object,每次传输前,runtime都要track当前位置是否是最新的memory object,以便决定是否传输。[注:缺省方式创建的memory object不能被tracker,因为每次位置都不同,所以总要执行传输操作]。
对于用CL_MEM_USE_HOST_PTR创建的memory object,clCreateBuffer/clCreateImage 每次都要对分配的内存执行pinned操作,删除memory object后,还要执行unpinned操作。为了最小化pinned/unpinned的代价,分配的内存应该4K对齐,这样不用每次map/unmap都做pin/unpin操作,但是这样做确实浪费了一些空间。如果host memory object需要频繁进行map操作,建议使用CL_MEM_ALLOC_HOST_PTR和CL_MEM_COPY_HOST_PTR,相应的,如果device memory需要频繁map,使用CL_MEM_USE_PERSISTENT_MEM_AMD以及clEnqueueWriteBuffer。
注:当用CL_MEM_ALLOC_HOST_PTR和CL_MEM_COPY_HOST_PTR指针创建memory object时候,memory实际上被创建在pinned host memory中,并初始化数据。CL_MEM_COPY_HOST_PTR相比于CL_MEM_ALLOC_HOST_PTR多了一个把初始化后的数据copy到device memory中的操作,并不推荐这样使用,还是第一次使用时再传输效率更高。
images 对象传输需要额外的costs,因为images必须在线性地址模式(host使用)和tile地址模式(device使用)之间转换。
Read/Write/Map memory object的时候,我们要尽量使用non-blocking命令方式,这样,命令都在缓冲中排队,通过flush(clFlush)操作,以大批次的方式传输到GPU,分摊了runtime准备和提交数据到GPU的开销。我们能够用event机制来决定操作之间的依赖关系。目前,runtime还没有完全挖掘异步DMA传输的潜力,但是我们保持正确的编码是需要的,一旦dirver提供了支持,我们就能提高程序性能。
OpenCL memory object 之 Global memory (2)的更多相关文章
- OpenCL memory object 之 Global memory (1)
本文转载自:http://www.cnblogs.com/mikewolf2002/archive/2011/12/17/2291239.html 这篇日志是学习AMD OpenCL文档时候的总结. ...
- OpenCL memory object 之 传输优化
转载自:http://www.cnblogs.com/mikewolf2002/archive/2011/12/18/2291741.html 首先我们了解一些优化时候的术语及其定义: 1.defer ...
- 【并行计算-CUDA开发】有关CUDA当中global memory如何实现合并访问跟内存对齐相关的问题
ps:这是英伟达二面面的一道相关CUDA的题目.<NVIDIA CUDA编程指南>第57页开始 在合并访问这里,不要跟shared memory的bank conflic ...
- 【转】C++ Incorrect Memory Usage and Corrupted Memory(模拟C++程序内存使用崩溃问题)
http://www.bogotobogo.com/cplusplus/CppCrashDebuggingMemoryLeak.php Incorrect Memory Usage and Corru ...
- System and method for parallel execution of memory transactions using multiple memory models, including SSO, TSO, PSO and RMO
A data processor supports the use of multiple memory models by computer programs. At a device extern ...
- php编译 :virtual memory exhausted: Cannot allocate memory
有时候用vps建站时需要通过编译的方式来安装主机控制面板.对于大内存的VPS来说一般问题不大,但是对于小内存,比如512MB内存的VPS来说,很有可能会出现问题,因为编译过程是一个内存消耗较大的动作. ...
- 编译时:virtual memory exhausted: Cannot allocate memory
一.问题 当安装虚拟机时系统时没有设置swap大小或设置内存太小,编译程序会出现virtual memory exhausted: Cannot allocate memory的问题,可以用swap扩 ...
- 错误处理:error(0) error portability:3 this xilinx application has run out of memory has encountered a memory conflict
在FPGA侧提供了一个gp0,gp1各占1m内存的版本后.生成mcs版本,在下载版本时报错: error(0) error portability:3 this xilinx application ...
- 编译时:virtual memory exhausted: Cannot allocate memory,常见于VPS
原文链接:http://blog.csdn.net/taiyang1987912/article/details/41695895 一.问题 当安装虚拟机时系统时没有设置swap大小或设置内存太小,编 ...
随机推荐
- 日期字符串转换为NSDate
// 纯数字日期 NSString *str1 = "; // 日期字符串 NSString *str2 = @"2015/05/12 10:22:01"; // 带时区 ...
- Python3 字符编码
编码 字符串是一种数据类型,但是,字符串比较特殊的是还有一个编码问题. 因为计算机只能处理数字,如果要处理文本,就必须先把文本转换为数字才能处理.最早的计算机在设计时采用8个比特(bit)作为一个字节 ...
- sql 自身连接
"select table1.field1, table2.field1 from table table1, table table2 where table1.id=table2.par ...
- [C#]『PLINQ』任务并行库使用小计
并行 LINQ (PLINQ) 是 LINQ to Objects 的并行实现. PLINQ 实现完整的 LINQ 标准查询运算符集作为 T:System.Linq 命名空间的扩展方法,并具有用于并行 ...
- sae后台管理的js(二)
jsloader cssloader 使用方法<link rel="stylesheet" type="text/css" href="/min ...
- JavaScript原型链demo
function Person(name){ this.name = name; } Person.prototype = { say: function(){ alert('hi'); }, say ...
- jquery右下角返回顶部
实现的效果也就是,当有滚动条是,滚动条未动或与顶部距离小于多少像素是,返回顶部按钮处于隐身状态,当滚动条与顶部距离大于一定像素时,返回顶部按钮出现,实现点击‘返回按钮’后,从当前位置回到等不位置.要先 ...
- [python]类与类中的列表
最近在用类中的列表时出现一件怪事 实例2中的列表,竟然有实例1中的数据. 查了半天发现是list的append方法的问题. 将全部的list.append(value) 换成 list = list ...
- Navigation学习笔记
***************************** 使用storyboard导航********************************* storyboard方式相对简单. 在弹出来 ...
- AndroidStudio Gradle版本不匹配问题
报错信息: p.p1 { margin: 0.0px 0.0px 0.0px 0.0px; font: 12.0px Helvetica } Error:(1, 1) A problem occurr ...