
hive学习笔记之四:分区表
欢迎访问我的GitHub
https://github.com/zq2599/blog_demos
内容:所有原创文章分类汇总及配套源码,涉及Java、Docker、Kubernetes、DevOPS等;
《hive学习笔记》系列导航
本篇概览
本文是《hive学习笔记》系列的第四篇,要学习的是hive的分区表,简单来说hive的分区就是创建层级目录的一种方式,处于同一分区的记录其实就是数据在同一个子目录下,分区一共有两种:静态和动态,接下来逐一尝试;
静态分区(单字段分区)
先尝试用单个字段分区,t9表有三个字段:名称city、年龄age、城市city,以城市作为分区字段:
- 建表:
create table t9 (name string, age int)

partitioned by (city string)

row format delimited

fields terminated by ',';
- 查看:
hive> desc t9;

OK

name                	string

age                 	int

city                	string

# Partition Information

# col_name            	data_type           	comment

city                	string

Time taken: 0.159 seconds, Fetched: 8 row(s)
- 创建名为009.txt的文本文件,内容如下,可见每行只有name和age两个字段,用来分区的city字段不在这里设置,而是在执行导入命令的时候设置,稍后就会见到:
tom,11

jerry,12
- 导入数据的命令如下,可见导入命令中制定了city字段,也就是说一次导入的所有数据,city字段值都是同一个:
load data

local inpath '/home/hadoop/temp/202010/25/009.txt'

into table t9

partition(city='shenzhen');
- 再执行一次导入操作,命令如下,city的值从前面的shenzhen改为guangzhou:
load data

local inpath '/home/hadoop/temp/202010/25/009.txt'

into table t9

partition(city='guangzhou');
- 查询数据,可见一共四条数据,city共有两个值:
hive> select * from t9;

OK

t9.name	t9.age	t9.city

tom	11	guangzhou

jerry	12	guangzhou

tom	11	shenzhen

jerry	12	shenzhen

Time taken: 0.104 seconds, Fetched: 4 row(s)
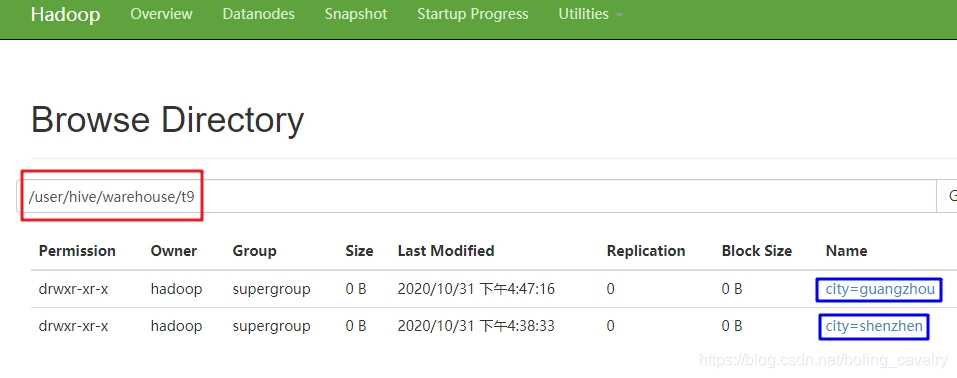
- 前面曾提到分区实际上是不同的子目录,来看一下是不是如此,如下图,红框是t9的文件目录,下面有两个子目录city=guangzhou和city=shenzhen:
- 查看子目录里面文件的内容,可见每条记录只有name和age两个字段:
[hadoop@node0 bin]$ ./hadoop fs -ls /user/hive/warehouse/t9/city=guangzhou

Found 1 items

-rwxr-xr-x   3 hadoop supergroup         16 2020-10-31 16:47 /user/hive/warehouse/t9/city=guangzhou/009.txt

[hadoop@node0 bin]$ ./hadoop fs -cat /user/hive/warehouse/t9/city=guangzhou/009.txt

tom,11

jerry,12

[hadoop@node0 bin]$
以上就是以单个字段做静态分区的实践,接下来尝试多字段分区;
静态分区(多字段分区)
- 新建名为t10的表,有两个分区字段:province和city,建表语句:
create table t10 (name string, age int)

partitioned by (province string, city string)

row format delimited

fields terminated by ',';
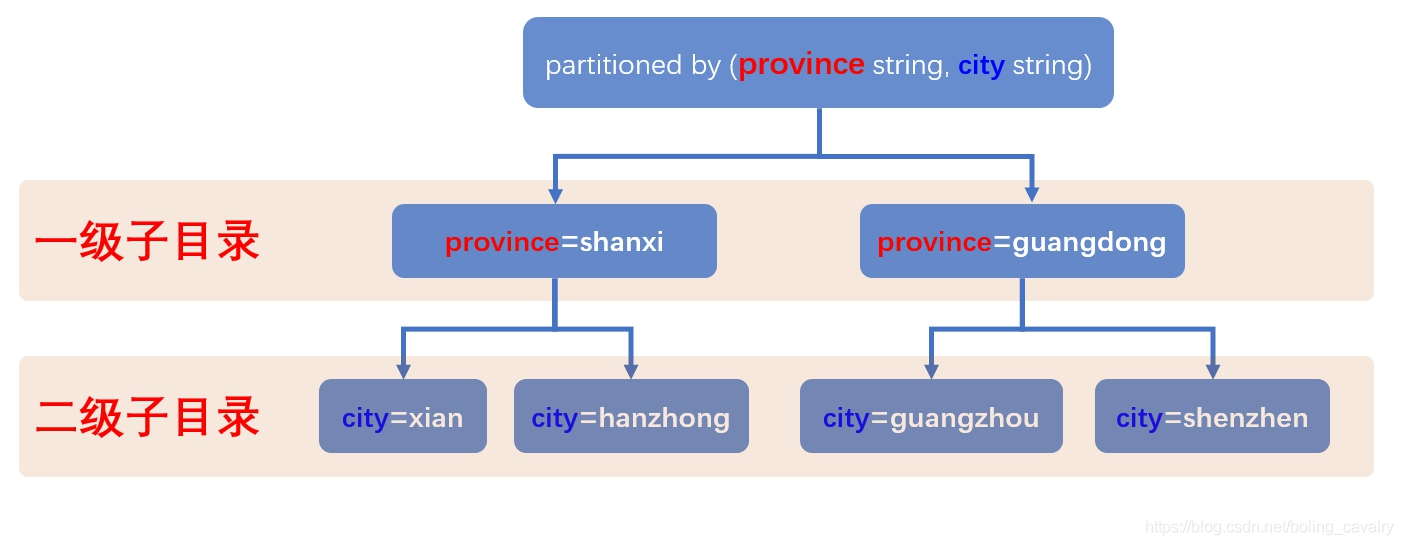
- 上述建表语句中,分区字段province写在了city前面,这就意味着第一级子目录是province值,每个province子目录,再按照city值建立二级子目录,图示如下:
3. 第一次导入,province='shanxi', city='xian':
load data

local inpath '/home/hadoop/temp/202010/25/009.txt'

into table t10

partition(province='shanxi', city='xian');
- 第二次导入,province='shanxi', city='xian':
load data

local inpath '/home/hadoop/temp/202010/25/009.txt'

into table t10

partition(province='shanxi', city='hanzhong');
- 第三次导入,province='guangdong', city='guangzhou':
load data

local inpath '/home/hadoop/temp/202010/25/009.txt'

into table t10

partition(province='guangdong', city='guangzhou');
- 第四次导入,province='guangdong', city='shenzhen':
load data

local inpath '/home/hadoop/temp/202010/25/009.txt'

into table t10

partition(province='guangdong', city='shenzhen');
- 全部数据如下:
hive> select * from t10;

OK

t10.name	t10.age	t10.province	t10.city

tom	11	guangdong	guangzhou

jerry	12	guangdong	guangzhou

tom	11	guangdong	shenzhen

jerry	12	guangdong	shenzhen

tom	11	shanxi	hanzhong

jerry	12	shanxi	hanzhong

tom	11	shanxi	xian

jerry	12	shanxi	xian

Time taken: 0.129 seconds, Fetched: 8 row(s)
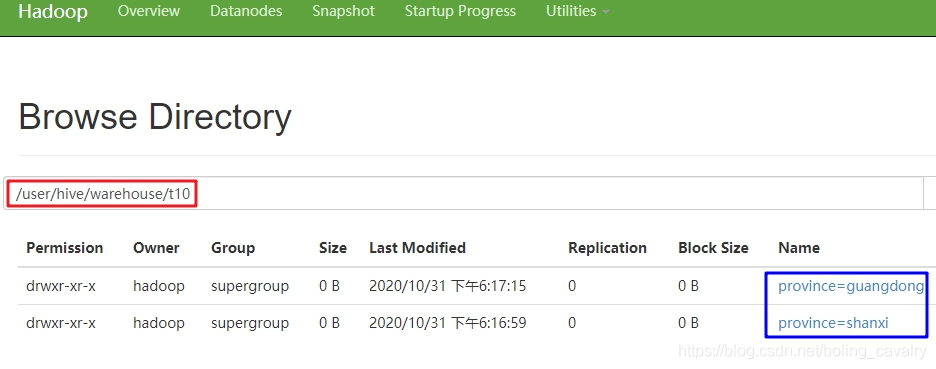
- 查看hdfs文件夹,如下图,一级目录是province字段的值:
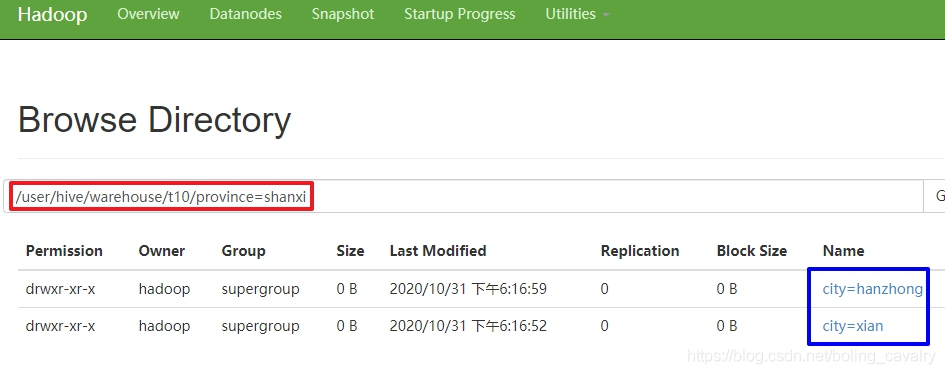
- 打开一个一级目录,如下图,可见二级目录是city的值:
10. 查看数据:
[hadoop@node0 bin]$ ./hadoop fs -cat /user/hive/warehouse/t10/province=shanxi/city=hanzhong/009.txt

tom,11

jerry,12
- 以上就是静态分区的基本操作,可见静态分区有个不便之处:新增数据的时候要针对每一个分区单独使用load命令去操作,这时候使用动态分区来解决这个麻烦;
动态分区
- 动态分区的特点就是不用指定分区目录,由hive自己选择;
- 执行以下命令开启动态分区功能:
set hive.exec.dynamic.partition=true
- 名为hive.exec.dynamic.partition.mode的属性,默认值是strict,意思是不允许分区列全部是动态的,这里改为nostrict以取消此禁制,允许全部分区都是动态分区:
set hive.exec.dynamic.partition.mode=nostrict;
- 建一个外部表,名为t11,只有四个字段:
create external table t11 (name string, age int, province string, city string)

row format delimited

fields terminated by ','

location '/data/external_t11';
- 创建名为011.txt的文件,内容如下:
tom,11,guangdong,guangzhou

jerry,12,guangdong,shenzhen

tony,13,shanxi,xian

john,14,shanxi,hanzhong
- 将011.txt中的四条记录载入表t11:
load data

local inpath '/home/hadoop/temp/202010/25/011.txt'

into table t11;
- 接下来要,先创建动态分区表t12,再把t11表的数据添加到t12中;
- t12的建表语句如下,按照province+city分区:
create table t12 (name string, age int)

partitioned by (province string, city string)

row format delimited

fields terminated by ',';
- 执行以下操作,即可将t11的所有数据写入动态分区表t12,注意,要用overwrite:
insert overwrite table t12

partition(province, city)

select name, age, province, city from t11;
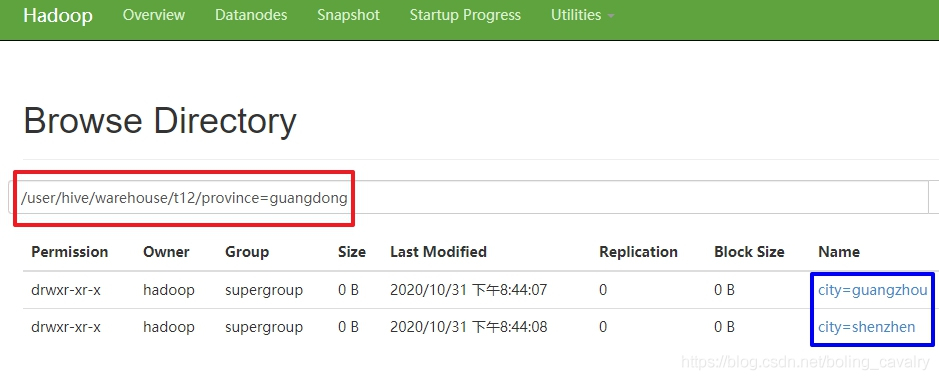
- 通过hdfs查看文件夹,可见一级和二级子目录都符合预期:
11. 最后检查二级子目录下的数据文件,可以看到该分区下的记录:
[hadoop@node0 bin]$ ./hadoop fs -cat /user/hive/warehouse/t12/province=guangdong/city=guangzhou/000000_0

tom,11
至此,分区表的学习就完成了,希望能给您一些参考;
你不孤单,欣宸原创一路相伴
欢迎关注公众号:程序员欣宸
微信搜索「程序员欣宸」,我是欣宸,期待与您一同畅游Java世界...
https://github.com/zq2599/blog_demos
hive学习笔记之四:分区表的更多相关文章
- hive学习笔记之一:基本数据类型
欢迎访问我的GitHub https://github.com/zq2599/blog_demos 内容:所有原创文章分类汇总及配套源码,涉及Java.Docker.Kubernetes.DevOPS ...
- hive学习笔记之三:内部表和外部表
欢迎访问我的GitHub https://github.com/zq2599/blog_demos 内容:所有原创文章分类汇总及配套源码,涉及Java.Docker.Kubernetes.DevOPS ...
- hive学习笔记之五:分桶
欢迎访问我的GitHub https://github.com/zq2599/blog_demos 内容:所有原创文章分类汇总及配套源码,涉及Java.Docker.Kubernetes.DevOPS ...
- hive学习笔记之六:HiveQL基础
欢迎访问我的GitHub https://github.com/zq2599/blog_demos 内容:所有原创文章分类汇总及配套源码,涉及Java.Docker.Kubernetes.DevOPS ...
- hive学习笔记之七:内置函数
欢迎访问我的GitHub https://github.com/zq2599/blog_demos 内容:所有原创文章分类汇总及配套源码,涉及Java.Docker.Kubernetes.DevOPS ...
- hive学习笔记之九:基础UDF
欢迎访问我的GitHub https://github.com/zq2599/blog_demos 内容:所有原创文章分类汇总及配套源码,涉及Java.Docker.Kubernetes.DevOPS ...
- Oracle学习笔记之四sp1,Oracle 11g的常用函数
从Oracle学习笔记之四,SQL语言入门中摘出来的,独立成一章节 3.1 字符类函数 ASCII(c)和CHR(i) 分别用于返回一个字符的ASCII码和返回给定ASCII值所对应的字符. C ...
- hive学习笔记之十:用户自定义聚合函数(UDAF)
欢迎访问我的GitHub 这里分类和汇总了欣宸的全部原创(含配套源码):https://github.com/zq2599/blog_demos 本篇概览 本文是<hive学习笔记>的第十 ...
- hive学习笔记之十一:UDTF
欢迎访问我的GitHub https://github.com/zq2599/blog_demos 内容:所有原创文章分类汇总及配套源码,涉及Java.Docker.Kubernetes.DevOPS ...
随机推荐
- node.js的包加载机制
加载一个模块 require('moduleName'); 现在核心模块中加载,如果核心模块中没有,那么就去node_modules目录下去找,核心模块的优先级最高. 如果加载模块式省略了文件的后缀名 ...
- 在Vim中查看文件编码和文件编码转换
在Vim中查看文件编码和文件编码转换 风亡小窝 关注 0.2 2016.09.26 22:43* 字数 244 阅读 5663评论 0喜欢 2 在Vim中查看文件编码 :set fileencodi ...
- xrandr 直接输这个能显示可用的分辨和当前的分辨率 xrandr -s 1920x1200就设置成指定的分辨率
利用 xrandr 命令修改屏幕分辨率 时间 2016-10-29 原文 http://blog.csdn.net/mao0514/article/details/52965700 问题背景 ...
- ./g1.sh q w e r 5个参数 bash命令 获取 命令实际的参数 shell文件名称$0 第一个参数$1第2个参数$2 最后一个参数$#;参数个数$#个;所有的参数列出来$* 返回值$? 正确0 失败1
# ./g1.sh q w e r t./g1.sh q w e r5个参数number is q w e r t[root@localhost get]# cat g1.sh#!/bin/bash# ...
- Mysql不知道默认密码情况下登录/重置/忘记密码
场景一: 基础系统:linux 镜像:LAMP环境(Ubuntu 18.04 Apache PHP7.0) 问题:ERROR 1405 (28000): Access denied for user ...
- mysql3_pymysql
python数据库编程 1.pyshon数据库接口(python DB-API) 1.为开发人员提供的数据库应用编程接口 2.python支持的数据库服务软件 mysql,oracle,sql_ser ...
- exec函数族实例解析-(转自blankqdb)
fork()函数通过系统调用创建一个与原来进程(父进程)几乎完全相同的进程(子进程是父进程的副本,它将获得父进程数据空间.堆.栈等资源的副本.注意,子进程持有的是上述存储空间的"副本&quo ...
- Linux 系统日志和系统信息常用命令介绍
日志文件 日 志 文 件 说 明 /var/log/message 系统启动后的信息和错误日志,是Red Hat Linux中最常用的日志之一 /var/log/secure 与安全相关的日志信息 / ...
- vue+element-ui, el-upload组件 文件上传之前return false,会自动调用文件移除回调问题
日常搬砖的时候,项目中在使用element-ui的上传组件,但是当我在文件上传文件之前的回调里面做了些文件格式的二次校验和文件大小的校验的时 然后 return false 会发现调用 文件移除的回调 ...
- 常用Python第三方库简介
如果说强大的标准库奠定了Python发展的基石,丰富的第三方库则是python不断发展的保证,随着python的发展一些稳定的第三库被加入到了标准库里面,这里有6000多个第三方库的介绍 下表中加粗并 ...