
信息论估计工具jidt基本使用
JIDT基本介绍
- JIDT是 Java Information Dynamics Toolkit的简称,用于研究复杂系统中信息论相关度量的计算,它是一个基于java的开源工具库,也可以在Matlab、Octave、Python、R、Julia和Clojure中使用;
- JIDT提供了如下计算工具:
- 信息熵、互信息、转移熵
- 条件互信息、条件转移熵
- 多变量互信息和多变量转移熵
- 信息存储
- JIDT同时支持离散型数据和连续型数据
- JIDT提供多种估计算子
主页:https://github.com/jlizier/jidt
安装
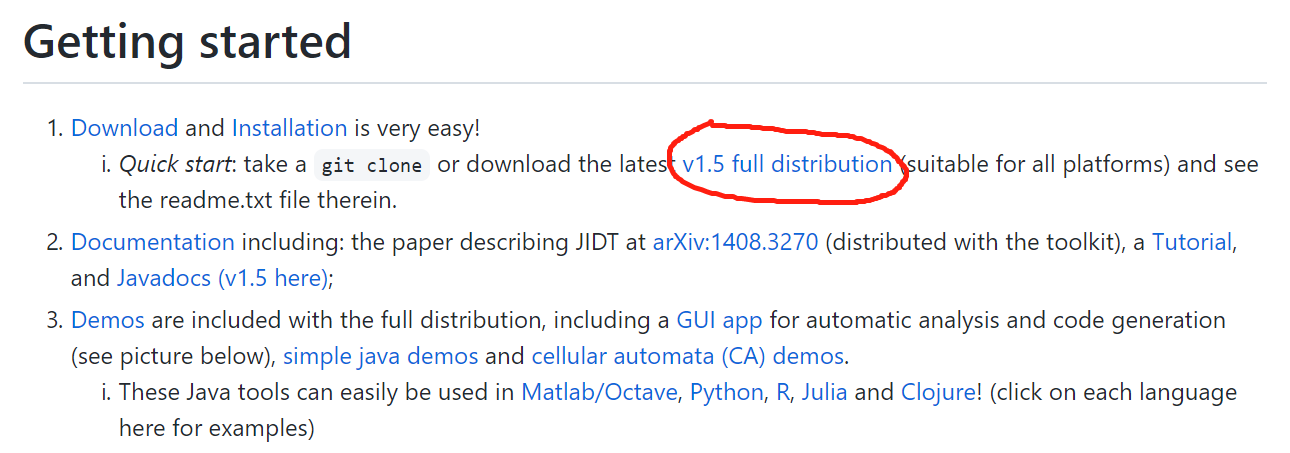
第一步:下载编译好的版本,图中的
v1.5 full distribution,然后解压放到合适的目录,如~/software/infodynamics,我们只需要里面的infodynamics.jar文件。第二步:熟悉Java的同学应该知道这个jar文件是个什么东东,这就是所有信息论度量计算所需要的函数哈,所以现在需要安装配置Java环境,这里不再赘述。
第三步:由于需要在python环境中使用java计算,所以需要安装
jpype,安装命令:pip install jpype1
配置好环境之后,在使用jidt之前加入如下一段代码:
import jpype

from jpype import *

try:

    jarLocation = "~/software/infodynamics/infodynamics.jar"

    jpype.startJVM(jpype.getDefaultJVMPath(), "-ea", "-Djava.class.path=" + jarLocation)

except:

    print("JVM  has already started !")
注: 需要把jarLocation换成自己的路径!
接下来就能够调用jidt中各种封装好的信息论估计算子了:
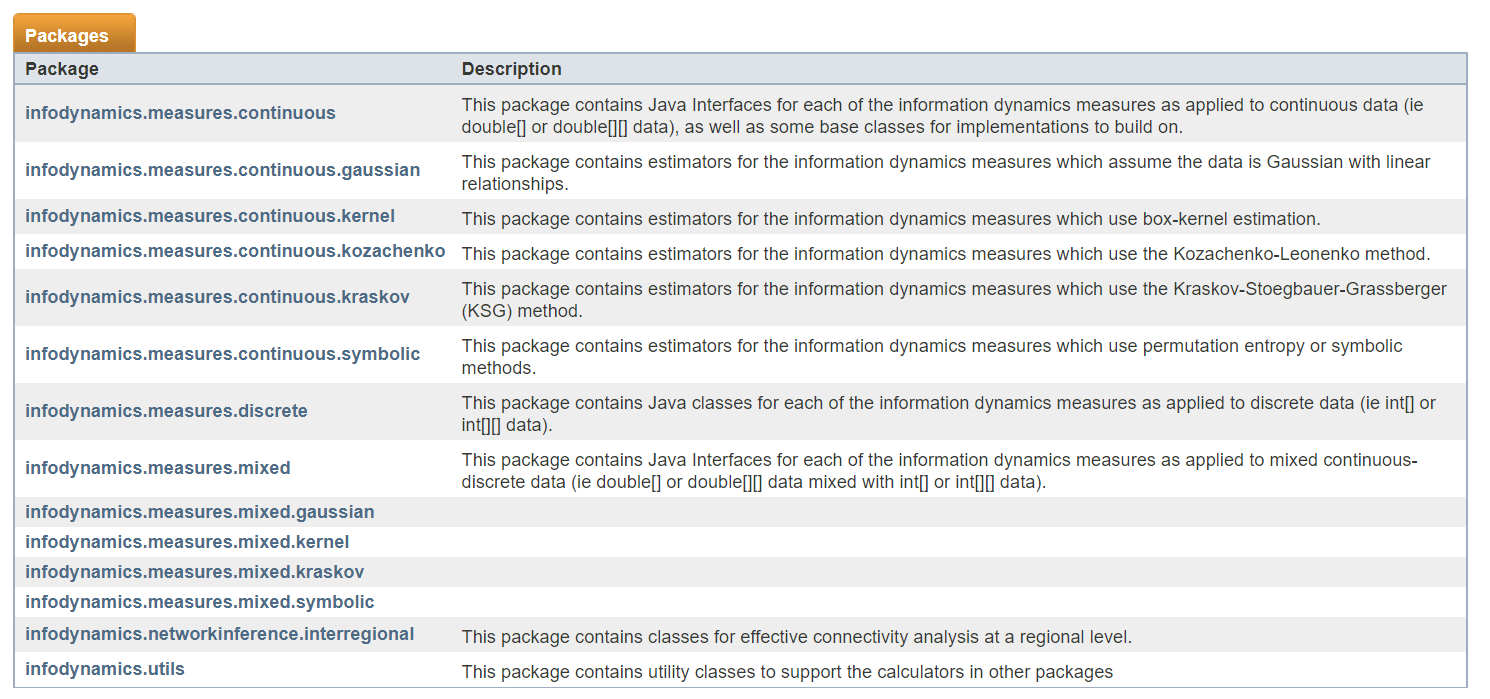
转移熵估计
转移熵估计作者提供了多种估计方法:
- TransferEntropyCalculator
- TransferEntropyCalculatorDiscrete
- TransferEntropyCalculatorGaussian
- TransferEntropyCalculatorKernel
- TransferEntropyCalculatorKernelPlain
- TransferEntropyCalculatorKernelPlainIterators
- TransferEntropyCalculatorKernelSeparate
- TransferEntropyCalculatorKraskov
- TransferEntropyCalculatorMultiVariate
- TransferEntropyCalculatorMultiVariateGaussian
- TransferEntropyCalculatorMultiVariateKernel
- TransferEntropyCalculatorMultiVariateKraskov
- TransferEntropyCalculatorMultiVariateSingleObservationsKernel
- TransferEntropyCalculatorMultiVariateViaCondMutualInfo
- TransferEntropyCalculatorSymbolic
- TransferEntropyCalculatorViaCondMutualInfo
- TransferEntropyCommon
- TransferEntropyKernelCounts
例:TransferEntropyCalculatorMultiVariateKraskov
我们以这个多变量转移熵的ksg估计算子为例来介绍如何使用jidt估计转移熵,首先使用如下代码打开JVM:
import jpype

from jpype import *

try:

    jarLocation = "~/software/infodynamics/infodynamics.jar"

    jpype.startJVM(jpype.getDefaultJVMPath(), "-ea", "-Djava.class.path=" + jarLocation)

except:

    print("JVM  has already started !")
然后安装如下方式,实例化一个计算子:
calcClass = JPackage(

    "infodynamics.measures.continuous.kraskov"

).TransferEntropyCalculatorMultiVariateKraskov

calc = calcClass()
对于其他的估计子,只须替换上面的相应名称即可,具体名称可以查看官方文档,然后我们就可以用这个calc
来搞一些具体计算了哈,先生成一些数据:
start, end = "1996", "1996"

columns = ["Electric_field"]

x = data.loc[start:end, columns].interpolate().values

y = data.loc[start:end, ["Dst"]].interpolate().values

fig, axs = plt.subplots(2, 1, figsize=(6, 4))

axs[0].plot(x, label="Electric_field", color="blue")

axs[0].legend()

axs[1].plot(y, label="Dst", color="red")

axs[1].legend()

plt.show()
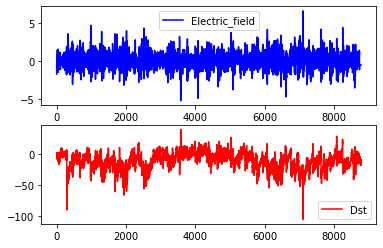
这里使用的是1996年卫星观测的行星际电场数据和磁暴指数Dst数据,注意x和y都是二维矩阵:x.shape=(8784,1); y.shape=(8784,1)
然后设置一些calc的参数:
calc.setProperty("k_HISTORY", str(k_HISTORY))

calc.setProperty("k_TAU", str(k_TAU))

calc.setProperty("l_HISTORY", str(l_HISTORY))

calc.setProperty("l_TAU", str(l_TAU))

calc.setProperty("DELAY", str(DELAY))
注: 这里的DELAY是平常计算转移熵所设置的延迟\(\tau\)
设置好参数之后就可以直接计算了:
m,n = 1,1

calc.initialise(m,n)

calc.setObservations(

    JArray(JDouble, 2)(x), JArray(JDouble, 2)(y)

)

result = calc.computeAverageLocalOfObservations()
由于x和y都是一维变量,所以初始化的时候m和n都设置成1即可,JArray(JDouble, 2)(x)是通过jpype将python中的矩阵转化成java中的数据类型,result即为计算出的转移熵。
如需评估所计算转移熵的重要性,只需要进一步计算p值即可:
sig_num = 100

measDist = calc.computeSignificance(self.sig_num)

mean = (measDist.getMeanOfDistribution(),)

std = (measDist.getStdOfDistribution(),)

pVal = measDist.pValue
这里使用的是替代数据检验法,生成sig_num条与x尺寸相同的随机数据,然后计算到y的转移熵,计算sig_num个统计值的均值、标准差以及相应的p值即可评估上面计算得到的result是否可信。
为避免每次都需要这么设置,可以将上述过程封装成一个类,具体如下:
import os, sys

import numpy as np

import pandas as pd

import matplotlib.pyplot as plt

from pathlib import Path

Path.ls = lambda x: list(x.iterdir())

from tqdm import tqdm

"""

多变量转移熵计算

"""

import os, sys

import numpy as np

import pandas as pd

import jpype

from jpype import *

# mUtils = JPackage("infodynamics.utils").MatrixUtils

class TransferEntropyCalculatorMultiVariateKraskov:

    """

    Description:

    """

    def __init__(

        self,

        source=None,

        destination=None,

        sourceDimensions=2,

        destDimensions=2,

        k_HISTORY=1,

        k_TAU=1,

        l_HISTORY=1,

        l_TAU=1,

        DELAY=1,

        k=4,

        NOISE_LEVEL_TO_ADD=1e-8,

        ALG_NUM=1,

        cal_sig=False,

        sig_num=100,

    ):

        self.source = source

        self.destination = destination

        self.sourceDimensions = sourceDimensions

        self.destDimensions = destDimensions

        self.k_HISTORY = k_HISTORY

        self.k_TAU = k_TAU

        self.l_HISTORY = l_HISTORY

        self.l_TAU = l_TAU

        self.DELAY = DELAY

        self.k = k

        self.cal_sig = cal_sig

        self.sig_num = sig_num

        self.NOISE_LEVEL_TO_ADD = NOISE_LEVEL_TO_ADD

        self.ALG_NUM = ALG_NUM

    def __call__(self, source, destination, tau, m=1, n=1):

        self.source = source

        self.destination = destination

        self.sourceDimensions = np.min(source.shape)

        self.destDimensions = np.min(destination.shape)

        self.DELAY = tau

        calcClass = JPackage(

            "infodynamics.measures.continuous.kraskov"

        ).TransferEntropyCalculatorMultiVariateKraskov

        calc = calcClass()

        calc.setProperty("sourceDimensions", str(self.sourceDimensions))

        calc.setProperty("destDimensions", str(self.destDimensions))

        calc.setProperty("k_HISTORY", str(self.k_HISTORY))

        calc.setProperty("k_TAU", str(self.k_TAU))

        calc.setProperty("l_HISTORY", str(self.l_HISTORY))

        calc.setProperty("l_TAU", str(self.l_TAU))

        calc.setProperty("DELAY", str(self.DELAY))

        calc.setProperty("k", str(self.k))

        calc.setProperty("NOISE_LEVEL_TO_ADD", str(self.NOISE_LEVEL_TO_ADD))

        calc.setProperty("ALG_NUM", str(self.ALG_NUM))

        calc.initialise(m,n)

        self.calc = calc

        self.calc.setObservations(

            JArray(JDouble, 2)(source), JArray(JDouble, 2)(destination)

        )

        result = self.calc.computeAverageLocalOfObservations()

        if not self.cal_sig:

            return result

        else:

            measDist = self.calc.computeSignificance(self.sig_num)

            mean = (measDist.getMeanOfDistribution(),)

            std = (measDist.getStdOfDistribution(),)

            pVal = measDist.pValue

            return result, [mean, std, pVal]

# estimator_ksg = TransferEntropyCalculatorMultiVariateKraskov()
然后计算就很简单了:
# 实例化一个估计子

estimator_ksg = TransferEntropyCalculatorMultiVariateKraskov()

# 生成测试数据

start, end = "1996", "1996"

columns = ["Electric_field"]

x = data.loc[start:end, columns].interpolate().values

y = data.loc[start:end, ["Dst"]].interpolate().values

fig, axs = plt.subplots(2, 1, figsize=(6, 4))

axs[0].plot(x, label="Electric_field", color="blue")

axs[0].legend()

axs[1].plot(y, label="Dst", color="red")

axs[1].legend()

plt.show()

# 计算转移熵结果,并绘制图像

result = []

taus = 168

for tau in tqdm(range(taus)):

    result.append(estimator_ksg(source=x, destination=y, tau=tau))

plt.figure(figsize=(8, 3))

plt.plot(range(taus), result)
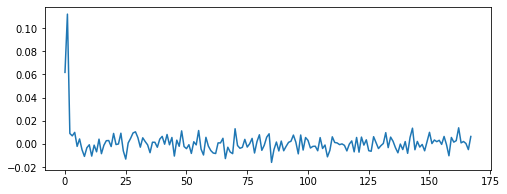
大概几秒之后就计算完毕了,速度还是非常可以的,计算结果如下:
今天的部分到这里就结束了,后期作者会在介绍一下其他方法和信息论度量的计算,并将完整代码总结发布到github上面,敬请关注。
信息论估计工具jidt基本使用的更多相关文章
- 【转载】FPGA功耗的那些事儿
在项目设计初期,基于硬件电源模块的设计考虑,对FPGA设计中的功耗估计是必不可少的. 笔者经历过一个项目,整个系统的功耗达到了100w,而单片FPGA的功耗估计得到为20w左右, 有点过高了,功耗过高 ...
- FPGA功耗那些事儿(转载)
在项目设计初期,基于硬件电源模块的设计考虑,对FPGA设计中的功耗估计是必不可少的.笔者经历过一个项目,整个系统的功耗达到了100w,而单片FPGA的功耗估计得到为20w左右,有点过高了,功耗过高则会 ...
- MMDetection 使用示例:从入门到出门
前言 最近对目标识别感兴趣,想做一些有趣目标识别项目自己玩耍,本来选择的是 YOLOV5 的,但无奈自己使用 YOLOV5 环境训练模型时,不管训练多少次 mAP 指标总是为 0,而其它 pytorc ...
- 【机器学习】ICA 原理以及相关概率论,信息论知识简介
看完了sparse coding,开始看ICA模型,本来ng的教程上面就只有一个简短的介绍,怎奈自己有强迫症,爱钻牛角尖,于是乎就搜索了一些ICA的介绍文章(都是从百度文库中搜来的),看完之后感觉这个 ...
- dll文件32位64位检测工具以及Windows文件夹SysWow64的坑
自从操作系统升级到64位以后,就要不断的需要面对32位.64位的问题.相信有很多人并不是很清楚32位程序与64位程序的区别,以及Program Files (x86),Program Files的区别 ...
- 10个最好用的HTML/CSS 工具、插件和资料库
大家在使用HTML/CSS开发项目的过程中,有使用过哪些工具,插件和库?下面介绍的10种HTML/CSS工具,插件和资料库,是国外程序员经常用到的. Firebug Lite FirebugLite ...
- 使用Oracle官方巡检工具ORAchk巡检数据库
ORAchk概述 ORAchk是Oracle官方出品的Oracle产品健康检查工具,可以从MOS(My Oracle Support)网站上下载,免费使用.这个工具可以检查Oracle数据库,Gold ...
- 【翻译】Awesome R资源大全中文版来了,全球最火的R工具包一网打尽,超过300+工具,还在等什么?
0.前言 虽然很早就知道R被微软收购,也很早知道R在统计分析处理方面很强大,开始一直没有行动过...直到 直到12月初在微软技术大会,看到我软的工程师演示R的使用,我就震惊了,然后最近在网上到处了解和 ...
- 一篇文章看懂TPCx-BB(大数据基准测试工具)源码
TPCx-BB是大数据基准测试工具,它通过模拟零售商的30个应用场景,执行30个查询来衡量基于Hadoop的大数据系统的包括硬件和软件的性能.其中一些场景还用到了机器学习算法(聚类.线性回归等).为了 ...
随机推荐
- 更换介质:请把标有Debian ... 的盘片插入驱动器
Debian安装软件报错如下: 更换介质:请把标有 "Debian GNU/Linux 10.8.0 _Buster_ - Official amd64 DVD Binary-1 20210 ...
- shell初学之nginx(负载均衡)
创建三个以域名区分的网站a.com,b.com,c.com:访问a.b时,分别显示a.b两个网站的内容:访问c时,会出现依次显示两次a网站的内容,一次b网站的内容. 1 #!/bin/bash 2 s ...
- 007.kubernets的headless service配置和ingress的简单配置
前面配置了servcie的nodepoint和clusterIP附在均衡 一 headless service配置 1.1 默认下的DNS配置 [root@docker-server1 deploym ...
- STM32 库函数 延时函数计算
- python3 读取txt文件数据,绘制趋势图,matplotlib模块
python3 读取txt文件数据,绘制趋势图 test1.txt内容如下: 时间/min cpu使用率/% 内存使用率/% 01/12-17:06 0.01 7.61 01/12-17:07 0.0 ...
- 2.5if语句
判断(if)语句 目标 开发中的应用场景 if 语句体验 if 语句进阶 综合应用 01. 开发中的应用场景 生活中的判断几乎是无所不在的,我们每天都在做各种各样的选择,如果这样?如果那样?-- 程序 ...
- 【转载】java与xml
原文地址:http://www.lai18.com/content/1198237.html java项目中,xml文件一般都是用来存储一些配置信息一般的编程, 多数用来存储配置信息 . 拿JDBC来 ...
- 如何屏蔽 iOS 软件自动更新,去除更新通知和标记
适用于 iOS.iPadOS 和 watchOS,即 iPhone.iPad 和 Apple Watch 通用. 请访问原文链接:https://sysin.org/article/Disable-i ...
- VMware vRealize Network Insight 6.2 发布 - 网络和安全可视化分析
发现.优化应用安全性和网络连接解决方案并对其进行故障排除 VMware vRealize Network Insight 可帮助您跨混合和多云环境构建经过优化且高度可用的安全网络基础架构.它提供了网络 ...
- SpringBoot基础学习(三) 自定义配置、随机数设置及参数间引用
自定义配置 SpringBoot免除了项目中大部分手动配置,可以说,几乎所有的配置都可以写在全局配置文件application.peroperties中,SpringBoot会自动加载全局配置文件从而 ...