
爬虫_中国天气网_文字天气预报(xpath)
 import requests

 from lxml import etree

 headers = 'Mozilla/5.0 (Windows NT 10.0; WOW64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/65.0.3325.181 Safari/537.36'

 def get_html(url):

     try:

         html = requests.get(url, headers={'User-Agent':'headers'})

         html.encoding = html.apparent_encoding

         if html.status_code == 200:

             return html.text

         return 0

     except RequestsException:

         return 0

 '''

 conMintab:  华北

     conMintab2    北京

     conMintab2    天津

     conMintab2    河北

     conMintab2    山西

     conMintab2    内蒙古

 //div[@class="conMidtab"][1] 今天

 //div[@class="conMidtab"][2] 明天

                 ...

 //div[@class="conMidtab"][7] 最后一天

 '''

 def parse_html(html):

     wea = []

     html_element = etree.HTML(html)

     # !!!!!  trs = html_element.xpath('//div[@class="conMidtab"][1]//tr')[2:]

     provinces = html_element.xpath('//div[@class="conMidtab"][1]//div[@class="conMidtab2"]')

     for province in provinces:

         trs = province.xpath('.//tr')[2:]

         for tr in trs:

             weather = {}

             city = tr.xpath('.//td[@width="83"]/a/text()')

             phenomenon = tr.xpath('.//td[@width="89"]/text()')

             wind = tr.xpath('.//td[@width="162"]//text()')

             hightest = tr.xpath('.//td[@width="92"]/text()')

             weather['city'] = city

             weather['phenomenon'] = phenomenon

             weather['wind'] = wind

             weather['hightest'] = hightest

             while '\n' in wind:

                 wind.remove('\n')

             wea.append(weather)

     print(wea)

 def main():

     urls = ['http://www.weather.com.cn/textFC/hb.shtml',

             'http://www.weather.com.cn/textFC/db.shtml',

             'http://www.weather.com.cn/textFC/hd.shtml',

             'http://www.weather.com.cn/textFC/hz.shtml',

             'http://www.weather.com.cn/textFC/hn.shtml',

             'http://www.weather.com.cn/textFC/xb.shtml',

             'http://www.weather.com.cn/textFC/xn.shtml',

             'http://www.weather.com.cn/textFC/gat.shtml']

     for url in urls:

         html = get_html(url)

         if html == 0:

             html = get_html(url)

         parse_html(html)

 if __name__ == '__main__':

         main()
。。港澳台的格式不太一样,暂时不想管他们了
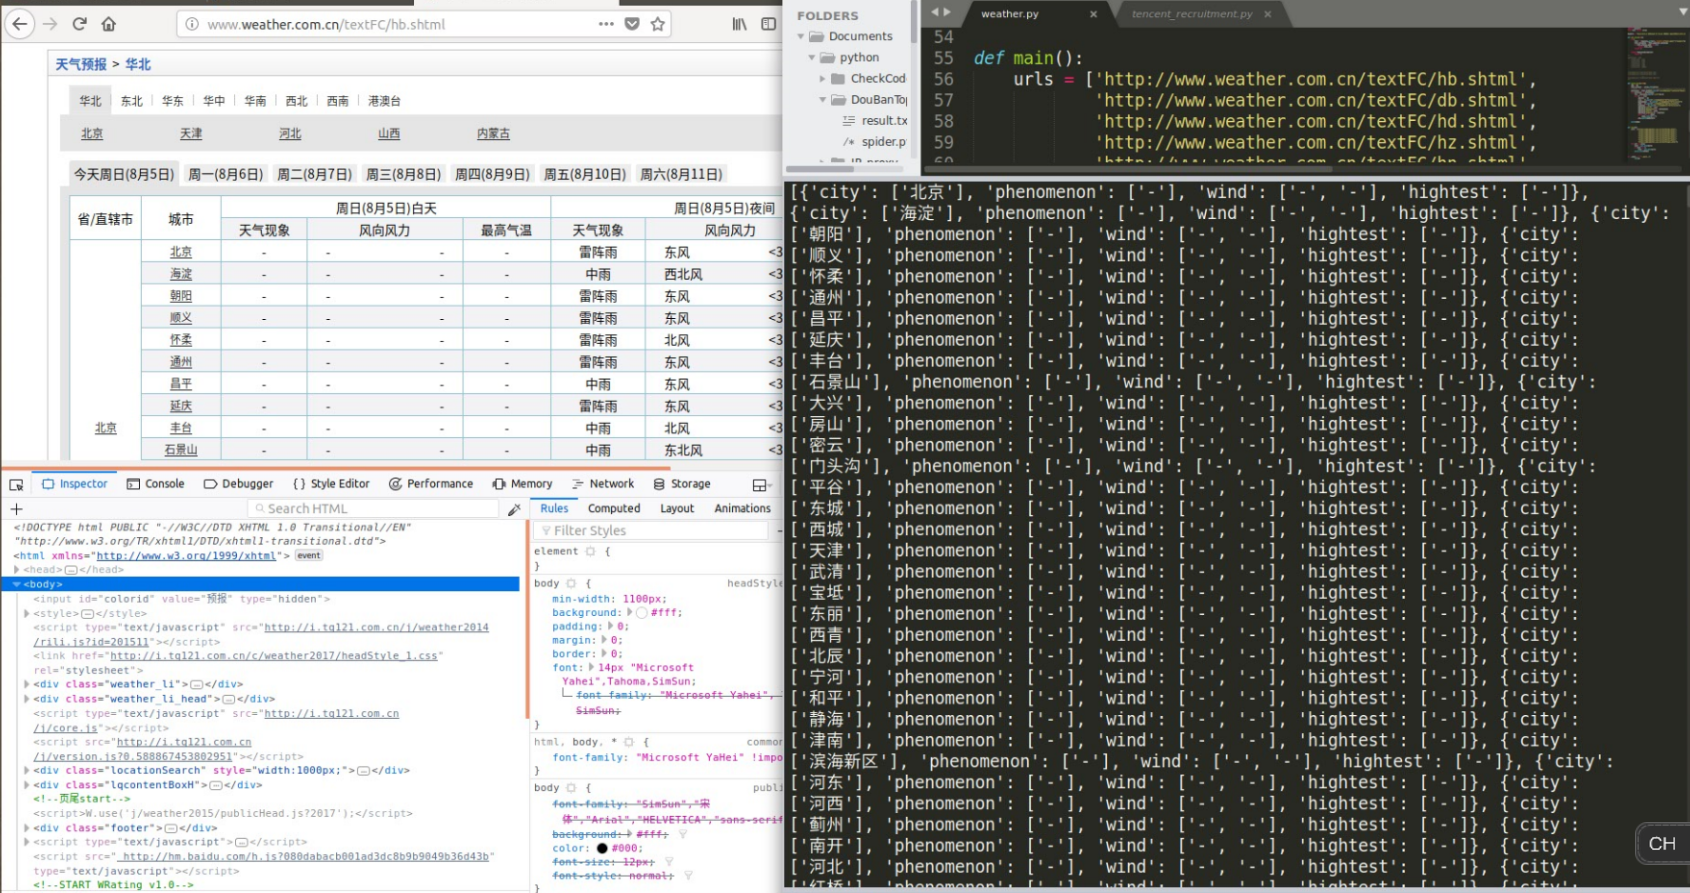
。。运行结果的话,我爬取得是当日白天的天气,现在晚上了,数据都没有了(一开始还以为是代码改错了,还一直撤销)
爬虫_中国天气网_文字天气预报(xpath)的更多相关文章
- 微信小程序_(案例)简单中国天气网首页
Demo:简单中国天气网首页 Page({ data:{ name:"CynicalGary", temp:"4", low:"-1°C", ...
- 爬虫-通过本地IP地址从中国天气网爬取当前城市天气情况
1.问题描述 最近在做一个pyqt登录校园网的小项目,想在窗口的状态栏加上当天的天气情况,用爬虫可以很好的解决我的问题. 2.解决思路 考虑到所处位置的不同,需要先获取本地城市地址,然后作为中 ...
- 轻奢当道业绩逆势增长 Kate Spade联手韩国衣恋开拓中国市场_商场报道_中国时尚品牌网
轻奢当道业绩逆势增长 Kate Spade联手韩国衣恋开拓中国市场_商场报道_中国时尚品牌网 轻奢当道业绩逆势增长 Kate Spade联手韩国衣恋开拓中国市场
- 孙弘与Masa Maso 做互联网最贵的衬衫(2)_人物对话_中国时尚品牌网
孙弘与Masa Maso 做互联网最贵的衬衫(2)_人物对话_中国时尚品牌网 孙弘与Masa Maso 做互联网最贵的衬衫(2)
- 中国天气网-天气预报接口api
中国天气网地址:http://www.weather.com.cn 请求服务 : 查询实时天气信息 http://www.weather.com.cn/data/sk/101110101.html 在 ...
- 天气预报接口api(中国天气网)
中国天气weather.comhttp://m.weather.com.cn/data/101110101.html(六天预报) http://www.weather.com.cn/data/sk/1 ...
- C#获取中国天气网免费天气预报信息
中国天气网接口地址:”http://wthrcdn.etouch.cn/WeatherApi?citykey=” + weatherCityCode(为城市code); 下面是转化过程中我们需要用到的 ...
- 初识python 之 爬虫:爬取中国天气网数据
用到模块: 获取网页并解析:import requests,html5lib from bs4 import BeautifulSoup 使用pyecharts的Bar可视化工具"绘制图表& ...
- 中国天气网API接口
http://www.weather.com.cn/data/sk/101010100.html http://www.weather.com.cn/data/cityinfo/101010100.h ...
随机推荐
- Python_装饰器复习_30
复习: # 装饰器的进阶 # functools.wraps # 带参数的装饰器 # 多个装饰器装饰同一个函数# 周末的作业 # 文件操作 # 字符串处理 # 输入输出 # 流程控制 # 装饰器# 开 ...
- H5 69-清除浮动方式四
<!DOCTYPE html> <html lang="en"> <head> <meta charset="UTF-8&quo ...
- Python-面向对象简介
面向对象介绍 学习面向对象过程中会遇到一些名词,我们先解释下 名词解释 类:一个类即是对一类拥有相同属性的对象的抽象.蓝图.原型.模板.在类中定义了这些对象的都具备的属性(variables(data ...
- springboot在yml中配置控制台sql打印方法小结
方法一: logging: level: debug level.io.renren: debug path: logs/ file: admin.log 方法二 logging: leve ...
- 使用Dockerfile来构建镜像
Dockerfile原理 创建Dockerfile Dockerfile实例 Dockerfile指令 注释 FROM MAINTAINER RUN ADD WORKDIR ENV USER COPY ...
- Go To Oracle
1.下载mingw (gcc 编译)---win32 2.下载OCI最新版,存放于C:\instantclient_12_1 ---win32 3.下载OCI SDK最新版,存放于C:\ins ...
- taro 与uni-app对比
https://www.jianshu.com/p/03e08399587e (copy)
- embed标签的flash层级太高问题
因为客户要求,项目得兼容IE的兼容模式 页面到了flash都会遮挡底部悬浮的导航. 改变浮动窗口和embed的层级还是不可以.应该不是层级的关系. 最后百度解决方案:在embed标签内添加了wmode ...
- 使用Elasticsearch 出现的拒绝连接
pom 文件 spring: elasticsearch: jest: uris: http://192.168.124.142:9201 # data: # elasticsearch: # clu ...
- Excel文件读取的两种方式
1.Pandas库的读取操作 from pandas import read_excel dr=read_excel(filename,header) dr#dataframe数据 dw=DataFr ...