
java数据结构分析
java数据结构分析
此文章内容参考于:http://www.cnblogs.com/ysocean/
一.数据结构总览图
1.数组
2.链表
3.栈
4.队列
5.二叉树
6.堆
7.散列
8.红黑树
二.结构分析
1.数组
数组是所有数据结构的'鼻祖';它可以表示一切的数据类型,但是后面会介绍很多其他的数据结构,就是因为数组还有许多局限性:
①、插入快,对于无序数组,即元素没有按照从大到小或者某个特定的顺序排列,只是按照插入的顺序排列。无序数组增加一个元素很简单,只需要在数组末尾添加元素即可,但是有序数组却不一定了,它需要在指定的位置插入。
②、查找慢,当然如果根据下标来查找是很快的。但是通常我们都是根据元素值来查找,给定一个元素值,对于无序数组,我们需要从数组第一个元素开始遍历,直到找到那个元素。有序数组通过特定的算法查找的速度会比无需数组快,后面我们会讲各种排序算法。
③、删除慢,根据元素值删除,我们要先找到该元素所处的位置,然后将元素后面的值整体向前面移动一个位置。也需要比较多的时间。
④、数组一旦创建后,大小就固定了,不能动态扩展数组的元素个数。如果初始化你给一个很大的数组大小,那会白白浪费内存空间,如果给小了,后面数据个数增加了又添加不进去了。
很显然,数组虽然插入快,但是查找和删除都比较慢,而且扩展性差,所以我们一般不会用数组来存储数据,那有没有什么数据结构插入、查找、删除都很快,而且还能动态扩展存储个数大小呢,答案是有的,但是这是建立在很复杂的算法基础上,后面我们也会详细讲解。
2.链表(单向链表、双端链表、有序链表、双向链表)
链表: 链表通常由一连串节点组成,每个节点包含任意的实例数据(data fields)和一或两个用来指向上一个/或下一个节点的位置的链接("links")
是一种常见的基础数据结构,是一种线性表,但是并不会按线性的顺序存储数据,而是在每一个节点里存到下一个节点的指针(Pointer)。
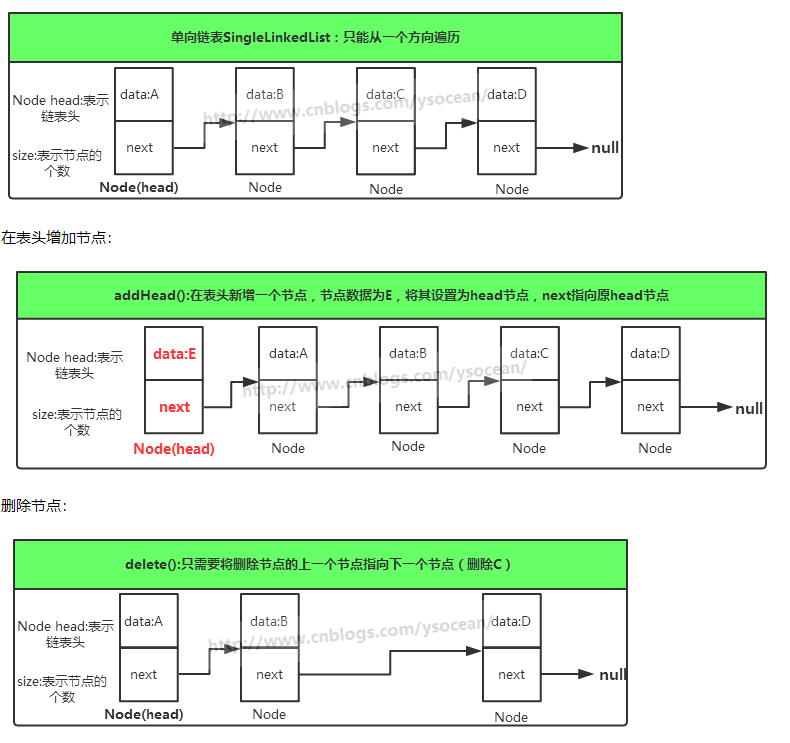
单链表是链表中结构最简单的。一个单链表的节点(Node)分为两个部分,第一个部分(data)保存或者显示关于节点的信息,另一个部分存储下一个节点的地址。最后一个节点存储地址的部分指向空值。
单向链表只可向一个方向遍历,一般查找一个节点的时候需要从第一个节点开始每次访问下一个节点,一直访问到需要的位置。而插入一个节点,对于单向链表,我们只提供在链表头插入,只需要将当前插入的节点设置为头节点,next指向原头节点即可。删除一个 节点,我们将该节点的上一个节点的next指向该节点的下一个节点。
有序列表
有序列表是:前面的链表实现插入数据都是无序的,在有些应用中需要链表中的数据有序,这称为有序链表。
双向链表
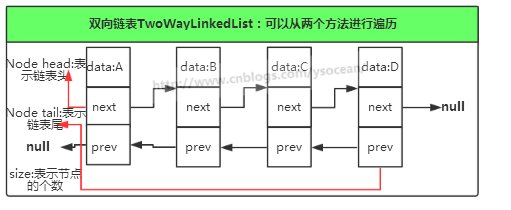
双向链表它可以从两个方向遍历。
链表的具体实现:比如说linkList,就是采用的是链表结构,而对应的arrayList是采用的数组结构方式.
linkList适合插入和删除的场景,而arrayList适合查询.
linkList一般就作为堆栈和队列的底层实现,
3.栈
栈基本概念:
栈(英语:stack)又称为堆栈或堆叠,栈作为一种数据结构,是一种只能在一端进行插入和删除操作的特殊线性表。它按照先进后出的原则存储数据,先进入的数据被压入栈底,最后的数据在栈顶,需要读数据的时候从栈顶开始弹
出数据(最后一个数据被第一个读出来)。栈具有记忆作用,对栈的插入与删除操作中,不需要改变栈底指针。
栈的图:

栈是一个概念上的工具,具体能实现什么功能可以由我们去想象。栈通过提供限制性的访问方法push()和pop(),使得程序不容易出错。
对于栈的实现,我们稍微分析就知道,数据入栈和出栈的时间复杂度都为O(1),也就是说栈操作所耗的时间不依赖栈中数据项的个数,因此操作时间很短。而且需要注意的是栈不需要比较和移动操作,我们不要画蛇添足。
4.队列
队列和栈在概念上很相近,都是一个概念性的结构,不会像数组一样作为数据存储功能.栈是后进先出,而队列刚好相反,是先进先出。
通过前面讲的栈以及本篇讲的队列这两种数据结构,我们稍微总结一下:
①、栈、队列(单向队列)、优先级队列通常是用来简化某些程序操作的数据结构,而不是主要作为存储数据的。
②、在这些数据结构中,只有一个数据项可以被访问。
③、栈允许在栈顶压入(插入)数据,在栈顶弹出(移除)数据,但是只能访问最后一个插入的数据项,也就是栈顶元素。
④、队列(单向队列)只能在队尾插入数据,对头删除数据,并且只能访问对头的数据。而且队列还可以实现循环队列,它基于数组,数组下标可以从数组末端绕回到数组的开始位置。
⑤、优先级队列是有序的插入数据,并且只能访问当前元素中优先级别最大(或最小)的元素。
⑥、这些数据结构都能由数组实现,但是可以用别的机制(后面讲的链表、堆等数据结构)实现。
5.二叉树
前面我们介绍数组的数据结构,我们知道对于有序数组,查找很快,并介绍可以通过二分法查找,但是想要在有序数组中插入一个数据项,就必须先找到插入数据项的位置,然后将所有插入位置后面的数据项全部向后移动一位,
来给新数据腾出空间,平均来讲要移 动N/2 次,这是很费时的。同理,删除数据也是。
然后我们介绍了另外一种数据结构——链表,链表的插入和删除很快,我们只需要改变一些引用值就行了,但是查找数据却很慢了,因为不管我们查找什么数据,都需要从链表的第一个数据项开始,遍历到找到所需数据项为止,这个查找也是平均需要比较N/2次。
那么我们就希望一种数据结构能同时具备数组查找快的优点以及链表插入和删除快的优点,于是 树 诞生了。
二叉树:树的每个节点最多只能有两个子节点.
二叉树的效率:
从前面的大部分对树的操作来看,都需要从根节点到下一层一层的查找。
一颗满树,每层节点数大概为2n-1,那么最底层的节点个数比树的其它节点数多1,因此,查找、插入或删除节点的操作大约有一半都需要找到底层的节点,另外四分之一的节点在倒数第二层,依次类推。
总共N层共有2n-1个节点,那么时间复杂度为O(logn),底数为2。
在有1000000 个数据项的无序数组和链表中,查找数据项平均会比较500000 次,但是在有1000000个节点的二叉树中,只需要20次或更少的比较即可。
有序数组可以很快的找到数据项,但是插入数据项的平均需要移动 500000 次数据项,在 1000000 个节点的二叉树中插入数据项需要20次或更少比较,在加上很短的时间来连接数据项。
同样,从 1000000 个数据项的数组中删除一个数据项平均需要移动 500000 个数据项,而在 1000000 个节点的二叉树中删除节点只需要20次或更少的次数来找到他,然后在花一点时间来找到它的后继节点,一点时间来断开节点以及连接后继节点。
所以,树对所有常用数据结构的操作都有很高的效率。
遍历可能不如其他操作快,但是在大型数据库中,遍历是很少使用的操作,它更常用于程序中的辅助算法来解析算术或其它表达式。
二叉树总结:
树是由边和节点构成,根节点是树最顶端的节点,它没有父节点;二叉树中,最多有两个子节点;某个节点的左子树每个节点都比该节点的关键字值小,右子树的每个节点都比该节点的关键字值大,那么这种树称为二叉搜索树,其查找、插入、删除的时间复杂度都为logN;
可以通过前序遍历、中序遍历、后序遍历来遍历树,前序是根节点-左子树-右子树,中序是左子树-根节点-右子树,后序是左子树-右子树-根节点;删除一个节点只需要断开指向它的引用即可;
哈夫曼树是二叉树,用于数据压缩算法,最经常出现的字符编码位数最少,很少出现的字符编码位数多一些。
6.堆
堆,注意这里的堆和我们Java语言,C++语言等编程语言在内存中的“堆”是不一样的,这里的堆是一种树,由它实现的优先级队列的插入和删除的时间复杂度都为O(logN),这样尽管删除的时间变慢了,
但是插入的时间快了很多,当速度非常重要,而且有很多插入操作时,可以选择用堆来实现优先级队列。
7.散列(hash)
Hash表也称散列表,也有直接译作哈希表,Hash表是一种根据关键字值(key - value)而直接进行访问的数据结构。它基于数组,通过把关键字映射到数组的某个下标来加快查找速度,
但是又和数组、链表、树等数据结构不同,在这些数据结构中查找某个关键字,通常要遍历整个数据结构,也就是O(N)的时间级,但是对于哈希表来说,只是O(1)的时间级。
散列表基于数组,类似于key-value的存储形式,关键字值通过哈希函数映射为数组的下标,如果一个关键字哈希化到已占用的数组单元,这种情况称为冲突。用来解决冲突的有两种方法:开放地址法和链地址法。
在开发地址法中,把冲突的数据项放在数组的其它位置;在链地址法中,每个单元都包含一个链表,把所有映射到同一数组下标的数据项都插入到这个链表中。
8.红黑树
背景
二叉搜索树对于某个节点而言,其左子树的节点关键值都小于该节点关键值,右子树的所有节点关键值都大于该节点关键值。二叉搜索树作为一种数据结构,其查找、插入和删除操作的时间复杂度都为O(logn),底数为2。
但是我们说这个时间复杂度是在平衡的二叉搜索树上体现的,也就是如果插入的数据是随机的,则效率很高,但是如果插入的数据是有序的,比如从小到大的顺序【10,20,30,40,50】插入到二叉搜索树中:
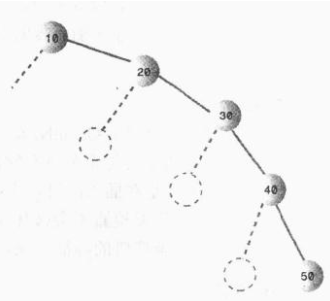
从大到小就是全部在左边,这和链表没有任何区别了,这种情况下查找的时间复杂度为O(N),而不是O(logN)。当然这是在最不平衡的条件下,实际情况下,二叉搜索树的效率应该在O(N)和O(logN)之间,这取决于树的不平衡程度。
那么为了能够以较快的时间O(logN)来搜索一棵树,我们需要保证树总是平衡的(或者大部分是平衡的),也就是说每个节点的左子树节点个数和右子树节点个数尽量相等。红-黑树的就是这样的一棵平衡树,对一个要插入的数据项(删除也是),
插入例程要检查会不会破坏树的特征,如果破坏了,程序就会进行纠正,根据需要改变树的结构,从而保持树的平衡。
红-黑树的特征
有如下两个特征:
①、节点都有颜色;
②、在插入和删除的过程中,要遵循保持这些颜色的不同排列规则。
第一个很好理解,在红-黑树中,每个节点的颜色或者是黑色或者是红色的。当然也可以是任意别的两种颜色,这里的颜色用于标记,我们可以在节点类Node中增加一个boolean型变量isRed,以此来表示颜色的信息。
第二点,在插入或者删除一个节点时,必须要遵守的规则称为红-黑规则:
1.每个节点不是红色就是黑色的;
2.根节点总是黑色的;
3.如果节点是红色的,则它的子节点必须是黑色的(反之不一定),(也就是从每个叶子到根的所有路径上不能有两个连续的红色节点);
4.从根节点到叶节点或空子节点的每条路径,必须包含相同数目的黑色节点(即相同的黑色高度)。
从根节点到叶节点的路径上的黑色节点的数目称为黑色高度,规则 4 另一种表示就是从根到叶节点路径上的黑色高度必须相同。
注意:新插入的节点颜色总是红色的,这是因为插入一个红色节点比插入一个黑色节点违背红-黑规则的可能性更小,原因是插入黑色节点总会改变黑色高度(违背规则4),
但是插入红色节点只有一半的机会会违背规则3(因为父节点是黑色的没事,父节点是红色的就违背规则3)。另外违背规则3比违背规则4要更容易修正。当插入一个新的节点时,可能会破坏这种平衡性,那么红-黑树是如何修正的呢?
红黑树的自我修正
红-黑树主要通过三种方式对平衡进行修正,改变节点颜色、左旋和右旋。
①、改变节点颜色
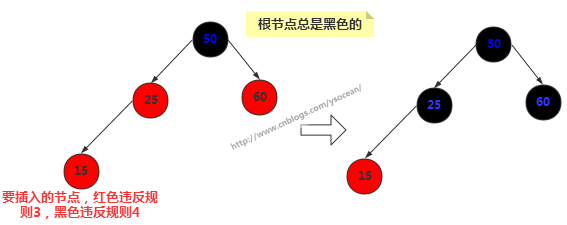
新插入的节点为15,一般新插入颜色都为红色,那么我们发现直接插入会违反规则3,改为黑色却发现违反规则4。这时候我们将其父节点颜色改为黑色,父节点的兄弟节点颜色也改为黑色。通常其祖父节点50颜色会由黑色变为红色,但是由于50是根节点,所以我们这里不能改变根节点颜色。
②、右旋
首先要说明的是节点本身是不会旋转的,旋转改变的是节点之间的关系,选择一个节点作为旋转的顶端,如果做一次右旋,这个顶端节点会向下和向右移动到它右子节点的位置,它的左子节点会上移到它原来的位置。右旋的顶端节点必须要有左子节点。
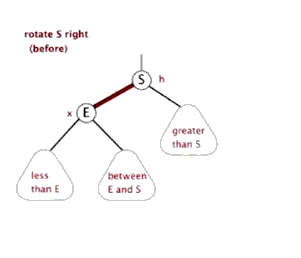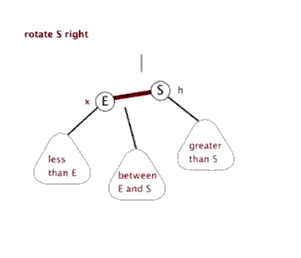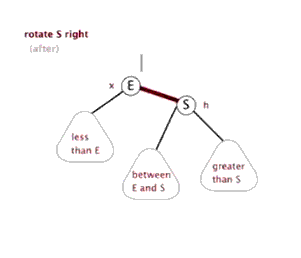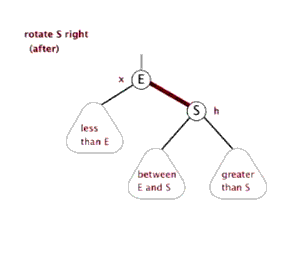
③、左旋
左旋的顶端节点必须要有右子节点。
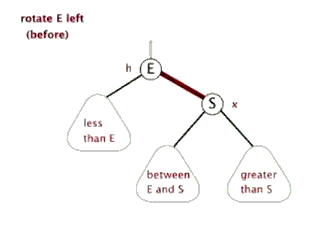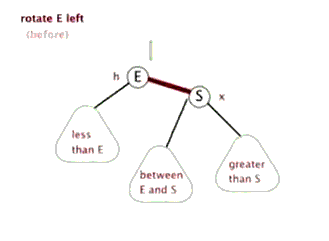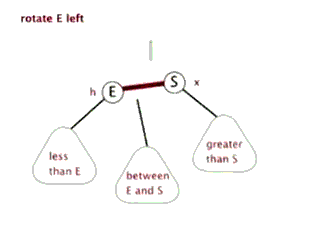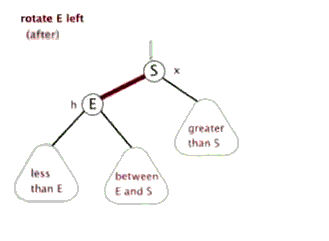
注意:我们改变颜色也是为了帮助我们判断何时执行什么旋转,而旋转是为了保证树的平衡。光改变节点颜色是不能起到任何作用的,旋转才是关键的操作,在新增节点或者删除节点之后,可能会破坏二叉树的平衡,那么何时执行旋转以及执行什么旋转,这是我们需要重点关注的。
红黑树的效率
红黑树的查找、插入和删除时间复杂度都为O(log2N),额外的开销是每个节点的存储空间都稍微增加了一点,因为一个存储红黑树节点的颜色变量。插入和删除的时间要增加一个常数因子,因为要进行旋转,平均一次插入大约需要一次旋转,因此插入的时间复杂度还是O(log2N),
(时间复杂度的计算要省略常数),但实际上比普通的二叉树是要慢的。
大多数应用中,查找的次数比插入和删除的次数多,所以应用红黑树取代普通的二叉搜索树总体上不会有太多的时间开销。而且红黑树的优点是对于有序数据的操作不会慢到O(N)的时间复杂度。
java数据结构分析的更多相关文章
- redis数据结构分析 (redisObject、SDS)
redis是一个key-value储存系统.和Memcached类似,它支持存储的value类型相对更多,包括string(字符串).list(链表).set(集合).zset(sorted set ...
- JSONObject.fromObject(map)(JSON与JAVA数据的转换)
JSON与JAVA数据的转换(JSON 即 JavaScript Object Natation,它是一种轻量级的数据交换格式,非常适合于服务器与 JavaScript 的交互.) 上一篇文章中有这么 ...
- 关于JAVA数据储存
关于JAVA数据储存: 在JAVA中,有六个不同的地方可以存储数据: 1. 寄存器(register) 这是最快的存储区,因为它位于不同于其他存储区的地方--处理器内部.但是寄存器的数量极其有限,所以 ...
- Java数据类型和MySql数据类型对应一览
类型名称 显示长度 数据库类型 JAVA类型 JDBC类型索引(int) 描述 VARCHAR L+N VARCHAR java.lang.String 12 CHAR N ...
- 转载:JSONObject.fromObject(map)(JSON与JAVA数据的转换)
转载网址:http://blog.sina.com.cn/s/blog_821025b70100wh6v.html JSON与JAVA数据的转换(JSON 即 JavaScript Object Na ...
- Java数据类型转换浅析
Java数据类型转换分为两种:自动类型转换和强制类型转换. 数据类型转换的关键是数据类型相应的表数范围大小 1.自动类型转换: 概念:小范围数据类型会自动转化成大范围数据类型 实例: int a=10 ...
- Java数据解析之JSON
文章大纲 一.JSON介绍二.常见框架介绍与实战三.Studio中GsonFormat插件使用四.项目源码下载(含参考资料)五.参考文档 一.JSON介绍 1. 简介 JSON 的全称是 Ja ...
- Java数据解析---JSON
一.Java数据解析分为:XML解析和JSON解析 XML解析即是对XML文件中的数据解析,而JSON解析即对规定形式的数据解析,比XML解析更加方便 JSON解析基于两种结构: 1.键值对类型 { ...
- java 数据的存储
1. 寄存器. 这是最快的存储区,因为它位于不同于其他存储区的地方 -- 处理器的内部.但是寄存器的数量极其有限,所以寄存器根据需求进行分配.你不能直接控制,也不能在程序中感觉到寄存器存在的任何迹象. ...
随机推荐
- gmer ver2.1.19357
gmer是一款来自 波兰 的多功能安全监控分析程序.它可以结束除了System和System Idle Process以外几乎所有的进程,还可以查看被隐藏的进程,服务以及驱动(以红色的方式显示此进程. ...
- The type 'System.Object' is defined in an assembly that is not referenced
记录一个错误,报 The type 'System.Object' is defined in an assembly that is not referenced,[System.Runtime] ...
- tomcat安装启动之后localhost:8080页面进不去,提示错误500
具体的错误展示页面如下: 首先,需要考虑到是不是安装的tomcat版本和自己安装的jdk的版本一致,如果不一致,建议将tomcat换成和jdk一致或者高于jdk版本的tomcat版本.(比如安装的jd ...
- nginx mac
==> nginx Docroot is: /usr/local/var/www The default port has been set in /usr/local/etc/nginx/ng ...
- vue中提交表单后如何清空
只需要在提交方法里写上this.form={brand_right:0}即可.
- 如何使用cloudflare的CDN加速网站隐藏网站IP
原文:http://www.safecdn.cn/contact-zh/2018/12/cloudflare-cdn/1146.html 高防CDN:https://www.safeidc.cn/cd ...
- orcal -对表的操作
设计表 varchar2(n) number(n,m)整数:n-m,小数m DATE 日期 CLOB 大文本 BLOB二进制 创建表=============== create table membe ...
- Python爬虫与数据分析之进阶教程:文件操作、lambda表达式、递归、yield生成器
专栏目录: Python爬虫与数据分析之python教学视频.python源码分享,python Python爬虫与数据分析之基础教程:Python的语法.字典.元组.列表 Python爬虫与数据分析 ...
- VUE页面渲染问题
<!DOCTYPE html> <html> <head> <script src="./vue.min.js"></scri ...
- Linux 添加中文字体库,解决Java 生成中文水印不显示问题
本机 Windows 环境测试以下代码生成中文水印完全没问题,但是发布到Linux下不显示,一开始以为是报错了没打印出来,搜索发现直接提示中文乱码的或者不显示的,才明白原来是字体库原因,于是开始解决这 ...