
04 Beautiful Soup
Beautiful Soup
简介
简单来说,Beautiful Soup是python的一个库,最主要的功能是从网页抓取数据。官方解释如下:
'''

Beautiful Soup提供一些简单的、python式的函数用来处理导航、搜索、修改分析树等功能。

它是一个工具箱,通过解析文档为用户提供需要抓取的数据,因为简单,所以不需要多少代码就可以写出一个完整的应用程序。

'''
Beautiful Soup 是一个可以从HTML或XML文件中提取数据的Python库.它能够通过你喜欢的转换器实现惯用的文档导航,查找,修改文档的方式.Beautiful Soup会帮你节省数小时甚至数天的工作时间.你可能在寻找 Beautiful Soup3 的文档,Beautiful Soup 3 目前已经停止开发,官网推荐在现在的项目中使用Beautiful Soup 4。
安装
pip install beautifulsoup4
解析器
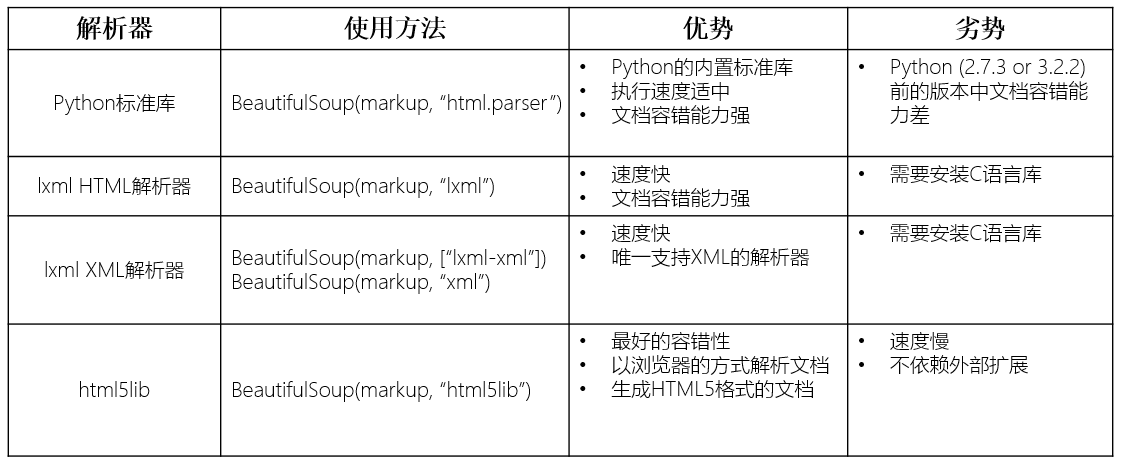
Beautiful Soup支持Python标准库中的HTML解析器,还支持一些第三方的解析器,如果我们不安装它,则 Python 会使用 Python默认的解析器
lxml 解析器更加强大,速度更快,推荐安装。
pip install lxml
另一个可供选择的解析器是纯Python实现的 html5lib , html5lib的解析方式与浏览器相同,可以选择下列方法来安装html5lib:
pip install html5lib
解析器对比:
BeautifulSoup使用
BS导入
1. 导包:from bs4 import BeautifulSoup

2. 可以将一个html文档,转化为BeautifulSoup对象,然后通过对象的方法或者属性去查找指定的节点内容

    2.1 本地文件:soup = BeautifulSoup(open('本地文件'), 'lxml')

    2.2 网络数据:soup = BeautifulSoup('字符串类型或者字节类型', 'lxml')
属性
<1>根据标签名查找

        - soup.a   只能找到第一个符合要求的标签,返回标签


<2>获取属性

        - soup.a.attrs  返回一个字典,获取a所有的属性和属性值

        - soup.a.attrs['href']   获取href属性

        - soup.a['href']   也可简写为这种形式


<3>获取内容

        - soup.a.string

        - soup.a.text

        - soup.a.get_text()    与text无区别

       【注意】如果标签还有标签,那么string获取到的结果为None,而其它两个,可以获取文本内容


<4>find:找到第一个符合要求的标签

        - soup.find('a')  找到第一个符合要求的

        - soup.find('a', title="xxx")

        - soup.find('a', alt="xxx")

        - soup.find('a', class_="xxx")

        - soup.find('a', id="xxx")


<5>find_all:找到所有符合要求的标签

        - soup.find_all('a')

        - soup.find_all(['a','b']) 找到所有的a和b标签

        - soup.find_all('a', limit=2)  限制前两个


<6>根据选择器选择指定的内容

               select:soup.select('#feng')

        - 常见的选择器:标签选择器(a)、类选择器(.)、id选择器(#)、层级选择器

            - 层级选择器:

                div .dudu #lala .meme .xixi  下面好多级

                div > p > a > .lala          只能是下面一级

        【注意】select选择器返回永远是列表,需要通过下标提取指定的对象
方法
doc = """

<html><head><title>The Dormouse's story</title></head>

<body>

<p id="my p" class="title"><b id="bbb" class="boldest">The Dormouse's story</b>

</p>

<p class="story">Once upon a time there were three little sisters; and their names were

<a href="http://example.com/elsie" class="sister" id="link1">Elsie</a>,

<a href="http://example.com/lacie" class="sister" id="link2">Lacie</a> and

<a href="http://example.com/tillie" class="sister" id="link3">Tillie</a>;

and they lived at the bottom of a well.</p>

<p class="story">...</p>

"""
测试数据
find_all()
- 找到所有符合要求的标签
- 返回一个列表
- find_all(name=None, attrs={}, recursive=True, text=None,limit=None, **kwargs)
1 name
五种过滤器:字符串、正则表达式、列表、True和方法
# 字符串:即标签名

print(soup.find_all('b'))  # [<b class="boldest" id="bbb">The Dormouse's story</b>]

# 正则表达式

print(soup.find_all(re.compile("^b")))  # 找出b开头的标签,结果有body和b标签

# 列表:如果传入列表参数,BeautifulSoup会与列表中任一元素匹配的内容返回

print(soup.find_all(['a', 'b']))  # 找到文档中所有<a>标签和<b>标签

# True: 可以匹配任何值

print(soup.find_all(True))  # 找出所有的tag

for tag in soup.find_all(True):

    print(tag.name)             # html head title body p b p a a a p

# 方法: 如果没有合适过滤器,可以定义一个方法,方法只接受一个元素参数,如果这个方法返回True, 表示当前元素匹配并且被找到,如果不是则返回False

def has_class_but_no_id(tag):

    return tag.has_attr('class') and not tag.has_attr('id')

print(soup.find_all(has_class_but_no_id))
2 按照类名查找
class关键字为class_, class_=value,value可以是五种选择器之一
print(soup.find_all('a', class_='sister'))  # 查找class为sister的a标签

print(soup.find_all('a', id='link3'))  # 查找id为link3的a标签
3 attrs
print(soup.find_all('p', attrs={'class': 'story'})) # 查找class为story的p标签
4 text
值可以是字符、列表、True和正则
print(soup.find_all(text='Elsie'))  # ['Elsie']

print(soup.find_all('a', text='Elsie'))  # [<a class="sister" href="http://example.com/elsie" id="link1">Elsie</a>]
5 limit
限制返回结果的数量
print(soup.find_all('a', limit=2))
6 recursive
默认为True,即搜索当前tag的所有子孙节点,如果只想搜索tag的直接子节点,可以使用参数recursive=False
print(soup.html.find_all('a'))

# 局部查找

print(soup.html.find_all('a', recursive=False))
find()
- find()参数与和find_all完全一样
- soup.find('a') 等同于soup.a,只能找到每一个符合要求的标签
selector选择器
selector等同于css选择器
返回列表
print(soup.select('.sister'))  # 查找class为sister的标签

print(soup.select("#link2"))  # 查找id为link2的标签

print(soup.select('.c1 a'))  # 查找class为c1标签下的a标签
04 Beautiful Soup的更多相关文章
- 使用Beautiful Soup编写一个爬虫 系列随笔汇总
这几篇博文只是为了记录学习Beautiful Soup的过程,不仅方便自己以后查看,也许能帮到同样在学习这个技术的朋友.通过学习Beautiful Soup基础知识 完成了一个简单的爬虫服务:从all ...
- 网络爬虫: 从allitebooks.com抓取书籍信息并从amazon.com抓取价格(1): 基础知识Beautiful Soup
开始学习网络数据挖掘方面的知识,首先从Beautiful Soup入手(Beautiful Soup是一个Python库,功能是从HTML和XML中解析数据),打算以三篇博文纪录学习Beautiful ...
- Python爬虫学习(11):Beautiful Soup的使用
之前我们从网页中提取重要信息主要是通过自己编写正则表达式完成的,但是如果你觉得正则表达式很好写的话,那你估计不是地球人了,而且很容易出问题.下边要介绍的Beautiful Soup就可以帮你简化这些操 ...
- 推荐一些python Beautiful Soup学习网址
前言:这几天忙着写分析报告,实在没精力去研究django,虽然抽时间去看了几遍中文文档,还是等实际实践后写几篇操作文章吧! 正文:以下是本人前段时间学习bs4库找的一些网址,在学习的可以参考下,有点多 ...
- 错误 You are trying to run the Python 2 version of Beautiful Soup under Python 3. This will not work
Win 10 下python3.6 使用Beautiful Soup 4错误 You are trying to run the Python 2 version of Beautiful ...
- Python学习笔记之Beautiful Soup
如何在Python3.x中使用Beautiful Soup 1.BeautifulSoup中文文档:http://www.crummy.com/software/BeautifulSoup/bs3/d ...
- Python Beautiful Soup学习之HTML标签补全功能
Beautiful Soup是一个非常流行的Python模块.该模块可以解析网页,并提供定位内容的便捷接口. 使用下面两个命令安装: pip install beautifulsoup4 或者 sud ...
- 转:Beautiful Soup
Beautiful Soup 是一个可以从HTML或XML文件中提取数据的Python库.它能够通过你喜欢的转换器实现惯用的文档导航,查找,修改文档的方式.Beautiful Soup会帮你节省数小时 ...
- Beautiful Soup教程 转
Python中使用Beautiful Soup库的超详细教程 转 http://www.jb51.net/article/65287.htm 作者:崔庆才 字体:[增加 减小] 类型:转载 时间:20 ...
随机推荐
- hud3371 Connect the Cities 简单最小生成树
//我看过Discuss说不能用克鲁斯卡尔因为有很多边 //但是只能用G++过,C++的确超时 #include <stdio.h> #include <string.h> # ...
- Bank Hacking CodeForces - 796C
题目 题意: 一条笨狗要去黑银行,银行有n个,它们之间用n-1条边连接.可以选择任意一个银行开始黑,但是后面每一次黑的银行都要求与已经黑过的银行直接相连.每个银行初始有一个防御值,每一个银行被黑后,与 ...
- 题解报告:hdu 2196 Computer(树形dp)
Problem Description A school bought the first computer some time ago(so this computer's id is 1). Du ...
- C++ thread operator= 右值引用 vector foreach
这是 thread 的construct定义: default (1) thread() noexcept; initialization (2) template <class Fn, cla ...
- [转]Linq 如何实现 in 与 not in
本文转自:http://blog.csdn.net/zhangyumei/article/details/5620363 接触 LINQ 也有很长的一段时间了,有些在 SQL 语句中用的很顺手的东西在 ...
- P1851 好朋友
题目背景 小可可和所有其他同学的手腕上都戴有一个射频识别序列号码牌,这样老师就可以方便的计算出他们的人数.很多同学都有一个“好朋友” .如果 A 的序列号的约数之和恰好等于B 的序列号,那么 A的好朋 ...
- C# winform 创建快捷方式
using System;using IWshRuntimeLibrary;using System.IO; namespace UavSystem.Common{ public class S ...
- 常用的HTML5 pattern属性
type="tel" 和 type="number" 的区别 这里还是先那么先交代一下最初遇到的问题.其实无论是tel还是number都不是完美的: type= ...
- vs2013转为vs2010项目
1.首先用记事本之类的工具打开.sln文件 打开后会看到如下信息 Format Version 12.00 就是指VS2013 VisualStudioVersion = 12.0.21005.1 指 ...
- ibatis学习笔记
步骤: 搭建配置环境:导入相关jar包 配置文件: JDBC连接属性文件 总配置文件 关于每个实体的映射(map.xml)文件 JDBC连接属性文件 jdbc.properties ## mysql ...