
[Spark Core] Spark 核心组件
0. 说明
【Spark 核心组件示意图】
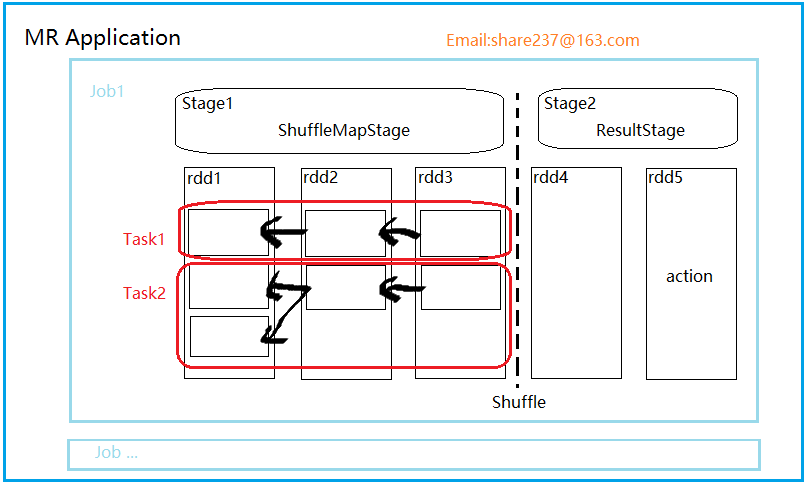
1. RDD
resilient distributed dataset , 弹性数据集
轻量级的数据集合,逻辑上的集合。等价于 list
没有携带数据。
2. 依赖
RDD 的依赖是 子 RDD 上的每个分区和父 RDD 分区数量上的对应关系
Dependency
|----ShuffleDependency (宽依赖)
|----NarrowDependency (窄依赖:子 RDD 的每个分区依赖少量的父 RDD 分区)
|-----One2OneDependency (一对一依赖)
|-----RangeDependency(范围依赖)
|-----PruneDependency(Prune 依赖)
3. Stage(阶段)
并行的 task 集合,同一 Stage 的所有任务有着相同的 Shuffle 依赖。
阶段,一组RDD构成的链条。
阶段的划分按照 Shuffle 标记来进行的。
阶段类型有两种,ShuffleMapStage 和ResultStage。
【ShuffleMapStage】
该阶段任务的结果是下一个阶段任务的输入。需要跟踪每个分区所在的节点。
任务执行期间的中间过程,保存task的输出数据供下一个 reduce 进行 fetch(抓取) 。
该阶段可以单独提交。
【 ResultStage】
结果结果直接执行 RDD 的 action 操作。
对一些分区应用计算函数(不一定需要在所有分区进行计算,比如说first())。
最后一个阶段,执行task后的结果回传给driver
4. Task
task 是 Spark 执行单位,有两种类型。
【ShuffelMapTask】
在 ShuffleMapStage 由多个 ShuffleMapTask 组成。
【ResultTask】
ResultStage 由多个 ResultTask 组成,结果任务直接 task 后,将结果回传给 driver。
driver:
5. job
一个 action 就是一个 job
6. Application
一个应用可以包含多个 job
7. Spark Context
Spark 上下文是 Spark 程序的主入口点,表示到 Spark 集群的连接。可以创建 RDD 、累加器和广播变量。
每个 JVM 只能有一个 active 的上下文,如果要创建新的上下文,必须将原来的上下文 stop。
  sc.textFile("");

  sc.parallelize(1 to 10);

  sc.makeRDD(1 to 10) ;          //通过parallelize实现。
[Spark Core] Spark 核心组件的更多相关文章
- 大数据技术之_27_电商平台数据分析项目_02_预备知识 + Scala + Spark Core + Spark SQL + Spark Streaming + Java 对象池
第0章 预备知识0.1 Scala0.1.1 Scala 操作符0.1.2 拉链操作0.2 Spark Core0.2.1 Spark RDD 持久化0.2.2 Spark 共享变量0.3 Spark ...
- [Spark Core] Spark Client Job 提交三级调度框架
0. 说明 官方文档 Job Scheduling Spark 调度核心组件: DagScheduler TaskScheduler BackendScheduler 1. DagSchedule ...
- [Spark Core] Spark 使用第三方 Jar 包的方式
0. 说明 Spark 下运行job,使用第三方 Jar 包的 3 种方式. 1. 方式一 将第三方 Jar 包分发到所有的 spark/jars 目录下 2. 方式二 将第三方 Jar 打散,和我们 ...
- 【待补充】[Spark Core] Spark 实现标签生成
0. 说明 在 IDEA 中编写 Spark 代码实现将 JSON 数据转换成标签,分别用 Scala & Java 两种代码实现. 1. 准备 1.1 pom.xml <depend ...
- [Spark Core] Spark 在 IDEA 下编程
0. 说明 Spark 在 IDEA 下使用 Scala & Spark 在 IDEA 下使用 Java 编写 WordCount 程序 1. 准备 在项目中新建模块,为模块添加 Maven ...
- [Spark Core] Spark 实现气温统计
0. 说明 聚合气温数据,聚合出 MAX . MIN . AVG 1. Spark Shell 实现 1.1 MAX 分步实现 # 加载文档 val rdd1 = sc.textFile(" ...
- [Spark Core] Spark Shell 实现 Word Count
0. 说明 在 Spark Shell 实现 Word Count RDD (Resilient Distributed dataset), 弹性分布式数据集. 示意图 1. 实现 1.1 分步实现 ...
- Spark 3.x Spark Core详解 & 性能优化
Spark Core 1. 概述 Spark 是一种基于内存的快速.通用.可扩展的大数据分析计算引擎 1.1 Hadoop vs Spark 上面流程对应Hadoop的处理流程,下面对应着Spark的 ...
- Spark Streaming揭秘 Day35 Spark core思考
Spark Streaming揭秘 Day35 Spark core思考 Spark上的子框架,都是后来加上去的.都是在Spark core上完成的,所有框架一切的实现最终还是由Spark core来 ...
随机推荐
- php的explode()和implode()方法
php 中,字符串与数组互转 拆分字符串 到数组 explode() - -(其他语言中的 split) 将数组连接成字符串 implode() <?php $test = ' ...
- 在Linux上进行内核参数调整
在Solaris上,使用工具mdb就可以直接修改内核内存里的内容.而在Linux上,则通常使用命令sysctl(8)做类似的事情. 本文以Fedora为例,介绍如何在Linux上进行内核参数调整. 常 ...
- laravel 数据模型方法
laravel 数据模型方法 作用:提供了数据库操作的方法 <?php namespace App; use Illuminate\Database\Eloquent\Model; class ...
- 并发编程之 CAS 的原理
前言 在并发编程中,锁是消耗性能的操作,同一时间只能有一个线程进入同步块修改变量的值,比如下面的代码 synchronized void function(int b){ a = a + b: } 如 ...
- (原)SQL Server 代理作业执行持续时间简述
本文目录列表: 1.SQL Server 代理作业概述2.获取代理作业执行时间方法一 3.获取代理作业执行时间方法二4.总结语 5.参考目录清单列表 正文: 1.SQL Server 代理作业概述 ...
- 50道sql练习题和答案
最近两年的工作没有写过多少SQL,感觉水平下降十分严重,网上找了50道练习题学习和复习 原文地址:50道SQL练习题及答案与详细分析 1.0数据表介绍 --1.学生表 Student(SId,Snam ...
- [android] 看博客学习Android常见的几种RuntimeException
异常分为两种: 1.编译时异常 当编译时异常抛出时,需要对其进行处理声明,否则编译不通过 2.运行时异常 编译时不检测,运行时 如果抛出,程序会立刻停止 NullPointerException 空指 ...
- EF Codefirst(二)数据注释
CodeFirst通过分析我们在代码里编写的类,以及类之间的关系生成数据库表,以及表之间的各种关系.数据库的表会涉及到主键,外键,列是否为空,列类型等等. 我们要通过怎样的方式来暴露这些信息呢? ...
- JavaOne 2016主旨演讲畅谈Java近期及远期规划
在 JavaOne 2016 主题演讲开场,来自 Oracle 的 Java 产品管理负责人 Sharat Chander 指出 Java 盛行于个人和工作的日常生活各个领域,无论是大数据.物联网甚至 ...
- HDU1083(KB10-C 二分图最大匹配)
Courses Time Limit: 20000/10000 MS (Java/Others) Memory Limit: 65536/32768 K (Java/Others)Total S ...