
python实现并发爬虫
在进行单个爬虫抓取的时候,我们不可能按照一次抓取一个url的方式进行网页抓取,这样效率低,也浪费了cpu的资源。目前python上面进行并发抓取的实现方式主要有以下几种:进程,线程,协程。进程不在的讨论范围之内,一般来说,进程是用来开启多个spider,比如我们开启了4进程,同时派发4个spider进行网络抓取,每个spider同时抓取4个url。
所以,我们今天讨论的是,在单个爬虫的情况下,尽可能的在同一个时间并发抓取,并且抓取的效率要高。
一.顺序抓取
顺序抓取是最最常见的抓取方式,一般初学爬虫的朋友就是利用这种方式,下面是一个测试代码,顺序抓取8个url,我们可以来测试一下抓取完成需要多少时间:
HEADERS = {'Accept': 'text/html,application/xhtml+xml,application/xml;q=0.9',

   'Accept-Language': 'zh-CN,zh;q=0.8',

   'Accept-Encoding': 'gzip, deflate',}

URLS = ['http://www.cnblogs.com/moodlxs/p/3248890.html',

        'https://www.zhihu.com/topic/19804387/newest',

        'http://blog.csdn.net/yueguanghaidao/article/details/24281751',

        'https://my.oschina.net/visualgui823/blog/36987',

        'http://blog.chinaunix.net/uid-9162199-id-4738168.html',

        'http://www.tuicool.com/articles/u67Bz26',

        'http://rfyiamcool.blog.51cto.com/1030776/1538367/',

        'http://itindex.net/detail/26512-flask-tornado-gevent']

#url为随机获取的一批url

def func():

    """

    顺序抓取

    """

    import requests

    import time

    urls = URLS

    headers = HEADERS

    headers['user-agent'] = "Mozilla/5.0+(Windows+NT+6.2;+WOW64)+AppleWebKit/537" \

                            ".36+(KHTML,+like+Gecko)+Chrome/45.0.2454.101+Safari/537.36"

    print(u'顺序抓取')

    starttime= time.time()

    for url in urls:

        try:

            r = requests.get(url, allow_redirects=False, timeout=2.0, headers=headers)

        except:

            pass

        else:

            print(r.status_code, r.url)

    endtime=time.time()

    print(endtime-starttime)

func()
我们直接采用内建的time.time()来计时,较为粗略,但可以反映大概的情况。下面是顺序抓取的结果计时:

可以从图片中看到,显示的顺序与urls的顺序是一模一样的,总共耗时为7.763269901275635秒,一共8个url,平均抓取一个大概需要0.97秒。总体来看,还可以接受。
二.多线程抓取
线程是python内的一种较为不错的并发方式,我们也给出相应的代码,并且为每个url创建了一个线程,一共8线程并发抓取,下面的代码:
下面是我们运行8线程的测试代码:
HEADERS = {'Accept': 'text/html,application/xhtml+xml,application/xml;q=0.9',

   'Accept-Language': 'zh-CN,zh;q=0.8',

   'Accept-Encoding': 'gzip, deflate',}

URLS = ['http://www.cnblogs.com/moodlxs/p/3248890.html',

        'https://www.zhihu.com/topic/19804387/newest',

        'http://blog.csdn.net/yueguanghaidao/article/details/24281751',

        'https://my.oschina.net/visualgui823/blog/36987',

        'http://blog.chinaunix.net/uid-9162199-id-4738168.html',

        'http://www.tuicool.com/articles/u67Bz26',

        'http://rfyiamcool.blog.51cto.com/1030776/1538367/',

        'http://itindex.net/detail/26512-flask-tornado-gevent']

def thread():

    from threading import Thread

    import requests

    import time

    urls = URLS

    headers = HEADERS

    headers['user-agent'] = "Mozilla/5.0+(Windows+NT+6.2;+WOW64)+AppleWebKit/537.36+" \

                            "(KHTML,+like+Gecko)+Chrome/45.0.2454.101+Safari/537.36"

    def get(url):

        try:

            r = requests.get(url, allow_redirects=False, timeout=2.0, headers=headers)

        except:

            pass

        else:

            print(r.status_code, r.url)

    print(u'多线程抓取')

    ts = [Thread(target=get, args=(url,)) for url in urls]

    starttime= time.time()

    for t in ts:

        t.start()

    for t in ts:

        t.join()

    endtime=time.time()

    print(endtime-starttime)

thread()
多线程抓住的时间如下:
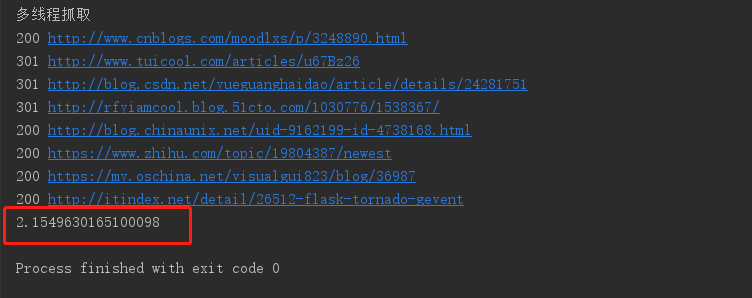
可以看到相较于顺序抓取,8线程的抓取效率明显上升了3倍多,全部完成只消耗了2.154秒。可以看到显示的结果已经不是urls的顺序了,说明每个url各自完成的时间都是不一样的。线程就是在一个进程中不断的切换,让每个线程各自运行一会,这对于网络io来说,性能是非常高的。但是线程之间的切换是挺浪费资源的。
三.gevent并发抓取
gevent是一种轻量级的协程,可用它来代替线程,而且,他是在一个线程中运行,机器资源的损耗比线程低很多。如果遇到了网络io阻塞,会马上切换到另一个程序中去运行,不断的轮询,来降低抓取的时间
下面是测试代码:
HEADERS = {'Accept': 'text/html,application/xhtml+xml,application/xml;q=0.9',

   'Accept-Language': 'zh-CN,zh;q=0.8',

   'Accept-Encoding': 'gzip, deflate',}

URLS = ['http://www.cnblogs.com/moodlxs/p/3248890.html',

        'https://www.zhihu.com/topic/19804387/newest',

        'http://blog.csdn.net/yueguanghaidao/article/details/24281751',

        'https://my.oschina.net/visualgui823/blog/36987',

        'http://blog.chinaunix.net/uid-9162199-id-4738168.html',

        'http://www.tuicool.com/articles/u67Bz26',

        'http://rfyiamcool.blog.51cto.com/1030776/1538367/',

        'http://itindex.net/detail/26512-flask-tornado-gevent']

def main():

    """

    gevent并发抓取

    """

    import requests

    import gevent

    import time

    headers = HEADERS

    headers['user-agent'] = "Mozilla/5.0+(Windows+NT+6.2;+WOW64)+AppleWebKit/537.36+" \

                            "(KHTML,+like+Gecko)+Chrome/45.0.2454.101+Safari/537.36"

    urls = URLS

    def get(url):

        try:

            r = requests.get(url, allow_redirects=False, timeout=2.0, headers=headers)

        except:

            pass

        else:

            print(r.status_code, r.url)

    print(u'基于gevent的并发抓取')

    starttime= time.time()

    g = [gevent.spawn(get, url) for url in urls]

    gevent.joinall(g)

    endtime=time.time()

    print(endtime - starttime)

main()
协程的抓取时间如下:

正常情况下,gevent的并发抓取与多线程的消耗时间差不了多少,但是可能是我网络的原因,或者机器的性能的原因,时间有点长......,请各位小主在自己电脑进行跑一下看运行时间
四.基于tornado的coroutine并发抓取
tornado中的coroutine是python中真正意义上的协程,与python3中的asyncio几乎是完全一样的,而且两者之间的future是可以相互转换的,tornado中有与asyncio相兼容的接口。
下面是利用tornado中的coroutine进行并发抓取的代码:
利用coroutine编写并发略显复杂,但这是推荐的写法,如果你使用的是python3,强烈建议你使用coroutine来编写并发抓取。
下面是测试代码:
HEADERS = {'Accept': 'text/html,application/xhtml+xml,application/xml;q=0.9',

   'Accept-Language': 'zh-CN,zh;q=0.8',

   'Accept-Encoding': 'gzip, deflate',}

URLS = ['http://www.cnblogs.com/moodlxs/p/3248890.html',

        'https://www.zhihu.com/topic/19804387/newest',

        'http://blog.csdn.net/yueguanghaidao/article/details/24281751',

        'https://my.oschina.net/visualgui823/blog/36987',

        'http://blog.chinaunix.net/uid-9162199-id-4738168.html',

        'http://www.tuicool.com/articles/u67Bz26',

        'http://rfyiamcool.blog.51cto.com/1030776/1538367/',

        'http://itindex.net/detail/26512-flask-tornado-gevent']

import time

from tornado.gen import coroutine

from tornado.ioloop import IOLoop

from tornado.httpclient import AsyncHTTPClient, HTTPError

from tornado.httpclient import HTTPRequest

#urls与前面相同

class MyClass(object):

    def __init__(self):

        #AsyncHTTPClient.configure("tornado.curl_httpclient.CurlAsyncHTTPClient")

        self.http = AsyncHTTPClient()

    @coroutine

    def get(self, url):

        #tornado会自动在请求首部带上host首部

        request = HTTPRequest(url=url,

                            method='GET',

                            headers=HEADERS,

                            connect_timeout=2.0,

                            request_timeout=2.0,

                            follow_redirects=False,

                            max_redirects=False,

                            user_agent="Mozilla/5.0+(Windows+NT+6.2;+WOW64)+AppleWebKit/537.36+\

                            (KHTML,+like+Gecko)+Chrome/45.0.2454.101+Safari/537.36",)

        yield self.http.fetch(request, callback=self.find, raise_error=False)

    def find(self, response):

        if response.error:

            print(response.error)

        print(response.code, response.effective_url, response.request_time)

class Download(object):

    def __init__(self):

        self.a = MyClass()

        self.urls = URLS

    @coroutine

    def d(self):

        print(u'基于tornado的并发抓取')

        starttime = time.time()

        yield [self.a.get(url) for url in self.urls]

        endtime=time.time()

        print(endtime-starttime)

if __name__ == '__main__':

    dd = Download()

    loop = IOLoop.current()

    loop.run_sync(dd.d)
抓取的时间如下:

可以看到总共花费了128087秒,而这所花费的时间恰恰就是最后一个url抓取所需要的时间,tornado中自带了查看每个请求的相应时间。我们可以从图中看到,最后一个url抓取总共花了1.28087秒,相较于其他时间大大的增加,这也是导致我们消耗时间过长的原因。那可以推断出,前面的并发抓取,也在这个url上花费了较多的时间。
总结:
以上测试其实非常的不严谨,因为我们选取的url的数量太少了,完全不能反映每一种抓取方式的优劣。如果有一万个不同的url同时抓取,那么记下总抓取时间,是可以得出一个较为客观的结果的。
并且,已经有人测试过,多线程抓取的效率是远不如gevent的。所以,如果你使用的是python2,那么我推荐你使用gevent进行并发抓取;如果你使用的是python3,我推荐你使用tornado的http客户端结合coroutine进行并发抓取。从上面的结果来看,tornado的coroutine是高于gevent的轻量级的协程的。但具体结果怎样,我没测试过。
python实现并发爬虫的更多相关文章
- Python之并发编程-协程
目录 一.介绍 二. yield.greenlet.gevent介绍 1.yield 2.greenlet 3.gevent 一.介绍 协程:是单线程下的并发,又称微线程,纤程.英文名Coroutin ...
- 用python写网路爬虫 PDF高清完整版免费下载 Python基础教程免费电子书 python入门书籍免费下载
<用python写网路爬虫PDF免费下载>PDF书籍下载 内容简介 作为一种便捷地收集网上信息并从中抽取出可用信息的方式,网络爬虫技术变得越来越有用.使用Python这样的简单编程语言,你 ...
- Python 开发轻量级爬虫08
Python 开发轻量级爬虫 (imooc总结08--爬虫实例--分析目标) 怎么开发一个爬虫?开发一个爬虫包含哪些步骤呢? 1.确定要抓取得目标,即抓取哪些网站的哪些网页的哪部分数据. 本实例确定抓 ...
- Python 开发轻量级爬虫07
Python 开发轻量级爬虫 (imooc总结07--网页解析器BeautifulSoup) BeautifulSoup下载和安装 使用pip install 安装:在命令行cmd之后输入,pip i ...
- Python 开发轻量级爬虫06
Python 开发轻量级爬虫 (imooc总结06--网页解析器) 介绍网页解析器 将互联网的网页获取到本地以后,我们需要对它们进行解析才能够提取出我们需要的内容. 也就是说网页解析器是从网页中提取有 ...
- Python 开发轻量级爬虫05
Python 开发轻量级爬虫 (imooc总结05--网页下载器) 介绍网页下载器 网页下载器是将互联网上url对应的网页下载到本地的工具.因为将网页下载到本地才能进行后续的分析处理,可以说网页下载器 ...
- Python 开发轻量级爬虫04
Python 开发轻量级爬虫 (imooc总结04--url管理器) 介绍抓取URL管理器 url管理器用来管理待抓取url集合和已抓取url集合. 这里有一个问题,遇到一个url,我们就抓取它的内容 ...
- Python 开发轻量级爬虫03
Python 开发轻量级爬虫 (imooc总结03--简单的爬虫架构) 现在来看一下一个简单的爬虫架构. 要实现一个简单的爬虫,有哪些方面需要考虑呢? 首先需要一个爬虫调度端,来启动爬虫.停止爬虫.监 ...
- Python 开发轻量级爬虫02
Python 开发轻量级爬虫 (imooc总结02--爬虫简介) 爬虫简介 首先爬虫是什么?它是一段自动抓取互联网信息的程序. 什么意思呢? 互联网由各种各样的的网页组成,每一个网页都有对应的url, ...
随机推荐
- 分布式事务实现-Percolator
Google为了解决网页索引的增量处理,以及维护数据表和索引表的一致性问题,基于BigTable实现了一个支持分布式事务的存储系统.这里重点讨论这个系统的分布式事务实现,不讨论percolator中为 ...
- NodeJS中MySql的增删改查操作
纯粹记录一下最基础写法,几乎没有写什么逻辑,写法也并不是很完善(因为我自己也刚刚摸索出来这么写可以...= =!) 望高手指教 也希望能够帮到比我还新的新手.... //1.insert操作 ...
- sql server数据导入导出方法统计
常用的数据量不是很大的情况的几种方法:转载地址 http://www.cnblogs.com/changbluesky/archive/2010/06/23/1761779.html 大数据量的推荐导 ...
- Django之基于iframe的ajax伪造
IFRAME是HTML标签,作用是文档中的文档,或者浮动的框架(FRAME).iframe元素会创建包含另外一个文档的内联框架 ajax的理念是不进行浏览器页面刷新的信息获取更新,也就是局部刷新. 那 ...
- Hadoop HBase概念学习系列之META表和ROOT表(六)
在 HBase里的HRegion 里,谈过,HRegion是按照表名+开始/结束主键,即表名+主键范围来区分的.由于主键范围是连续的,所以一般用开始主键就可以表示相应的HRegion了. 不过,因为我 ...
- react的新手基础知识笔记
<!DOCTYPE html> <html> <head> <script src="../build/react.js">< ...
- 【Ansible 文档】【译文】常见问题
http://docs.ansible.com/ansible/latest/faq.html 如何为一个task或者整个Playbook设置PATH或者任意其他环境变量? 通过environment ...
- 在HTML中使用object和embed标签插入视频
object标签和embed标签都能给页面添加多媒体内容: 一.object 对于object,w3c上定义object为一个嵌入的对象.可以使用此元素向您的 XHTML 页面添加多媒体.此元素允许您 ...
- Django使用静态文件
除了由服务器生成的HTML文件外,网页应用一般需要提供其它必要的文件 —— 比如图片文件.JavaScript脚本和CSS样式表 —— 来为用户呈现出一个完整的网站. 在Django中,我们将这些文件 ...
- Beautiful Soup (一)
一.Beautiful Soup库的理解 1.Beautiful Soup库可以说是对HTML进行解析.遍历.维护“标签树”的功能库 2.pip install bs4 3.from bs4 impo ...