
logstash marking url as dead 问题解决
具体问题如下图所示:
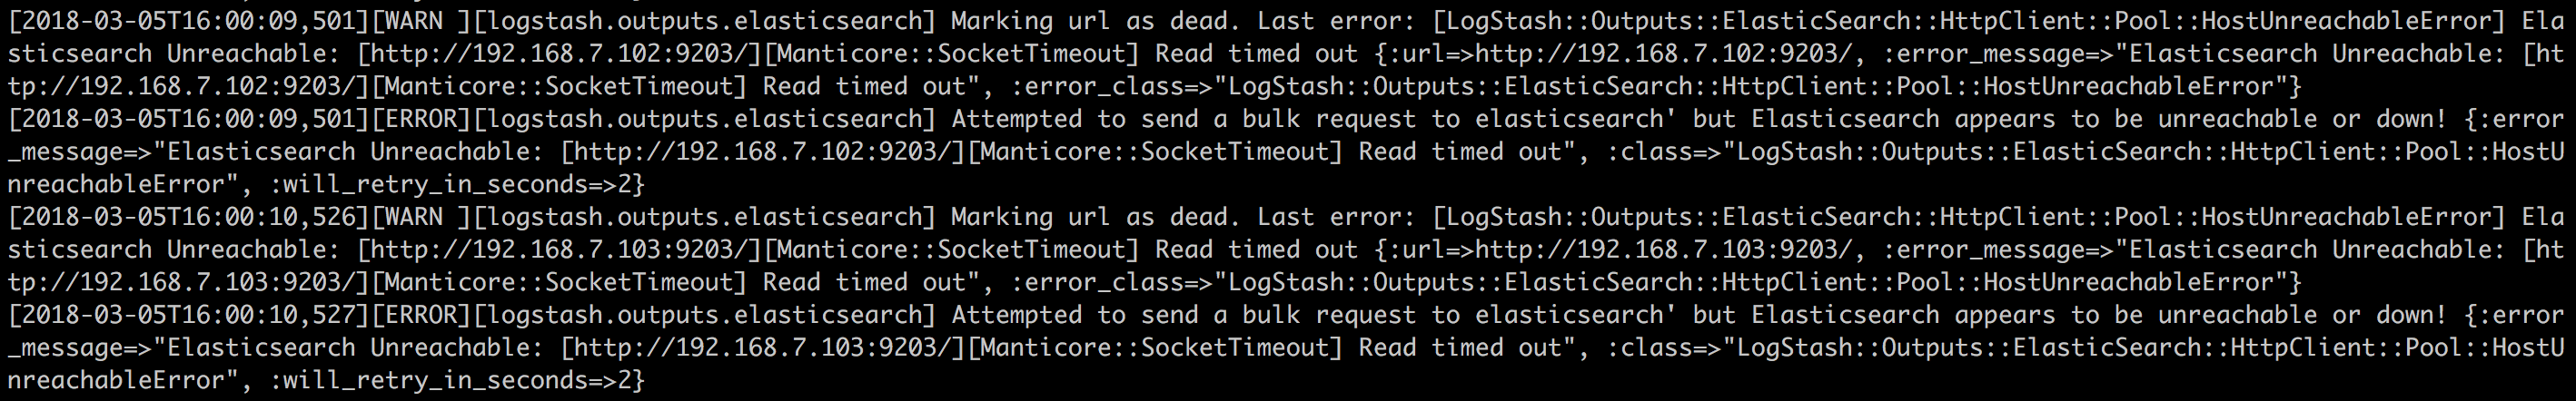
将 INFO 信息打印大致如下所示:
[2018-03-05T16:26:08,711][INFO ][logstash.setting.writabledirectory] Creating directory {:setting=>"path.queue", :path=>"/usr/share/logstash/data/queue"}
[2018-03-05T16:26:08,727][INFO ][logstash.agent ] No persistent UUID file found. Generating new UUID {:uuid=>"f4d5f9a9-42ca-4765-b3fb-0f4566f440df", :path=>"/usr/share/logstash/data/uuid"}

[2018-03-05T16:26:09,175][INFO ][logstash.outputs.elasticsearch] Elasticsearch pool URLs updated {:changes=>{:removed=>[], :added=>[http://logstash_system:xxxxxx@localhost:9200/_xpack/monitoring/?system_id=logstash&system_api_version=2&interval=1s]}}
[2018-03-05T16:26:09,176][INFO ][logstash.outputs.elasticsearch] Running health check to see if an Elasticsearch connection is working {:healthcheck_url=>http://logstash_system:xxxxxx@localhost:9200/, :path=>"/"}
[2018-03-05T16:26:09,262][WARN ][logstash.outputs.elasticsearch] Attempted to resurrect connection to dead ES instance, but got an error. {:url=>#<URI::HTTP:0x59e42e4f URL:http://logstash_system:xxxxxx@localhost:9200/_xpack/monitoring/?system_id=logstash&system_api_version=2&interval=1s>, :error_type=>LogStash::Outputs::ElasticSearch::HttpClient::Pool::HostUnreachableError, :error=>"Elasticsearch Unreachable: [http://logstash_system:xxxxxx@localhost:9200/][Manticore::SocketException] Connection refused (Connection refused)"}
首先,从日志上看到发现可能是 es 被写死了,即无法再写入更多的数据,既然这样,那么很自然的就会想到限流 logstash 数据的写入,配置logstash-5.4.1/config/logstash.yml修改:
降低 pipeline 中的 workers 的量,由原来的 32 -> 16, batch size 修改 1000 -> 500, delay 修改 200 -> 1000, output.workers: 16 -> 8
修改完毕之后重启 logstash 发现过一段时间还会有相应的日志出现,找了半天终于 google 中找到有一个老外说的可能是 xpack 做的 helth check 影响的,我一看日志果然有对应每隔 1s 会对 es 做一次 helth check,于是就在 logstash.yml 中增加一行:
xpack.monitoring.enabled: false
即去除 xpack 的监控,再重新启动 logstash 后观察了一段时间果然不会再有任何的 WARN 和 ERROR 日志,问题得以解决。
总结
我猜测,这确实是 xpack 的问题,因为它每1s 去 ping es 状态,当集群繁忙时很容易导致 time out,此时 logstash 认为 es 不可达,就会一直轮询等待。去除掉 xpack 的helth check 等监控,由 logstash 自己写入时判断即可。
【2018-03-06 18:08:56 记录】
昨天修改完,今天查看发现仍然有上面提到的异常日志,于是继续查看。对应的logstash 以及 ElasticSearch 服务器对应的负载、cpu 都不是太高,初步怀疑可能是 io 的问题,即很频繁的进行 io 交互。
通过查看日志发现在很多的时间内,反复提示 ‘send a bulk request to elasticsearch’ 的错误,代表logstash在不断的,快速的给ES发送 bulk reuqest。我们查看logstash的配置发现,默认的配置是:
# How many events to retrieve from inputs

pipeline.batch.size: 125

# milliseconds

pipeline.batch.delay: 5
而我当前配置是:
pipeline:

  workers: 32

  batch:

    size: 200

    delay: 100

  output:

    workers: 8

  unsafe_shutdown: false

queue:

  type: persisted

  page_capacity: 250mb

  max_events: 10000

  max_bytes: 1gb

  checkpoint:

    acks: 10000

    writes: 10000

    interval: 1000
这里的单位是milliseconds,即每个 logstash 的 instance,每 100 毫秒会发送 200 条 request 到ES集群,这个会导致ES集群的网络io过载。
那么,是不是说我们需要把每个 batch 之间的间隔增大,把每次batch的size调大?比如batch.size = 500, batch.delay = 500,就能防止出现以上的问题?
经过测试这样是可行的。
由于下面配置的 max_bytes 以及 max_events 的限制,修改后的配置如下(仅供参考):
pipeline:

  workers: 16

  batch:

    size: 500

    delay: 200

  output:

    workers: 12

  unsafe_shutdown: false

queue:

  type: persisted

  page_capacity: 250mb

  max_events: 10000

  max_bytes: 1gb

  checkpoint:

    acks: 10000

    writes: 10000

    interval: 1000
这样配置的目的有那么几个:
1. 尽量一次读出最大可能条数据,这样可以最大程度的降低与 ES 之间的 IO 交互。
2. 间隔时间不能太久,刚开始配置 1000,发现还是出现又降低到 500,错误变少了,分析发现应该是间隔时间长了,logstash 堵在队列中的数据就会增多,这样导致读取的频次永远不会降低,尤其是过了一段时间发现部分日质数量比较大的收集延迟变大。故综合考虑将延迟时间修改为 200。
3. 由于 CPU 核数比较高达到40多个,故将 output.workers 线程数增加,提升处理能力,减少数据拥堵,降低延迟度。
最后总结一句:以上报错信息其实并不影响整体日志收集,这个错误只是 logstash 自己认为可能不可达,是由于其中的组件导致的,查了下 github 上的说法,后续最新版本可能会解决这个误报问题,但是不是说我们就不管不顾了,而是要想办法将这个错误频次降低,尽最大可能使其运行良好。
【2018-05-06 10:18:56 记录】
在这期间将 ELK 收集日志丢失日志问题解决。最主要还是配置不合理导致的。问题原因是因为配置的 filebeat 中不可达等待最长时间为:3min,如果中途 logstash 拥堵比较严重,elasticsearch 负载又高,极大可能会造成 filebeat 休眠超过3min,看最新版本 filebeat 默认为 1天,其实配置是合理的,虽然有点大,但是总比丢数据要来的好。将其中的配置增大为 1h 后,再不会发生丢失日志的情况。
解决 ELK 收集日志延迟比较高的问题,尝试了很多优化发现无法从根本上解决,于是将最耗资源的 nginx_log 和 push_log 单独迁移到各自小的集群上,剩下所有的其他日志仍然保留在现有集群上,从此以后各种问题得以解决。归结起来就是一句话:有多大能力就干多大的事,不要超过其最大承受能力。
logstash marking url as dead 问题解决的更多相关文章
- dede列表页分页地址优化(不同url相同内容问题解决)<转自http://www.966266.com>
<注明,完全转自http://www.966266.com/seoblog/?p=75> 存在问题 DEDE默认分类分页地址存在不同URL相同内容问题,导致内容重复,对SEO非常不利.情况 ...
- url编码乱码问题解决
//url encodeURI加密 window.location.href = "upload.html?sendName="+encodeURI(sendName); //接收 ...
- eclipse/myeclipse SVN资源库URL中文乱码问题解决办法
右击选择资源库地址 可以自定义名称
- 树莓派搭建网站wordpress的url写错 问题解决方法 有效GUI方法
这个时候wordpress的后台已经登陆不了了,所以要对数据库做一些改变. 先说一下我是跟b站韩博士学的,LNMP.如果我们用的不一个方法的话下面就不用看了.下面是具体方法: 1 浏览器登录phpm ...
- logstash写日志elaticsearch不响应
在大量的解析日志并写入elasticsearch,在后端节点数据数量及磁盘性能等影响下,es不响应 问题描述: [--12T17::,][WARN ][logstash.outputs.elastic ...
- 基于ELK搭建MySQL日志平台的要点和常见错误
第一部分 概括 ELK是集分布式数据存储.可视化查询和日志解析于一体的日志分析平台.ELK=elasticsearch+Logstash+kibana,三者各司其职,相互配合,共同完成日志的数据处理工 ...
- 谷歌浏览器 URL无法访问
使用谷歌浏览器老是会崩溃,或者访问的时候发现“URL无法访问”等失败的问题,连淘宝都没法访问,这个让人很恼火, 最后在扩展应用那里搜到个URL的redirect,问题解决了,~~发现没有再出现类似问题 ...
- CentOS 搭建Graylog集群详解
1. Graylog2 简介 Graylog 是一个简单易用.功能较全面的日志管理工具,相比 ELK 组合, 优点: 部署维护简单,一体化解决方案,不像ELK三个独立系统集成. 查相比ES json语 ...
- windows 2008 下C#调用office组件访问拒绝的解决方法(failed due to the following error: 80070005 拒绝访问)
"组件服务"- >"计算机"- >"我的电脑"- >"DCOM配置"->找到word->属 ...
随机推荐
- python 回溯法 子集树模板 系列 —— 13、最佳作业调度问题
问题 给定 n 个作业,每一个作业都有两项子任务需要分别在两台机器上完成.每一个作业必须先由机器1 处理,然后由机器2处理. 试设计一个算法找出完成这n个任务的最佳调度,使其机器2完成各作业时间之和达 ...
- Javascript如何实现GPU加速?
一.什么是Javascript实现GPU加速? CPU与GPU设计目标不同,导致它们之间内部结构差异很大.CPU需要应对通用场景,内部结构非常复杂.而GPU往往面向数据类型统一,且相互无依赖的计算.所 ...
- Unity实现简单的AR
,本篇是我在博客园上第一次写随笔,有什么不对或者问题可以在评论区留言告诉我哈! 关于AR(增强现实技术(Augmented Reality))简单的概念,在这里就不说了,有兴趣的同学可以上网详细了解, ...
- 微软职位内部推荐-Senior Development Lead – Sharepoint
微软近期Open的职位: SharePoint is a multi-billion dollar enterprise business that has grown from an on-prem ...
- Java并发编程(详解wait(), notify(),sleep())
http://blog.csdn.net/luckyzhoustar/article/details/48179161
- centos crontab 计划任务 设置与查看
centos 上 crontab 计划任务 ,这个版本解释的比较清晰 林涛 发表于:2017-4-27 11:11 分类:26点 标签:crontab,Linux,计划任务 36次 这个版本的cron ...
- Alpha版本发布时间安排
Alpha版本发布截止时间:2014年11月23日 第一轮迭代M1报告时间:2014年11月27日课上 - 每个团队5分钟时间汇报,5分钟时间提问 第一轮迭代M1事后分析报告时间:2014年11月29 ...
- 20135234mqy-——信息安全系统设计基础第十四周学习总结
第九章 虚拟存储器 主要作用: 将主存看作是一个存储在磁盘上的地址空间的高速缓存,在主存中只保护活动的区域,并根据需要在磁盘和主存之间来回传送数据: 为每个进程提供了一致的地址空间,从而简化了存储器管 ...
- Fibbing以让虚结点的设置更简单为目的优化网络需求
- 团队项目作业四 - WBS
WBS 即 Work Breakdown Structure 工作分解结构, 经过我们小组的讨论,对于手机计算器APP的工作分解结构,定为以下几个方面: 1.APP框架搭建,按钮的设计,对按钮的响应等 ...