
网卡的 Ring Buffer 详解
1. 网卡处理数据包流程
网卡处理网络数据流程图:
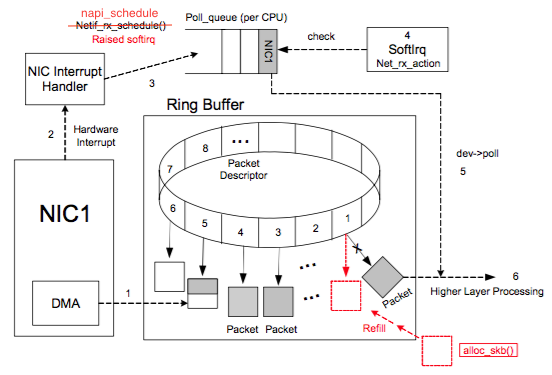
图片来自参考链接1
上图中虚线步骤的解释:
- DMA 将 NIC 接收的数据包逐个写入 sk_buff ,一个数据包可能占用多个 sk_buff , sk_buff 读写顺序遵循FIFO(先入先出)原则。
- DMA 读完数据之后,NIC 会通过 NIC Interrupt Handler 触发 IRQ (中断请求)。
- NIC driver 注册 poll 函数。
- poll 函数对数据进行检查,例如将几个 sk_buff 合并,因为可能同一个数据可能被分散放在多个 sk_buff 中。
- poll 函数将 sk_buff 交付上层网络栈处理。
完整流程:
- 系统启动时 NIC (network interface card) 进行初始化,系统分配内存空间给 Ring Buffer 。
- 初始状态下,Ring Buffer 队列每个槽中存放的 Packet Descriptor 指向 sk_buff ,状态均为 ready。
- DMA 将 NIC 接收的数据包逐个写入 sk_buff ,一个数据包可能占用多个 sk_buff ,sk_buff 读写顺序遵循FIFO(先入先出)原则。
- 被写入数据的 sk_buff 变为 used 状态。
- DMA 读完数据之后,NIC 会通过 NIC Interrupt Handler 触发 IRQ (中断请求)。
- NIC driver 注册 poll 函数。
- poll 函数对数据进行检查,例如将几个 sk_buff 合并,因为可能同一个数据可能被分散放在多个 sk_buff 中。
- poll 函数将 sk_buff 交付上层网络栈处理。
- poll 函数清理 sk_buff,清理 Ring Buffer 上的 Descriptor 将其指向新分配的 sk_buff 并将状态设置为 ready。
2. 多 CPU 下的 Ring Buffer 处理
因为分配给 Ring Buffer 的空间是有限的,当收到的数据包速率大于单个 CPU 处理速度的时候 Ring Buffer 可能被占满,占满之后再来的新数据包会被自动丢弃。
如果在多核 CPU 的服务器上,网卡内部会有多个 Ring Buffer,NIC 负责将传进来的数据分配给不同的 Ring Buffer,同时触发的 IRQ 也可以分配到多个 CPU 上,这样存在多个 Ring Buffer 的情况下 Ring Buffer 缓存的数据也同时被多个 CPU 处理,就能提高数据的并行处理能力。
当然,要实现“NIC 负责将传进来的数据分配给不同的 Ring Buffer”,NIC 网卡必须支持 Receive Side Scaling(RSS) 或者叫做 multiqueue 的功能。RSS 除了会影响到 NIC 将 IRQ 发到哪个 CPU 之外,不会影响别的逻辑了。数据处理过程跟之前描述的是一样的。
3. Ring Buffer 相关命令
在生产实践中,因 Ring Buffer 写满导致丢包的情况很多。当环境中的业务流量过大且出现网卡丢包的时候,考虑到 Ring Buffer 写满是一个很好的思路。
总结下 Ring Buffer 相关的命令:
3.1 网卡收到的数据包统计
[root@server-20.140.beishu.polex.io ~ ]$ ethtool -S em1 | more

NIC statistics:

     rx_packets:

     tx_packets:

     rx_bytes:

     tx_bytes:

     rx_broadcast:

     tx_broadcast:

     rx_multicast:

     tx_multicast:
RX 就是收到数据,TX 是发出数据。
3.2 带有 drop 字样的统计和 fifo_errors 的统计
[root@server-20.140.beishu.polex.io ~ ]$ ethtool -S em1 | grep -iE "error|drop"
rx_crc_errors: 0
rx_missed_errors: 0
tx_aborted_errors: 0
tx_carrier_errors: 0
tx_window_errors: 0
rx_long_length_errors: 0
rx_short_length_errors: 0
rx_align_errors: 0
dropped_smbus: 0
rx_errors: 0
tx_errors: 0
tx_dropped: 0
rx_length_errors: 0
rx_over_errors: 0
rx_frame_errors: 0
rx_fifo_errors: 79270
tx_fifo_errors: 0
tx_heartbeat_errors: 0
rx_queue_0_drops: 16669
rx_queue_1_drops: 21522
rx_queue_2_drops: 0
rx_queue_3_drops: 5678
rx_queue_4_drops: 5730
rx_queue_5_drops: 14011
rx_queue_6_drops: 15240
rx_queue_7_drops: 420
发送队列和接收队列 drop 的数据包数量显示在这里。并且所有 queue_drops 加起来等于 rx_fifo_errors。所以总体上能通过 rx_fifo_errors 看到 Ring Buffer 上是否有丢包。如果有的话一方面是看是否需要调整一下每个队列数据的分配,或者是否要加大 Ring Buffer 的大小。
3.3 查询 Ring Buffer 大小
[root@server-20.140.beishu.polex.io ~ ]$ ethtool -g em1
Ring parameters for em1:
Pre-set maximums:
RX: 4096
RX Mini: 0
RX Jumbo: 0
TX: 4096
Current hardware settings:
RX: 256
RX Mini: 0
RX Jumbo: 0
TX: 256
RX 和 TX 最大是 4096,当前值为 256 。队列越大丢包的可能越小,但数据延迟会增加。
3.4 调整 Ring Buffer 队列数量
[root@server-20.140.beishu.polex.io ~ ]$ ethtool -l em1

Channel parameters for em1:

Pre-set maximums:

RX:

TX:

Other:

Combined:

Current hardware settings:

RX:

TX:

Other:

Combined:
Combined = 8,说明当前 NIC 网卡会使用 8 个进程处理网络数据。
更改 eth0 网卡 Combined 的值:
ethtool -L eth0 combined
需要注意的是,ethtool 的设置操作可能都要重启一下才能生效。
3.4 调整 Ring Buffer 队列大小
查看当前 Ring Buffer 大小:
[root@server-20.140.beishu.polex.io ~ ]$ ethtool -g em1

Ring parameters for em1:

Pre-set maximums:

RX:

RX Mini:

RX Jumbo:

TX:

Current hardware settings:

RX:

RX Mini:

RX Jumbo:

TX:
看到 RX 和 TX 最大是 4096,当前值为 256。队列越大丢包的可能越小,但数据延迟会增加.
设置 RX 和 TX 队列大小:
ethtool -G em1 rx

ethtool -G em1 tx
3.5 调整 Ring Buffer 队列的权重
NIC 如果支持 mutiqueue 的话 NIC 会根据一个 Hash 函数对收到的数据包进行分发。能调整不同队列的权重,用于分配数据。
[root@server-20.140.beishu.polex.io ~ ]$ ethtool -x em1

RX flow hash indirection table for em1 with  RX ring(s):

    :

    :

   :

   :

   :

   :

   :

   :

   :

   :

   :

   :

   :

  :

  :

  :

RSS hash key:

Operation not supported
我的 NIC 一共有 8 个队列,一共有 128 个不同的 Hash 值,上面就是列出了每个 Hash 值对应的队列是什么。最左侧 0 8 16 是为了能让你快速的找到某个具体的 Hash 值。比如 Hash 值是 76 的话我们能立即找到 72 那一行:”72: 4 4 4 4 4 4 4 4”,从左到右第一个是 72 数第 5 个就是 76 这个 Hash 值对应的队列是 4 。
设置 8 个队列的权重。加起来不能超过 128 。128 是 indirection table 大小,每个 NIC 可能不一样。
3.6 更改 Ring Buffer Hash Field
分配数据包的时候是按照数据包内的某个字段来进行的,这个字段能进行调整。
[root@server-20.140.beishu.polex.io ~ ]$ ethtool -n em1 rx-flow-hash tcp4

TCP over IPV4 flows use these fields for computing Hash flow key:

IP SA

IP DA

L4 bytes  &  [TCP/UDP src port]

L4 bytes  &  [TCP/UDP dst port]
也可以设置 Hash 字段:查看 tcp4 的 Hash 字段。
ethtool -N em1 rx-flow-hash udp4 sdfn
sdfn 需要查看 ethtool 看其含义,还有很多别的配置值。
3.6 IRQ 统计
/proc/interrupts 能看到每个 CPU 的 IRQ 统计。一般就是看看 NIC 有没有支持 multiqueue 以及 NAPI 的 IRQ 合并机制是否生效。看看 IRQ 是不是增长的很快。
参考链接:
https://ylgrgyq.github.io/2017/07/23/linux-receive-packet-1/
网卡的 Ring Buffer 详解的更多相关文章
- 前端后台以及游戏中使用Google Protocol Buffer详解
前端后台以及游戏中使用Google Protocol Buffer详解 0.什么是protoBuf protoBuf是一种灵活高效的独立于语言平台的结构化数据表示方法,与XML相比,protoBuf更 ...
- 使用Squid做代理服务器,Squid单网卡透明代理配置详解(转)
使用Squid做代理服务器 说到代理服务器,我们最先想到的可能是一些专门的代理服务器网站,某些情况下,通过它们能加快访问互联网的速度.其实,在需要访问外部的局域网中,我们自己就能设置代理,把访问次数较 ...
- java NIO Buffer 详解(1)
1.java.io 最为核心的概念是流(stream),面向流的编程,要么输入流要么输出流,二者不可兼具: 2.java.nio 中拥有3个核心概念: Selector Channel, Buffe ...
- 10.Linux网卡的配置及详解
1.网卡配置文件在/etc/sysconfig/network-scripts/下: [root@oldboy network-scripts]# ls /etc/sysconfig/network- ...
- Potocol Buffer详解
protocol安装及使用 上一篇博文介绍了一个综合案例,这篇将详细介绍protocol buffer. 为什么使用protocol buffer? java默认序列化效率较低. apache的thr ...
- Protocol Buffer详解
1.Protocol Buffer 概念 Google Protocol Buffer( 简称 Protobuf) 是 Google 公司内部的混合语言数据标准,目前已经正在使用的有超过 48,162 ...
- 网卡也能虚拟化?网卡虚拟化技术 macvlan 详解
本文首发于我的公众号 Linux云计算网络(id: cloud_dev),专注于干货分享,号内有 10T 书籍和视频资源,后台回复「1024」即可领取,欢迎大家关注,二维码文末可以扫. 01 macv ...
- Java NIO中的Buffer 详解
Java NIO中的Buffer用于和NIO通道进行交互.如你所知,数据是从通道读入缓冲区,从缓冲区写入到通道中的.缓冲区本质上是一块可以写入数据,然后可以从中读取数据的内存.这块内存被包装成NIO ...
- mysql-5.7 innodb change buffer 详解
一.innodb change buffer 介绍: 1.innodb change buffer 是针对oltp场景下磁盘IO的一种优化(我也感觉这个不太像人话,但是它又非常的准确的说明 innod ...
随机推荐
- Linux.安装phantomjs
PhantomJS 是一个基于 WebKit 的服务器端 JavaScript API.它全面支持web而不需浏览器支持,其快速,原生支持各种Web标准: DOM 处理, CSS 选择器, JSON, ...
- 我的新纪元Day01
在我刚刚开通博客园后,想了好久.不知道第一次随笔该写点什么,想写些自己学到的知识,但技术上还是菜鸟的我完全不知道我能向别人分享什么,想到这里有些沮丧. 但万事开头难,只要我入了门,广阔的编程语言的世界 ...
- 大白话5分钟带你走进人工智能-第三节最大似然推导mse损失函数(深度解析最小二乘来源)(1)
第三节最大似然推导mse损失函数(深度解析最小二乘来源) 在第二节中,我们介绍了高斯分布的 ...
- 《Thinking in Android 9.0 系统开发源码钻研录》
最近打算把个人站点的博客文章同步到"博客园"! Thinking in Android -- "系统启动" [启动阶段] [相关文章] 状态 源码版本 init ...
- 我手写的简易tomcat
前述 自己手写的简易的tomcat,实现了tomcat的基本响应功能,项目代码已经上传到我的Github,刚刚开始学习这里,当前还存在很多问题 项目简述及代码 当我们的Web运行的时候,从浏览器发出的 ...
- FreeSql.Repository 通用仓储层功能
前言 好多年前,DAL 作为数据库访问层,其实是非常流行的命名方式. 不知道从什么时候开始,仓储层成了新的时尚名词.目前了解到,许多人只要在项目中看见 DAL 就会觉得很 low,但是比较可笑的一点是 ...
- Redis in .NET Core 入门:(3) Hash
第1篇:https://www.cnblogs.com/cgzl/p/10294175.html 第2篇 String:https://www.cnblogs.com/cgzl/p/10297565. ...
- Bagging之随机森林
随机森林(Random Forest)是一种Bagging(Bootstrap Aggregating)集成算法,在样本随机(样本扰动)的基础上,进一步运用特征随机(属性扰动)的机制,得到比一般的Ba ...
- SpringBoot SpEL表达式注入漏洞-分析与复现
目录 0x00前言 0x01触发原因 0x02调试分析 0x03补丁分析 0x04参考文章 影响版本: 1.1.0-1.1.12 1.2.0-1.2.7 1.3.0 修复方案:升至1.3.1或以上版本 ...
- Docker 堆栈
1. Stack stack(译:堆叠,堆栈)是一组相互关联的服务,它们共享依赖关系,并且可以一起编排和伸缩. 在上一篇<Docker 服务>中我们知道可以通过创建一个docker-co ...