
MapReduce-自定义 InputFormat 生成 SequenceFile
Hadoop 框架自带的 InputFormat 类型不能满足所有应用场景,需要自定义 InputFormat 来解决实际问题。
无论 HDFS 还是 MapReduce,在处理小文件时效率都非常低,但又难免面临处理大量小文件的场景,此时,就需要有相应解决方案。可以自定义 InputFormat 实现小文件的合并。
将多个小文件合并成一个 SequenceFile 文件(SequenceFile 文件是 Hadoop 用来存储二进制形式的 key-value 对的文件格式),SequenceFile 里面存储着多个文件,存储的形式为文件路径+名称为key,文件内容为 value。
自定义 ImputFormat 步骤:


(1)自定义一个类继承 FilelnputFormat。

(1.1)重写 isSplitable() 方法,返回 false 不可切割

(1.2)重写createRecordReader(),创建自定义的 RecordReader 对象,并初始化


(2)改写 RecordReader,实现一次读取一个完整文件封装为K-V。

(2.1)采用IO流一次读取一个文件输出到 value 中,因为设置了不可切片,最终把所有文件都封装到了 value 中

(2.2)获取文件路径信息 + 名称,并设置 key


(3)输入时使用自定义的 InputFormat,在输出时使用 SequenceFileOutPutFormat 输出合并文件。
自定义一个 InputFormat,将小文件合并为一个文件(SequenceFile)
1.测试数据
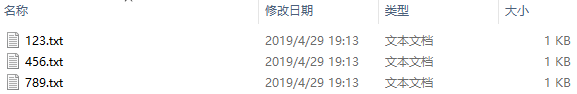
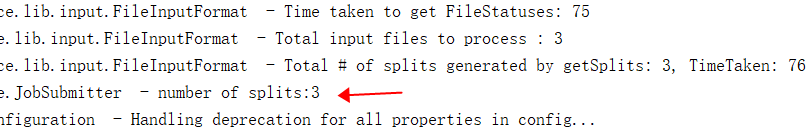
2.切片数,与 TextInputFormat 一样,按照文件大小进行切片
3.读取数据方式,查看 k-v 值,按照自定义的方式在读取
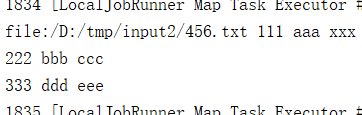
4.结果,大概可以看出是文件路径加上文件类容组成

5.测试代码
import org.apache.hadoop.conf.Configuration;

import org.apache.hadoop.fs.Path;

import org.apache.hadoop.io.BytesWritable;

import org.apache.hadoop.io.Text;

import org.apache.hadoop.mapreduce.Job;

import org.apache.hadoop.mapreduce.Mapper;

import org.apache.hadoop.mapreduce.Reducer;

import org.apache.hadoop.mapreduce.lib.input.FileInputFormat;

import org.apache.hadoop.mapreduce.lib.output.FileOutputFormat;

import org.apache.hadoop.mapreduce.lib.output.SequenceFileOutputFormat;

import org.apache.log4j.BasicConfigurator;

import java.io.IOException;

public class SequenceFileDriver {

    static {

        try {

            // 设置 HADOOP_HOME 环境变量

            System.setProperty("hadoop.home.dir", "D://DevelopTools/hadoop-2.9.2/");

            // 日志初始化

            BasicConfigurator.configure();

            // 加载库文件

            System.load("D://DevelopTools/hadoop-2.9.2/bin/hadoop.dll");

        } catch (UnsatisfiedLinkError e) {

            System.err.println("Native code library failed to load.\n" + e);

            System.exit(1);

        }

    }

    public static void main(String[] args) throws Exception, IOException {

        args = new String[]{"D:\\tmp\\input2", "D:\\tmp\\456"};

        // 1 获取job对象

        Configuration conf = new Configuration();

        Job job = Job.getInstance(conf);

        // 2 设置jar包存储位置、关联自定义的mapper和reducer

        job.setJarByClass(SequenceFileDriver.class);

        job.setMapperClass(SequenceFileMapper.class);

        job.setReducerClass(SequenceFileReducer.class);

        // 3 设置map输出端的kv类型

        job.setMapOutputKeyClass(Text.class);

        job.setMapOutputValueClass(BytesWritable.class);

        // 4 设置最终输出端的kv类型

        job.setOutputKeyClass(Text.class);

        job.setOutputValueClass(BytesWritable.class);

        // 5 设置输入输出路径

        FileInputFormat.setInputPaths(job, new Path(args[0]));

        FileOutputFormat.setOutputPath(job, new Path(args[1]));

        // 6 设置输入的inputFormat

        job.setInputFormatClass(WholeFileInputFormat.class);

        // 7 设置输出的outputFormat

        job.setOutputFormatClass(SequenceFileOutputFormat.class);

        // 8 提交job

        System.exit(job.waitForCompletion(true) ? 0 : 1);

    }

}

class SequenceFileMapper extends Mapper<Text, BytesWritable, Text, BytesWritable> {

    @Override

    protected void map(Text key, BytesWritable value, Context context) throws IOException, InterruptedException {

        // 查看 k-v

        System.out.println(key + "\t" + new String(value.getBytes()));

        context.write(key, value);

    }

}

class SequenceFileReducer extends Reducer<Text, BytesWritable, Text, BytesWritable> {

    @Override

    protected void reduce(Text key, Iterable<BytesWritable> values, Context context) throws IOException, InterruptedException {

        for (BytesWritable value : values) {

            context.write(key, value);

        }

    }

}
自定义的 InputFormat
import java.io.IOException;

import org.apache.hadoop.conf.Configuration;

import org.apache.hadoop.fs.FSDataInputStream;

import org.apache.hadoop.fs.FileSystem;

import org.apache.hadoop.fs.Path;

import org.apache.hadoop.io.BytesWritable;

import org.apache.hadoop.io.IOUtils;

import org.apache.hadoop.io.Text;

import org.apache.hadoop.mapreduce.InputSplit;

import org.apache.hadoop.mapreduce.RecordReader;

import org.apache.hadoop.mapreduce.TaskAttemptContext;

import org.apache.hadoop.mapreduce.lib.input.FileInputFormat;

import org.apache.hadoop.mapreduce.lib.input.FileSplit;

public class WholeFileInputFormat extends FileInputFormat<Text, BytesWritable>{

    @Override

    public RecordReader<Text, BytesWritable> createRecordReader(InputSplit split, TaskAttemptContext context) throws IOException, InterruptedException {

        WholeRecordReader recordReader = new WholeRecordReader();

        recordReader.initialize(split, context);

        return recordReader;

    }

}

class WholeRecordReader extends RecordReader<Text, BytesWritable>{

    FileSplit split;

    Configuration configuration;

    Text k = new Text();

    BytesWritable v = new BytesWritable();

    boolean isProgress = true;

    @Override

    public void initialize(InputSplit split, TaskAttemptContext context) throws IOException, InterruptedException {

        // 初始化

        this.split = (FileSplit) split;

        configuration = context.getConfiguration();

    }

    @Override

    public boolean nextKeyValue() throws IOException, InterruptedException {

        if (isProgress) {

            byte[] buf = new byte[(int) split.getLength()];

            // 1 获取fs对象

            Path path = split.getPath();

            FileSystem fs = path.getFileSystem(configuration);

            // 2 获取输入流

            FSDataInputStream fis = fs.open(path);

            // 3 拷贝

            IOUtils.readFully(fis, buf, 0, buf.length);

            // 4 封装v

            v.set(buf, 0, buf.length);

            // 5 封装k

            k.set(path.toString());

            // 6 关闭资源

            IOUtils.closeStream(fis);

            isProgress = false;

            return true;

        }

        return false;

    }

    @Override

    public Text getCurrentKey() throws IOException, InterruptedException {

        return k;

    }

    @Override

    public BytesWritable getCurrentValue() throws IOException, InterruptedException {

        return v;

    }

    @Override

    public float getProgress() throws IOException, InterruptedException {

        // 进度

        return 0;

    }

    @Override

    public void close() throws IOException {

        // 关闭资源

    }

}
生成的 part-r-00000 文件就是合并后的 SequenceFile 文件
https://hadoop.apache.org/docs/current/api/org/apache/hadoop/io/SequenceFile.html
https://wiki.apache.org/hadoop/SequenceFile
MapReduce-自定义 InputFormat 生成 SequenceFile的更多相关文章
- 【Hadoop离线基础总结】MapReduce自定义InputFormat和OutputFormat案例
MapReduce自定义InputFormat和OutputFormat案例 自定义InputFormat 合并小文件 需求 无论hdfs还是mapreduce,存放小文件会占用元数据信息,白白浪费内 ...
- MapReduce自定义InputFormat和OutputFormat
一.自定义InputFormat 需求:将多个小文件合并为SequenceFile(存储了多个小文件) 存储格式:文件路径+文件的内容 c:/a.txt I love Beijing c:/b.txt ...
- MapReduce自定义InputFormat,RecordReader
MapReduce默认的InputFormat是TextInputFormat,且key是偏移量,value是文本,自定义InputFormat需要实现FileInputFormat,并重写creat ...
- MapReduce之自定义InputFormat
在企业开发中,Hadoop框架自带的InputFormat类型不能满足所有应用场景,需要自定义InputFormat来解决实际问题. 自定义InputFormat步骤如下: (1)自定义一个类继承Fi ...
- MapReduce框架原理-InputFormat数据输入
InputFormat简介 InputFormat:管控MR程序文件输入到Mapper阶段,主要做两项操作:怎么去切片?怎么将切片数据转换成键值对数据. InputFormat是一个抽象类,没有实现怎 ...
- 自定义InputFormat和OutputFormat案例
一.自定义InputFormat InputFormat是输入流,在前面的例子中使用的是文件输入输出流FileInputFormat和FileOutputFormat,而FileInputFormat ...
- Hadoop案例(六)小文件处理(自定义InputFormat)
小文件处理(自定义InputFormat) 1.需求分析 无论hdfs还是mapreduce,对于小文件都有损效率,实践中,又难免面临处理大量小文件的场景,此时,就需要有相应解决方案.将多个小文件合并 ...
- 自定义inputformat和outputformat
1. 自定义inputFormat 1.1 需求 无论hdfs还是mapreduce,对于小文件都有损效率,实践中,又难免面临处理大量小文件的场景,此时,就需要有相应解决方案 1.2 分析 小文件的优 ...
- Hadoop_28_MapReduce_自定义 inputFormat
1. 自定义inputFormat 1.1.需求: 无论hdfs还是mapreduce,对于小文件都有损效率,实践中,又难免面临处理大量小文件,此时就需要有相应解决方案; 1.2.分析: 小文件的优化 ...
随机推荐
- Mybatis-Spring包学习
MyBatis-Spring包用来将MyBatis无缝整合到Spring中.使用这个类库中的类, Spring将会加载必要的MyBatis工厂类和Session类. 这个类库也提供一个简单的方式来注入 ...
- L2-005. 集合相似度(set使用)
L2-005. 集合相似度 时间限制 400 ms 内存限制 65536 kB 代码长度限制 8000 B 判题程序 Standard 作者 陈越 给定两个整数集合,它们的相似度定义为:Nc/Nt*1 ...
- 数据库连接池在Tomcat中的几种配置方法
数据库连接是一种关键的有限的昂贵的资源,这在多用户网页应用程序中体现的尤为突出.对数据库连接的管理能显著影响到整个应用程序的伸缩性和健壮性,影响到程序的性能指标,数据库连接池正是针对这个问题提出的. ...
- 10-23C#基础--结构体
结构体: 1.定义:封装小型相关变量组,里面可以放一系列的变量: 就是一个变量组,将一组变量放在一起,结构体一般定义在Main函数上面,位于Class下面,作为一个类:一般情况Struct定义在Mai ...
- leetcode559
class Solution { public: int maxDepth(Node* root) { ; if (root != NULL) { queue<Node> Q; Q.pus ...
- 推荐一款GIF录制工具
LICEcap 是一款屏幕录制工具,支持导出 GIF 动画图片格式,轻量级.使用简单,录制过程中可以随意改变录屏范围 下载 http://www.cockos.com/licecap/
- DAY17-认证系统
COOKIE 与 SESSION 概念 cookie不属于http协议范围,由于http协议无法保持状态,但实际情况,我们却又需要“保持状态”,因此cookie就是在这样一个场景下诞生. cookie ...
- EF事务封装
public class EFTransaction:ITransaction { DbContextTransaction originalTransaction = null; MyDbConte ...
- LaTeX数学公式基础
LaTeX数学公式 参考:https://www.cnblogs.com/Sinte-Beuve/p/6160905.html 原博客显示有点问题,重新搬运整理LaTeX数学公式部分的基本用法 基础 ...
- 【263】Linux 添加环境变量 & 全局 shell 脚本
Linux电脑添加环境变量 方法一:通过修改 profile 文件添加环境变量 1. 打开终端,输入[vi /etc/profile],如下所示,点击回车 [ocean@ygs-jhyang-w1 L ...