
spark中的RDD以及DAG
今天,我们就先聊一下spark中的DAG以及RDD的相关的内容
1.DAG:有向无环图:有方向,无闭环,代表着数据的流向,这个DAG的边界则是Action方法的执行
2.如何将DAG切分stage,stage切分的依据:有宽依赖的时候要进行切分(shuffle的时候,
也就是数据有网络的传递的时候),则一个wordCount有两个stage,
一个是reduceByKey之前的,一个事reduceByKey之后的(图1),
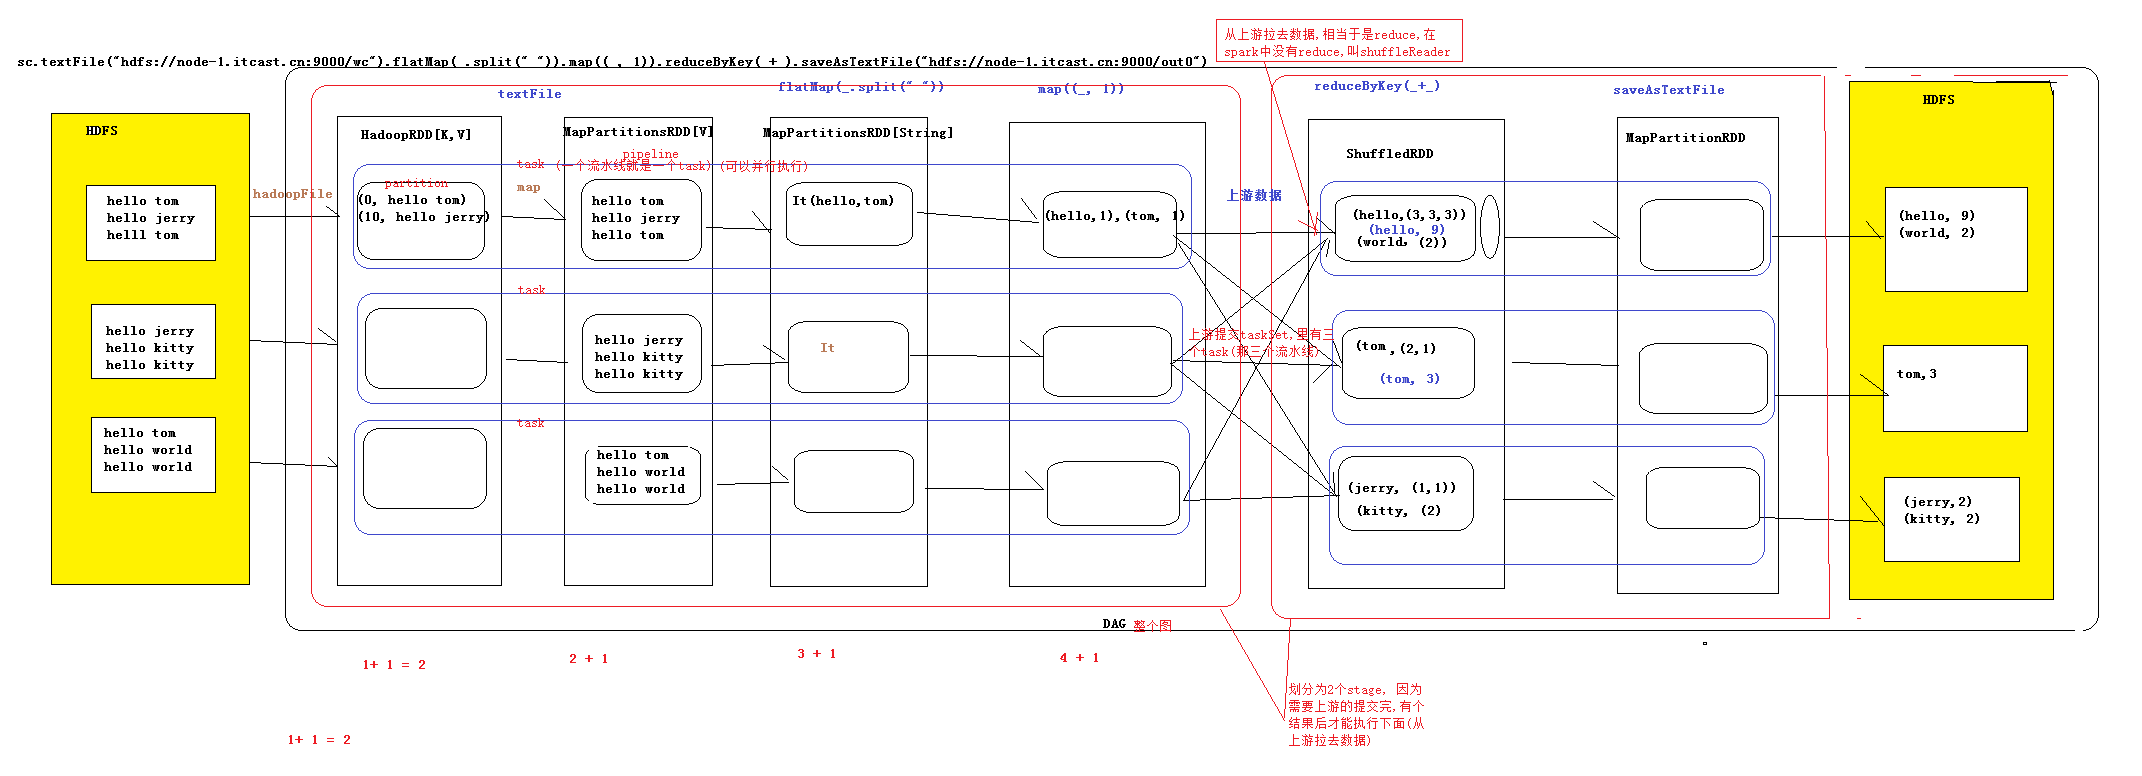
则我们可以这样的理解,当我们要进行提交上游的数据的时候,
此时我们可以认为提交的stage,但是严格意义上来讲,我们提交的是Task
sets(Task的集合),这些Task可能业务逻辑相同,就是处理的数据不同
3.流程
构建RDD形成DAG遇到Action的时候,前面的stage先提交,提交完成之后再交给
下游的数据,在遇到TaskScheduler,这个时候当我们遇到Action的方法的时候,我们
就会让Master决定让哪些Worker来执行这个调度,但是到了最后我们真正的传递的
时候,我们用的是Driver给Worker传递数据(其实是传递到Excutor里面,这个里面执行
真正的业务逻辑),Worker中的Excutor只要启动,则此后就和Master没有多大关系了
4.宽窄依赖
RDD和它依赖的父RDD(s)的关系有两种不同的类型,即窄依赖(narrow dependency)以及
宽依赖(wide dependency).

窄分区的划分依据,如果后面的一个RDD,前面的一个RDD有一个唯一对应的RDD,
则此时就是窄依赖,就相当于一次函数,y对应于一个x,而宽依赖则是类似于,前面的
一个RDD,则此时一个RDD对应多个RDD,就相当于二次函数,一个y对应多个x的值
5.DAG的生成
DAG(Directed Acyclic Graph)叫做有向无环图,原始的RDD通过一系列的转换就形成
DAG,根据RDD的之间的依赖关系的不同将DAG划分为不同的stage,对于窄依赖,
partition的转换处理在stage中完成计算,对于宽依赖,由于有shuffle的存在,只能在
partentRDD处理完成后,才能开始接下来的计算,因此宽依赖是划分stage的依据
一般我们认为join是宽依赖,但是对于已经分好区的join来说,我们此时可以认为这个
时候的join是窄依赖
spark中的RDD以及DAG的更多相关文章
- spark 中的RDD编程 -以下基于Java api
1.RDD介绍: RDD,弹性分布式数据集,即分布式的元素集合.在spark中,对所有数据的操作不外乎是创建RDD.转化已有的RDD以及调用RDD操作进行求值.在这一切的背后,Spark会自动 ...
- Spark中的RDD和DataFrame
什么是DataFrame 在Spark中,DataFrame是一种以RDD为基础的分布式数据集,类似于传统数据库中的二维表格. RDD和DataFrame的区别 DataFrame与RDD的主要区别在 ...
- 浅谈大数据神器Spark中的RDD
1.究竟什么是RDD呢? 有人可能会回答是:Resilient Distributed Dataset.没错,的确是如此.但是我们问这个实际上是想知道RDD到底是个什么东西?以及它到底能干嘛?好的,有 ...
- Spark中的RDD操作简介
map(func) 对数据集中的元素逐一处理,变为新的元素,但一个输入元素只能有一个输出元素 scala> pairData.collect() res6: Array[Int] = Array ...
- Spark 核心概念 RDD 详解
RDD全称叫做弹性分布式数据集(Resilient Distributed Datasets),它是一种分布式的内存抽象,表示一个只读的记录分区的集合,它只能通过其他RDD转换而创建,为此,RDD支持 ...
- Spark 核心概念RDD
文章正文 RDD全称叫做弹性分布式数据集(Resilient Distributed Datasets),它是一种分布式的内存抽象,表示一个只读的记录分区的集合,它只能通过其他RDD转换而创建,为此, ...
- Spark学习之RDD编程总结
Spark 对数据的核心抽象——弹性分布式数据集(Resilient Distributed Dataset,简称 RDD).RDD 其实就是分布式的元素集合.在 Spark 中,对数据的所有操作不外 ...
- Spark学习笔记——RDD编程
1.RDD——弹性分布式数据集(Resilient Distributed Dataset) RDD是一个分布式的元素集合,在Spark中,对数据的操作就是创建RDD.转换已有的RDD和调用RDD操作 ...
- Spark学习之RDD编程(2)
Spark学习之RDD编程(2) 1. Spark中的RDD是一个不可变的分布式对象集合. 2. 在Spark中数据的操作不外乎创建RDD.转化已有的RDD以及调用RDD操作进行求值. 3. 创建RD ...
随机推荐
- Design Pattern ->Adaptor
Layering & Contract Philosophy With additional indirection Adaptee object just is as a member. A ...
- Movideo SaaS解决方案
类型: 定制服务 软件包: media solution collateral 联系服务商 产品详情 解决方案 概要 Movideo为媒体客户提供的SaaS解决方案部署在位于全球数据中心的Azure云 ...
- android三大组件之Intent
Android 应用程序中有三大核心组件: Activity, Service, Broadcast Receiver 都是通过被称之为意图的消息运行. Intent messaging is a f ...
- ajax异步请求的使用情景
先上代码 var sysAllowedExts; $.ajax({ url: url+"/getExtSetting", //请求的url地址 dataType: "js ...
- 运用Hadoop能否搭建完整的云计算平台?
Apache Hadoop 是一个用java语言实现的软件框架,在由大量计算机组成的集群中运行海量数据的分布式计算,它可以让应用程序支持上千个节点和PB级别的数据. Hadoop并不完全代表云计算,所 ...
- POJ-3349 Snowflake Snow Snowflakes---最小表示法
题目链接: https://vjudge.net/problem/POJ-3349 题目大意: 每个雪花都有六个分支,用六个整数代表,这六个整数是从任意一个分支开始,朝顺时针或逆时针方向遍历得到的.输 ...
- stixel-world代码解读
下边缘的求法应该是使用的第二篇论文的方法 上边缘的求法应该是使用的第一篇论文的方法 这是求上边缘的代码: std::vector<float> integralMembership(vma ...
- Android笔记(adb命令--reboot loader)
Android 的机器通过adb进入升级模式的方法 # adb shell # reboot loader 通过上面两个命令就进入升级模式了,通过工具升级就好了 为什么会写这简单的一篇呢?因为今天干了 ...
- 第41章 RS-485通讯实验—零死角玩转STM32-F429系列
第41章 RS-485通讯实验 全套200集视频教程和1000页PDF教程请到秉火论坛下载:www.firebbs.cn 野火视频教程优酷观看网址:http://i.youku.com/fir ...
- element el-tooltip 内容换行的方法
<el-tooltip class="item" effect="light" placement="top-start"> ...